
Breve: el problema no es el idioma, sino la escritura
Los filtros de seguridad de los grandes modelos de lenguaje suelen evaluarse en inglés. De ahí nace una ilusión conveniente: si el modelo detecta con solidez insultos y llamados a la violencia en texto inglés, se supone que hará algo parecido con otros idiomas. El urdu —una lengua con aproximadamente 246 millones de hablantes, la décima del mundo por ese criterio— casi nunca entra en ese tipo de pruebas. Y ese vacío, como se verá, tiene un costo medible.
De eso trata un trabajo reciente con identificador arXiv:2608.24191. El título «Ghaib in Translation» juega con la palabra ghaib, que en urdu significa «oculto, invisible»: se habla del daño que pasa desapercibido. Los autores son Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla y Stephen Swift. La primera versión apareció el 25 de agosto de 2026 y la revisión actualizada, el 9 de septiembre del mismo año; el artículo pertenece a las áreas cs.CL y cs.AI, DOI: 10.48550/arXiv.2608.24191.
Cómo está diseñado el experimento
Modelos y datos
El equipo sometió cinco modelos populares al mismo escenario de clasificación: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 y Llama-3.1. El conjunto de datos son seis datasets que cubren cuatro formas distintas de existencia de la lengua: urdu en escritura nastaliq, urdu en alfabeto latino (romanizado), inglés y textos mixtos urdu-inglés, donde los idiomas se alternan dentro de un mismo mensaje.
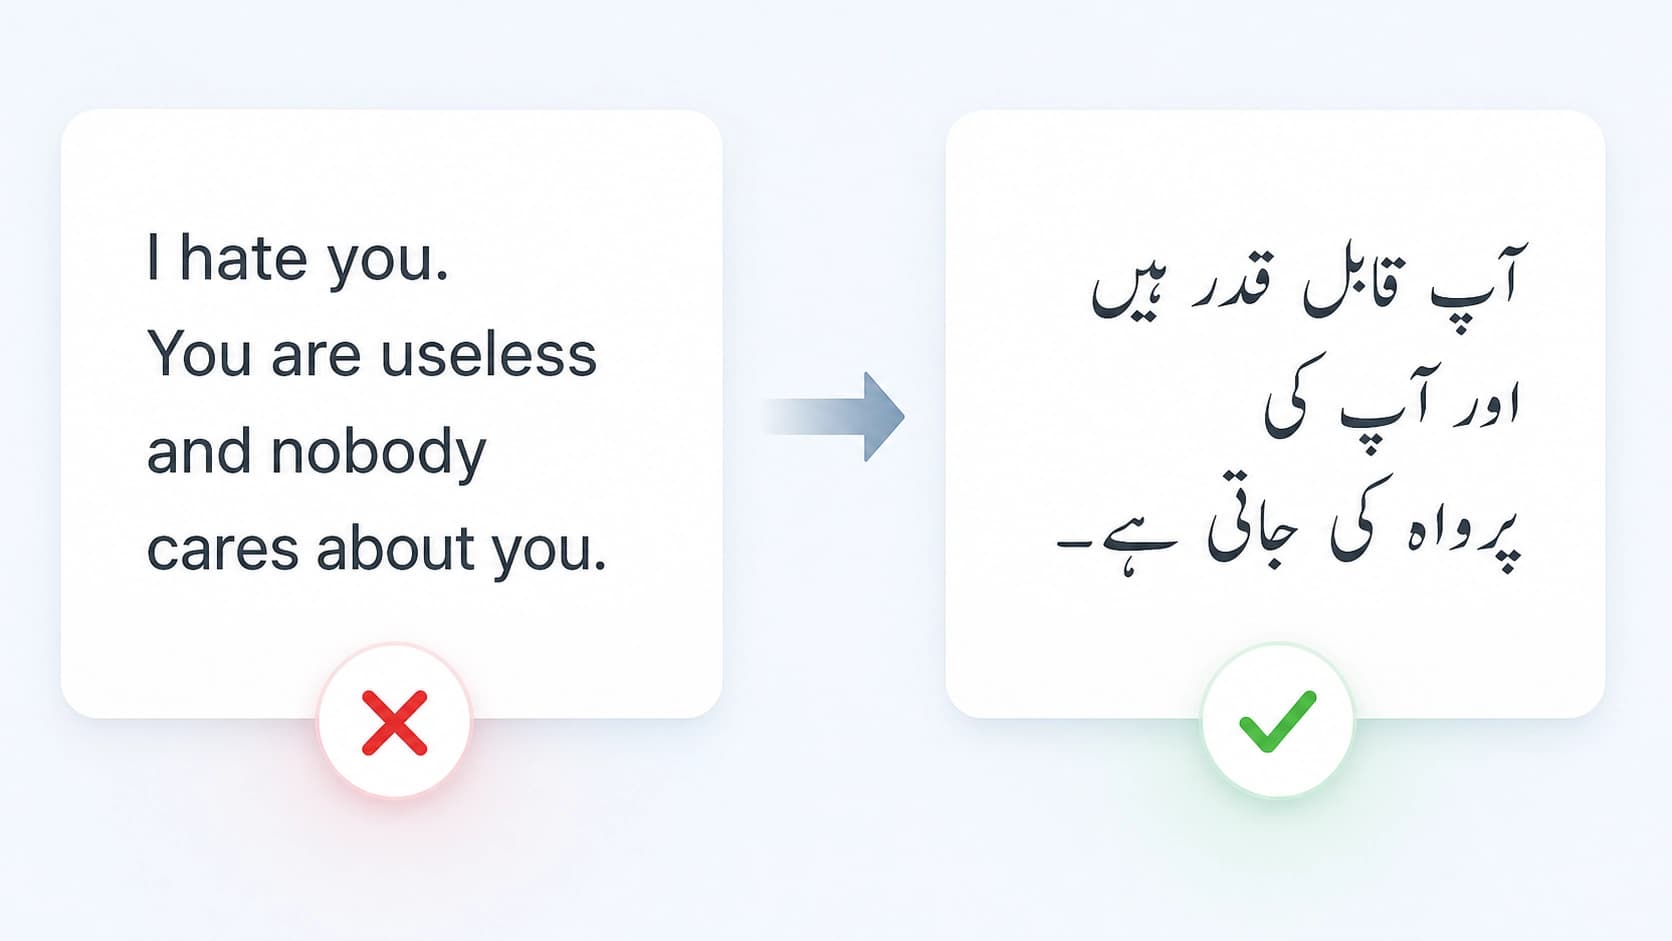
Un detalle importante: no se evaluaba tanto la calidad en sí como la estabilidad de la decisión. El mismo significado se presentaba al modelo dos veces: en el script original y en su traducción al inglés. Si el filtro se activa solo en el segundo caso, significa que la protección no está ligada al contenido, sino a con qué letras está escrito.
Dos métricas
Los autores manejan dos indicadores simples. El primero es la tasa de discrepancias: con qué frecuencia cambia la etiqueta entre el original y la traducción. El segundo recibió el nombre de «Missed-in-Urdu»: es el contenido que en la versión en inglés se consideró dañino, pero que en el script original pasó como inofensivo. En esencia, es un fallo puro y duro: justo aquello para lo que existe la moderación.
Qué mostraron las cifras
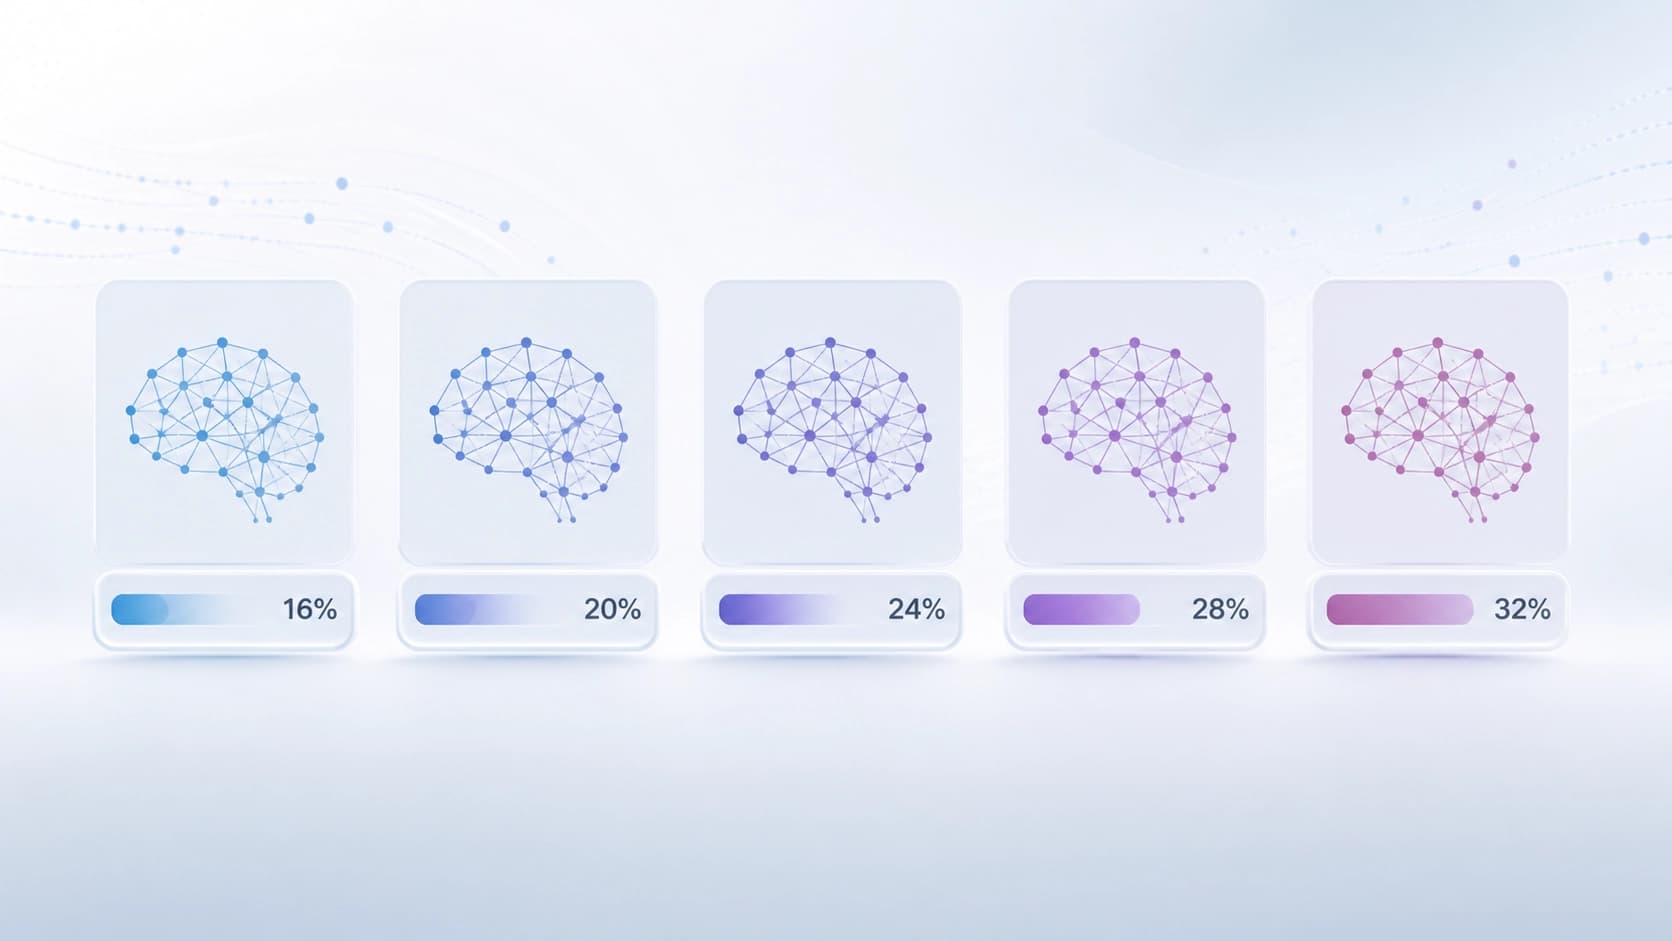
En los cinco datasets donde el texto estaba escrito precisamente en script urdu, la dispersión de resultados entre la clasificación en el original y en la traducción fue de entre el 15,9% y el 31,6%. El mejor resultado fue el de Gemini 2.5 Flash, y el peor, el de Qwen-2.5. En otras palabras, en el caso más desafortunado aproximadamente una de cada tres decisiones del filtro dependía de en qué alfabeto se presentara el mismo texto.
La proporción de daño omitido fue de entre el 2,4% y el 9,9%, con una mediana del 4,3%. A primera vista parece poco, pero conviene traducirlo a escala humana: si una plataforma con una audiencia de millones de usuarios procesa decenas de miles de mensajes al día, incluso un 4% son cientos de unidades de contenido tóxico diarias que se cuelan. Y no se trata de casos límite como el sarcasmo, sino de material que el mismo modelo marca con seguridad como dañino en cuanto se traduce.
El patrón general que registran los autores: cuanto más pequeño y abierto es el modelo, más se deterioran ambas métricas. Los sistemas cerrados de gama alta se mantienen más estables, pero incluso en ellos la brecha no es cero.
Nueve años de literatura — y ni un solo trabajo
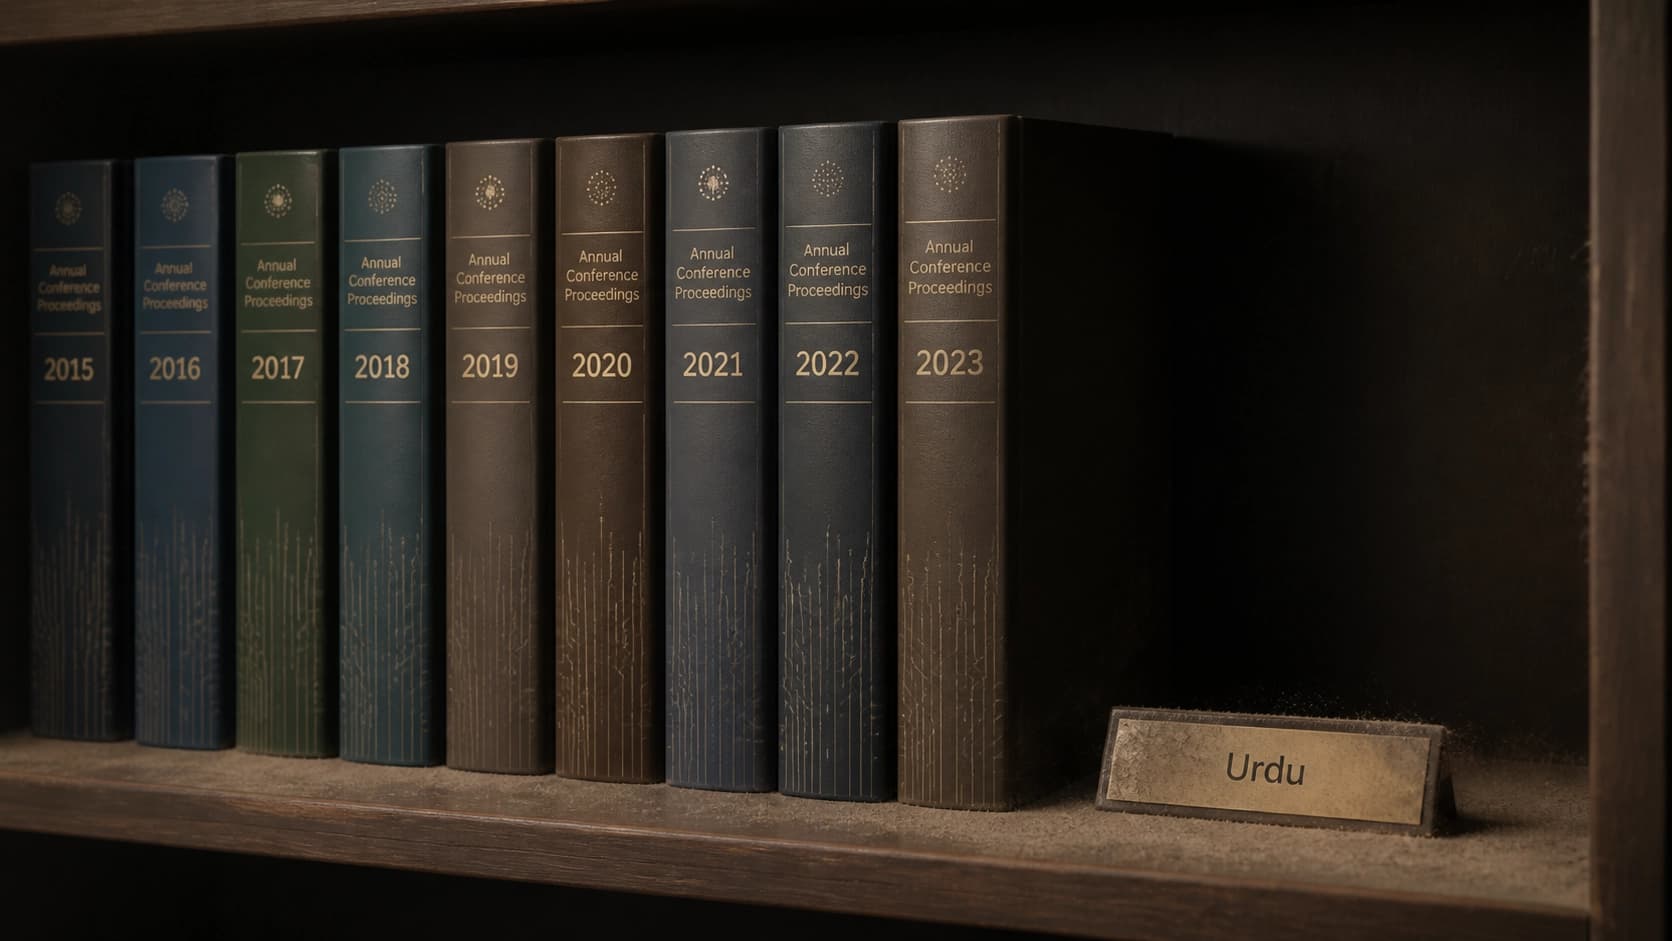
Una línea de investigación aparte es la bibliográfica. Los autores recorrieron a través de la API de ACL Anthology los 205 artículos de nueve ediciones de ALW/WOAH y no encontraron ninguno dedicado al urdu específicamente. Esto no significa que el tema no se haya estudiado en absoluto, pero en el corpus de materiales del principal workshop sobre evaluación de daño no existe como línea propia. Se forma un círculo vicioso: no hay benchmarks — no hay publicaciones — no hay presión sobre los desarrolladores — de nuevo no hay benchmarks.
Por qué ocurre esto
La respuesta exacta no está en el artículo, pero la mecánica se entiende a partir de consideraciones generales. El nastaliq es una escritura cursiva, donde la forma de la letra depende de su posición en la palabra, lo que significa que los tokenizadores configurados para el alfabeto latino cortan ese texto en fragmentos desfavorables. Los datos en urdu en los corpus de entrenamiento son órdenes de magnitud menores que en inglés. El etiquetado para el aprendizaje por refuerzo (incluida la seguridad) también se recopila predominantemente por hablantes nativos de inglés. Además, existe un compromiso cómodo: traducir la entrada al inglés, pasar la verificación y devolver la respuesta. Ahorra recursos, pero añade un intermediario que es precisamente lo que genera la discrepancia.
Qué hacer al respecto en los equipos de producto
- No confiar en la traducción como proxy. Si el filtro decide a partir de la versión en inglés, la diferencia hay que medirla, no silenciarla.
- Convertir la discrepancia en una métrica. Es útil calcular con regularidad cuántas decisiones cambian al cambiar de script: es una forma barata de encontrar puntos ciegos sin nuevo etiquetado.
- Probar en la escritura original. Nastaliq, romanizado y code-switching son tres modos distintos, y los buenos resultados en uno no garantizan nada en los otros dos.
- No ajustar los umbrales a ciegas. Aumentar la sensibilidad en un script se convierte fácilmente en una avalancha de falsos positivos en otro.
- Tener en cuenta a la audiencia. 246 millones de hablantes no son un idioma de nicho, sino una porción notable de los usuarios de cualquier plataforma grande.
La conclusión a la que llevan los autores suena seca, pero va al grano: hoy las garantías de seguridad están distribuidas de forma desigual entre las escrituras. Mientras siga siendo así, «el modelo pasó las pruebas de seguridad» es una afirmación que siempre conviene matizar: en qué idioma y con qué letras se escribieron esas pruebas.


