
Breve: qué se publicó exactamente
A finales de agosto de 2026, el equipo de LAION publicó LAION-BVD, un corpus de vídeo abierto que en el preprint se describe como un conjunto de datos de escala sin precedentes para el entrenamiento multimodal. El trabajo apareció en arXiv el 25 de agosto de 2026, en las categorías de visión por computador, inteligencia artificial y aprendizaje automático.
Los números fríos son estos:
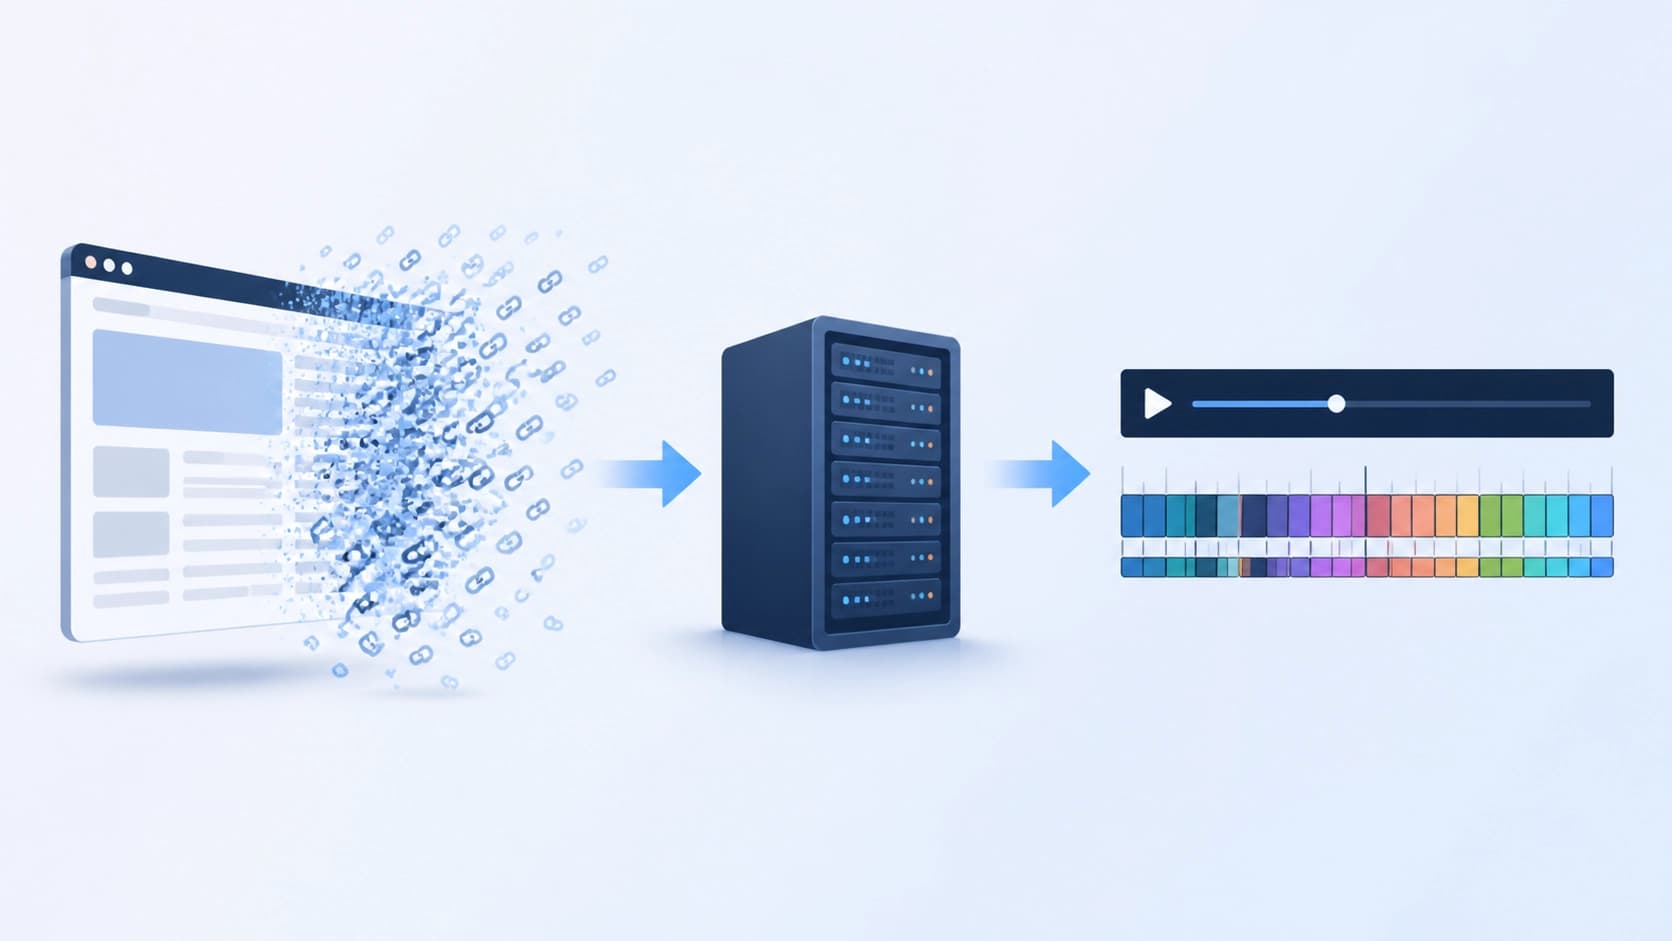
- 1,3 mil millones de enlaces a vídeos: el punto de partida de la recopilación, enlaces extraídos del rastreo web de CommonCrawl y vinculados a plataformas concretas;
- 80 millones de clips descargados realmente a través de esos enlaces: no todo lo que apareció en el índice llegó a descargarse;
- 10 millones de horas de duración total.
La última cifra cuesta asimilarla: es más de mil años de visionado continuo. Por eso el lanzamiento se describe como un cambio en lo que está disponible para los investigadores sin un presupuesto corporativo; antes, los corpus de vídeo de volumen comparable se quedaban dentro de laboratorios cerrados.
Cómo se ha construido
De los enlaces a los clips listos
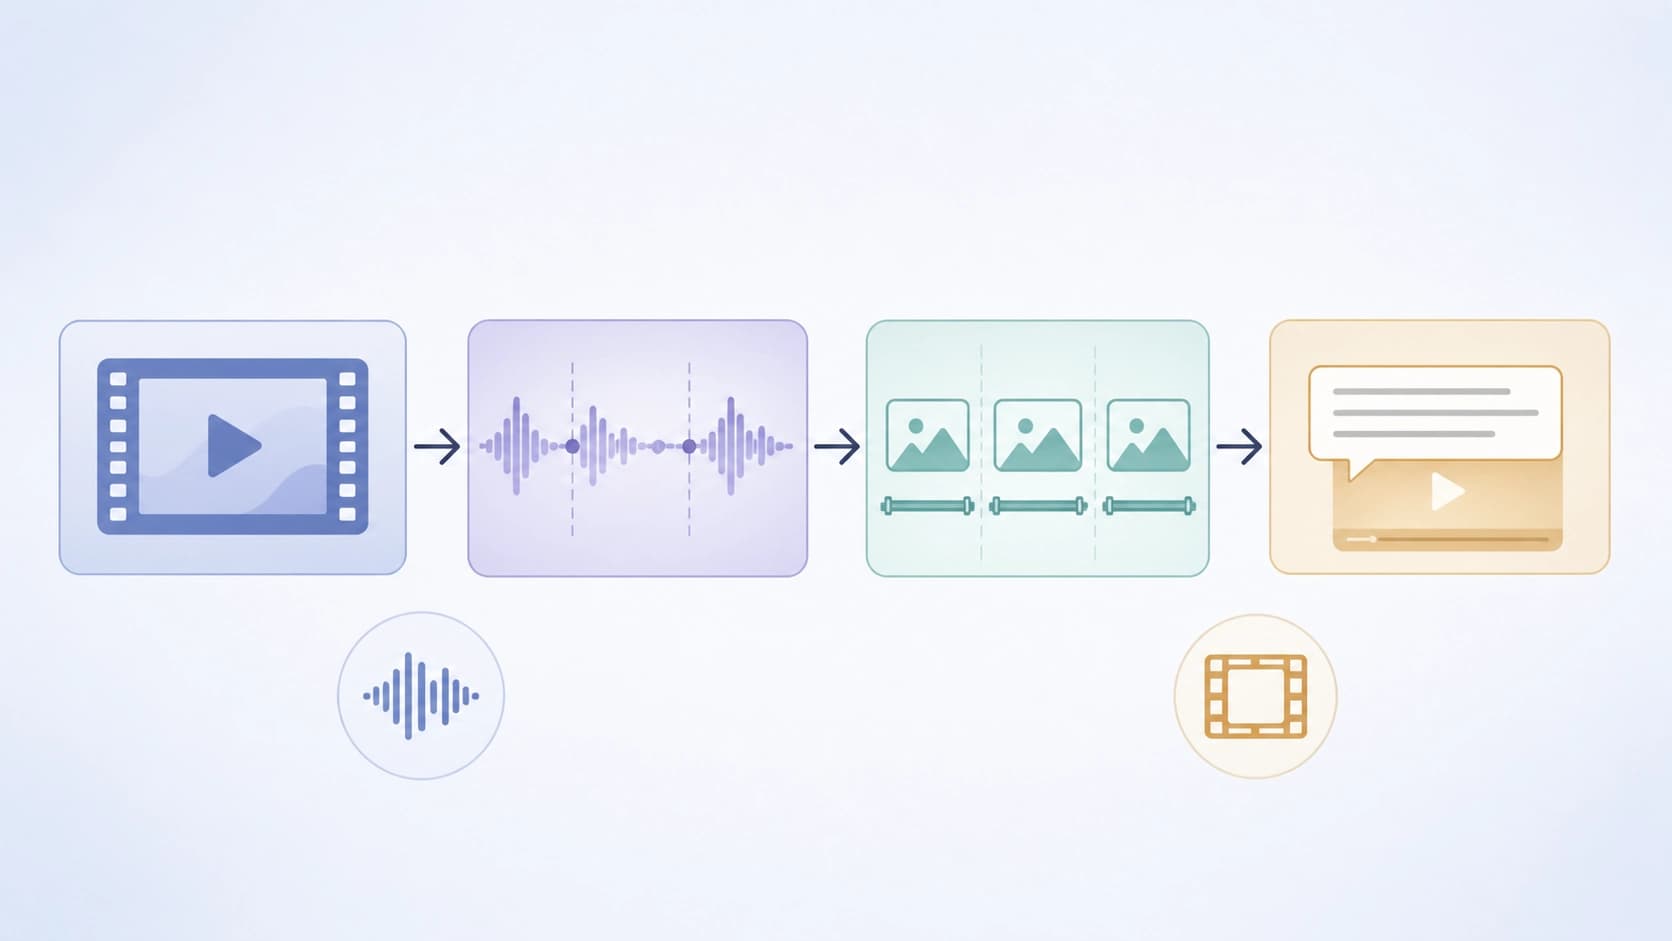
El pipeline consta de varias etapas, y cada una importa a su manera. Primero se seleccionan los enlaces y se normalizan. Después empieza la descarga masiva. Luego entra en juego la detección de escenas sensible al contenido del fotograma: un vídeo largo no se corta por un timecode fijo, sino por los cortes reales de montaje.
Después viene lo más interesante. Para los clips obtenidos, las descripciones se generan de forma sintética, automática y en dos modalidades a la vez: un par textual para el vídeo y otro aparte para la pista de audio. Es decir, el audio aquí no es un producto secundario, sino una señal de entrenamiento plena.
La construcción final está orientada al preentrenamiento con tres tipos de datos a la vez: vídeo, audio e imágenes.
Los fotogramas como recurso aparte
Los autores no se limitaron a los clips. De las escenas se extraen fotogramas correspondientes al momento del cambio y se presentan como una fuente independiente de pares «imagen — texto». La lógica es simple: el vídeo ofrece un corte distinto del mundo visual que las colecciones web habituales de imágenes, con otra distribución de temas, ángulos y detalles cotidianos. Para tareas de búsqueda por imagen, este desplazamiento de la distribución puede resultar más útil que otro millón de fotografías de las mismas fuentes de siempre.
Qué mostraron los experimentos
Vídeo y sonido
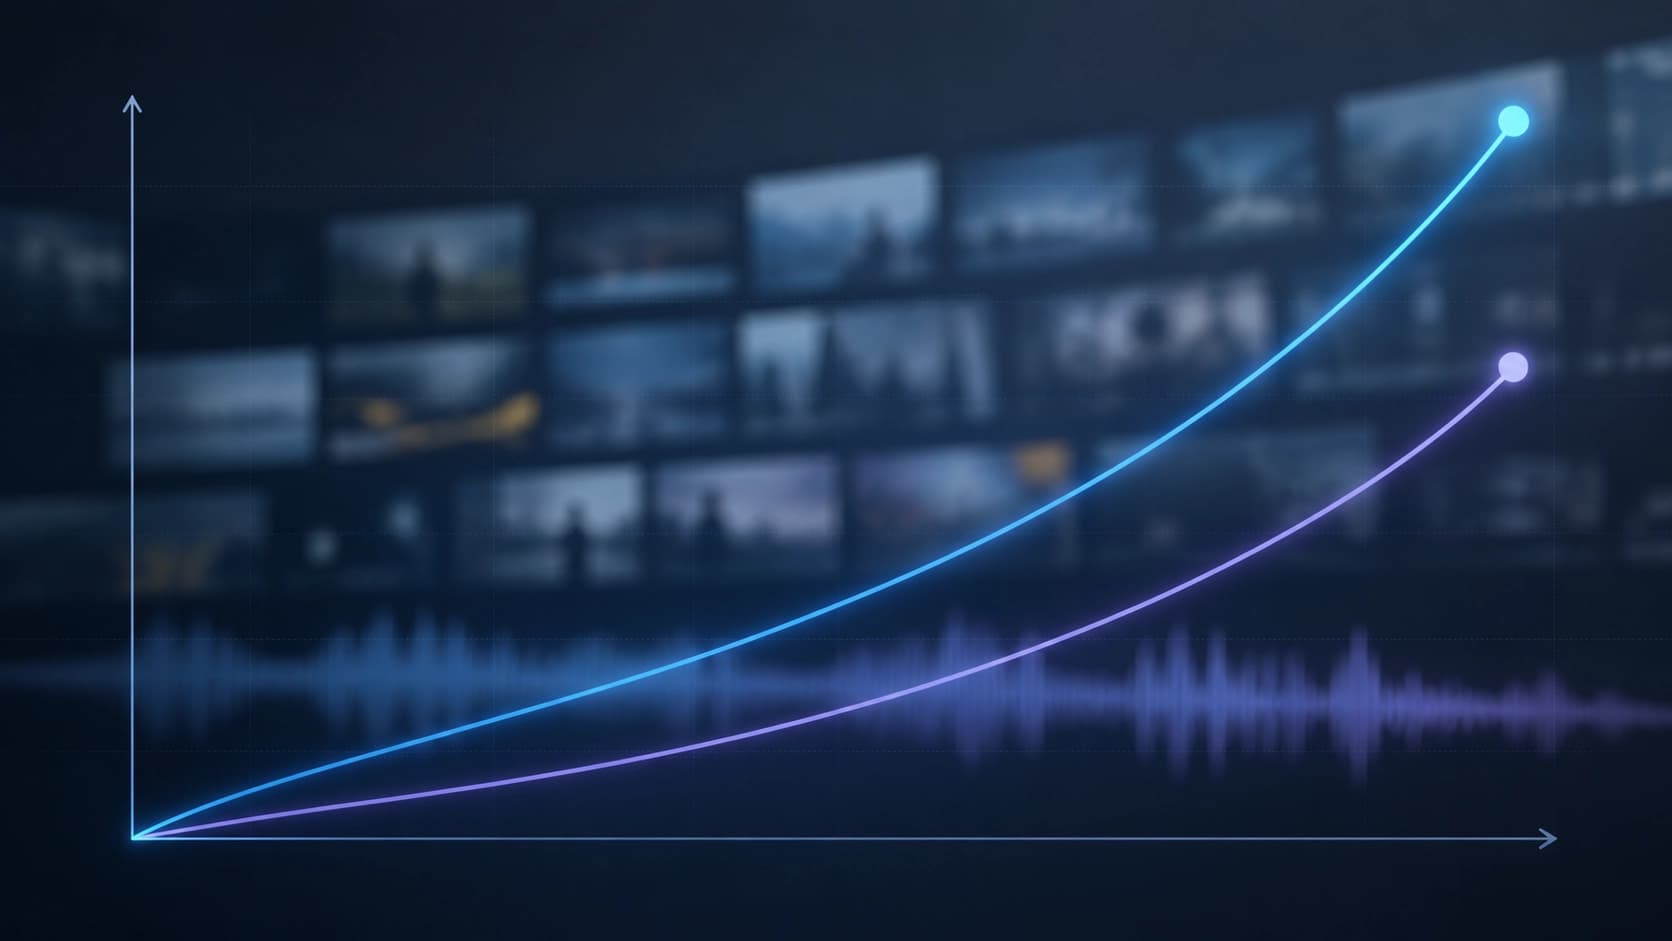
Los modelos entrenados con el nuevo corpus alcanzan un nivel competitivo en los benchmarks estándar de la pareja «vídeo — texto» y «audio — texto». Más importante es otra cosa: al aumentar el volumen de datos o el tamaño del modelo, la calidad crece de forma sostenida. Es justo la señal que distingue un dataset que «es simplemente grande» de uno que merece la pena seguir escalando.
Imágenes
Una línea aparte de experimentos es el entrenamiento con los fotogramas extraídos. Aquí el resultado también es positivo: buenos indicadores en búsqueda por imagen. Y eso a pesar de que la distribución de los fotogramas difiere notablemente de los corpus web habituales; es decir, la ganancia no viene del volumen en sí, sino del carácter distinto de los datos visuales.
Qué conviene tener en cuenta
- Las descripciones son sintéticas: ahorran miles de horas de trabajo humano, pero introducen ruido y errores sistemáticos. La calidad del filtrado aquí importa más que el tamaño del corpus.
- La recopilación parte de enlaces web, así que surgen las cuestiones habituales en este tipo de proyectos: la durabilidad de los enlaces, las condiciones de uso de las fuentes, la atribución. Una licencia abierta del dataset no elimina las preguntas sobre los materiales originales.
- El corpus se presenta como un lanzamiento de investigación; en la práctica, eso significa que el umbral de entrada es más bajo que el de los conjuntos corporativos internos, pero la reproducibilidad de resultados ajenos habrá que verificarla igualmente con las propias manos.
Por qué es importante
Hasta ahora, el vídeo multimodal abierto en semejante volumen era más una promesa que una realidad: los conjuntos académicos se medían en miles de horas, y todo lo que se medía en millones pertenecía a empresas y no salía al exterior. LAION-BVD cambia esa aritmética, y con ella el listón para quienes construyen sus propios modelos.
Las consecuencias prácticas son varias. En primer lugar, aparece una base para comparaciones honestas: si todos entrenan con el mismo corpus abierto, las discusiones sobre quién obtiene mejores resultados se vuelven más sustanciosas. En segundo lugar, los equipos pequeños y las universidades tienen una alternativa al alquiler de embeddings ajenos: pueden entrenar lo suyo. En tercer lugar, el audio deja de ser un apéndice del vídeo y obtiene su propia línea de entrenamiento.
La pregunta principal ahora no es si habrá suficientes datos, sino quién aprenderá primero a limpiarlos. Las descripciones sintéticas, decenas de millones de clips y la inevitable basura en la muestra convierten el filtrado y la evaluación de la calidad en el cuello de botella de todo el proyecto. El dataset está abierto; a partir de aquí, todo depende de la comunidad.


