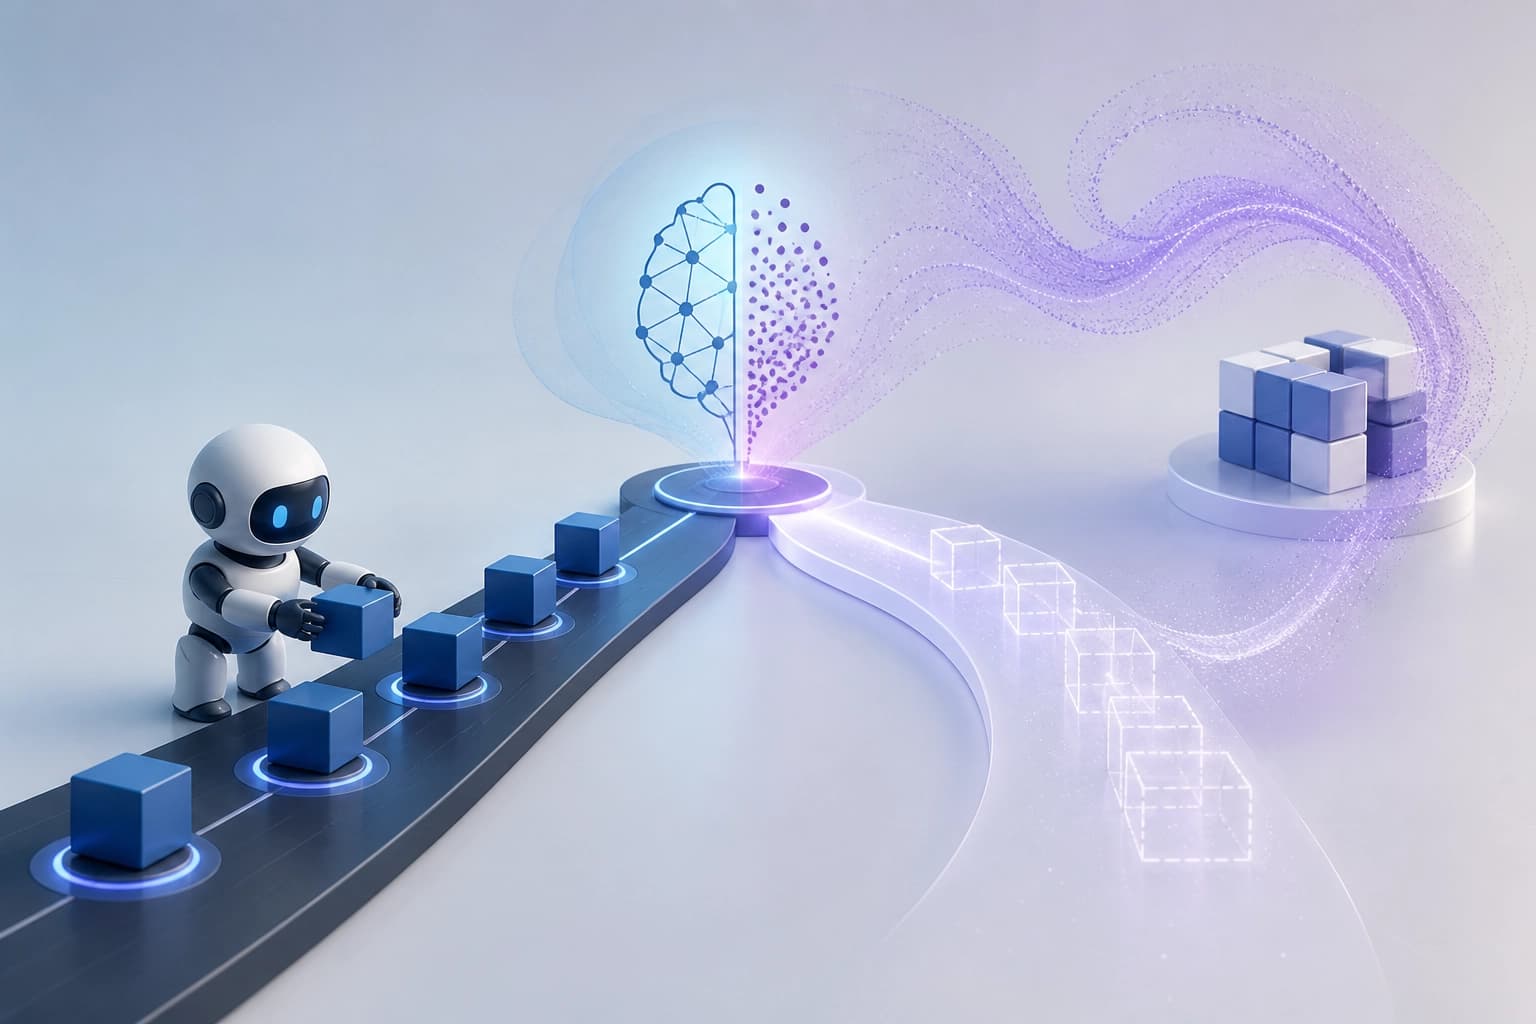
Суть HyCO
HyCO — Hybrid Neural Solver for Combinatorial Optimization. El método construye un prefijo de solución mediante un solucionador RL. Luego cambia de forma adaptativa a un modelo de difusión condicional. Este completa las soluciones restantes. El híbrido resuelve tareas de optimización combinatoria neuronal. Su objetivo es combinar los puntos fuertes de dos clases de solucionadores.
El trabajo está disponible como arXiv:2609.07990. Autores: Yuheng Li, Di Yang, Haipeng Chen, Yanhai Xiong. El preprint pertenece a cs.LG y cs.AI. Los autores enviaron la versión v1 el 7 Sep 2026. Estos datos ayudan a encontrar la fuente original y verificar los detalles.
Sentido práctico: HyCO no sustituye un solucionador por otro, sino que gestiona la transición entre ellos.
Dónde fallan las estrategias individuales
Los solucionadores RL secuenciales y los solucionadores DM globales muestran modos de fallo complementarios. Esto se observa en el regret de optimización.
| Clase de solucionador | Punto fuerte | Punto débil |
|---|---|---|
| Sequential RL | Pequeño regret marginal en la etapa temprana de construcción | Los errores se acumulan a lo largo del horizonte; el regret crece de forma supralineal |
| Global DM | Evita la acumulación a lo largo del horizonte | Regret lineal o sublineal respecto a la dimensionalidad del subespacio no resuelto restante |
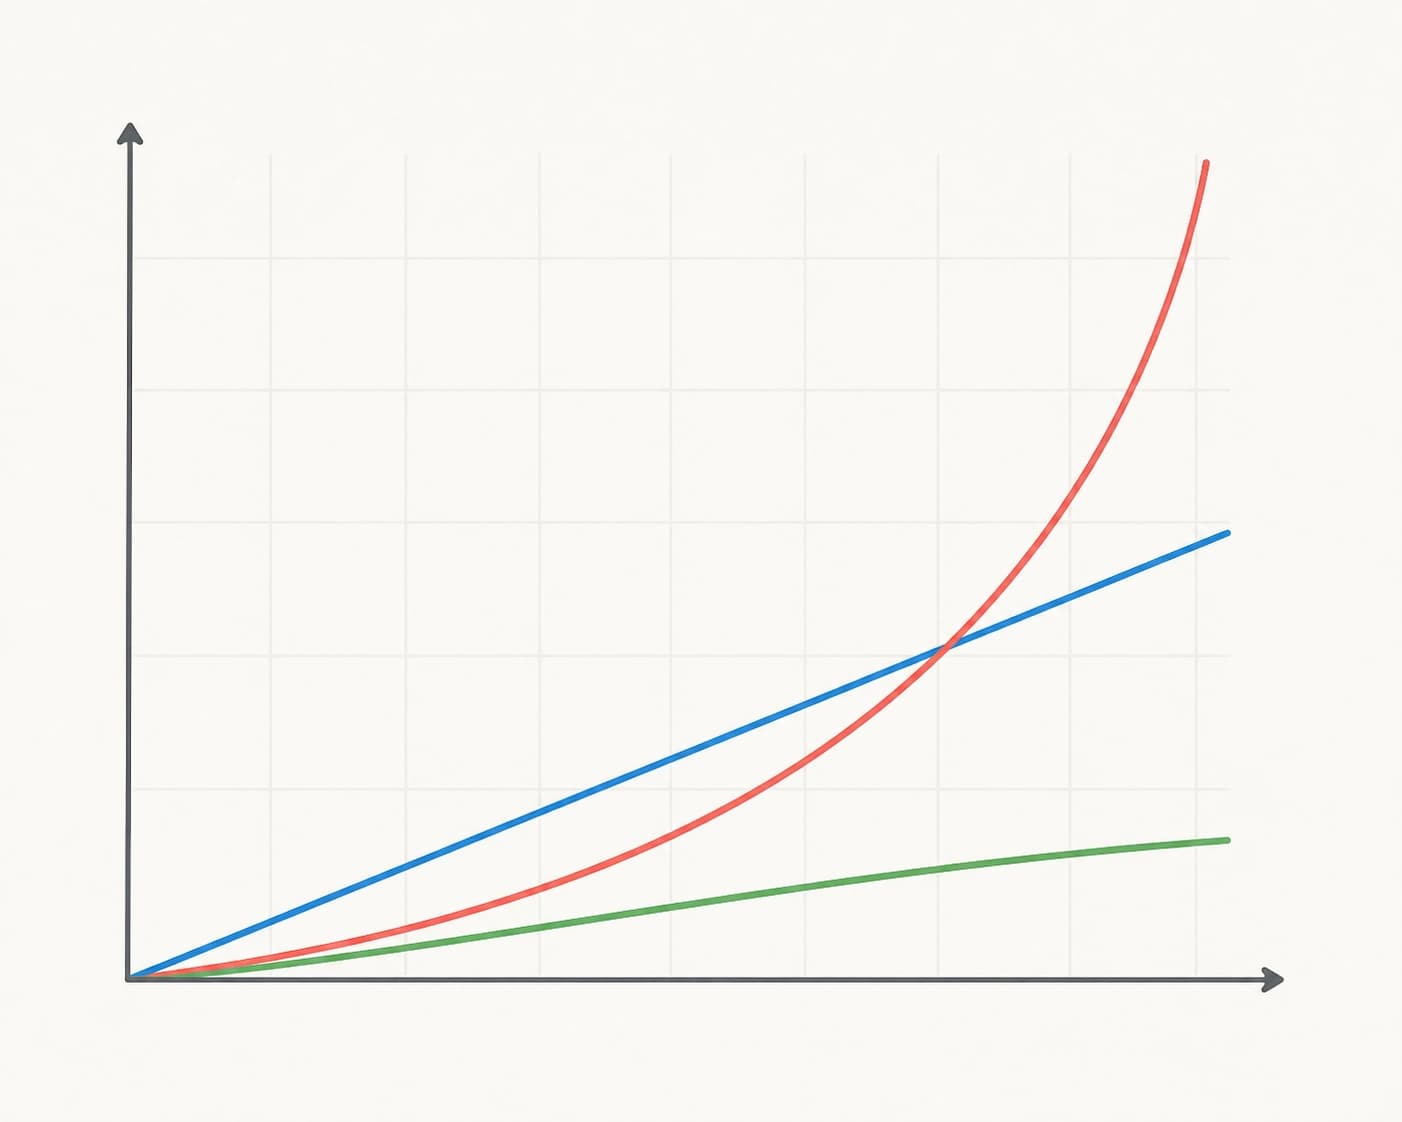
Conclusión: los fallos no coinciden. RL es bueno al principio, pero sufre por el horizonte. DM no acumula error de horizonte, pero paga por el tamaño de la tarea restante. La hibridación aprovecha esta brecha.
Marco teórico del cambio
Los autores construyen un marco teórico unificado de escalado de errores. Bajo supuestos explícitos sobre el escalado de errores, el marco demuestra dos afirmaciones.
- La estructura híbrida da un regret esperado estrictamente menor que cada uno de los dos esquemas base por separado.
- Existe un único paso de cambio óptimo que minimiza el regret del híbrido.
Los autores definen el paso óptimo a nivel del regret esperado. En trayectorias individuales no puede calcularse directamente. Por eso se necesita un disparador práctico.
Conclusión: la teoría responde por qué ayuda el híbrido y cuándo lanzar la transferencia. No ofrece una fórmula lista para cada trayectoria.
Cómo funciona el disparador adaptativo
HyCO utiliza un disparador adaptativo ligero. El disparador combina la entropía de la política y la divergencia RL-DM. Estas señales detectan el cambio de régimen a nivel de trayectoria. Sirven como proxy práctico. Tal proxy es necesario porque el paso de cambio óptimo no se calcula en una trayectoria individual.
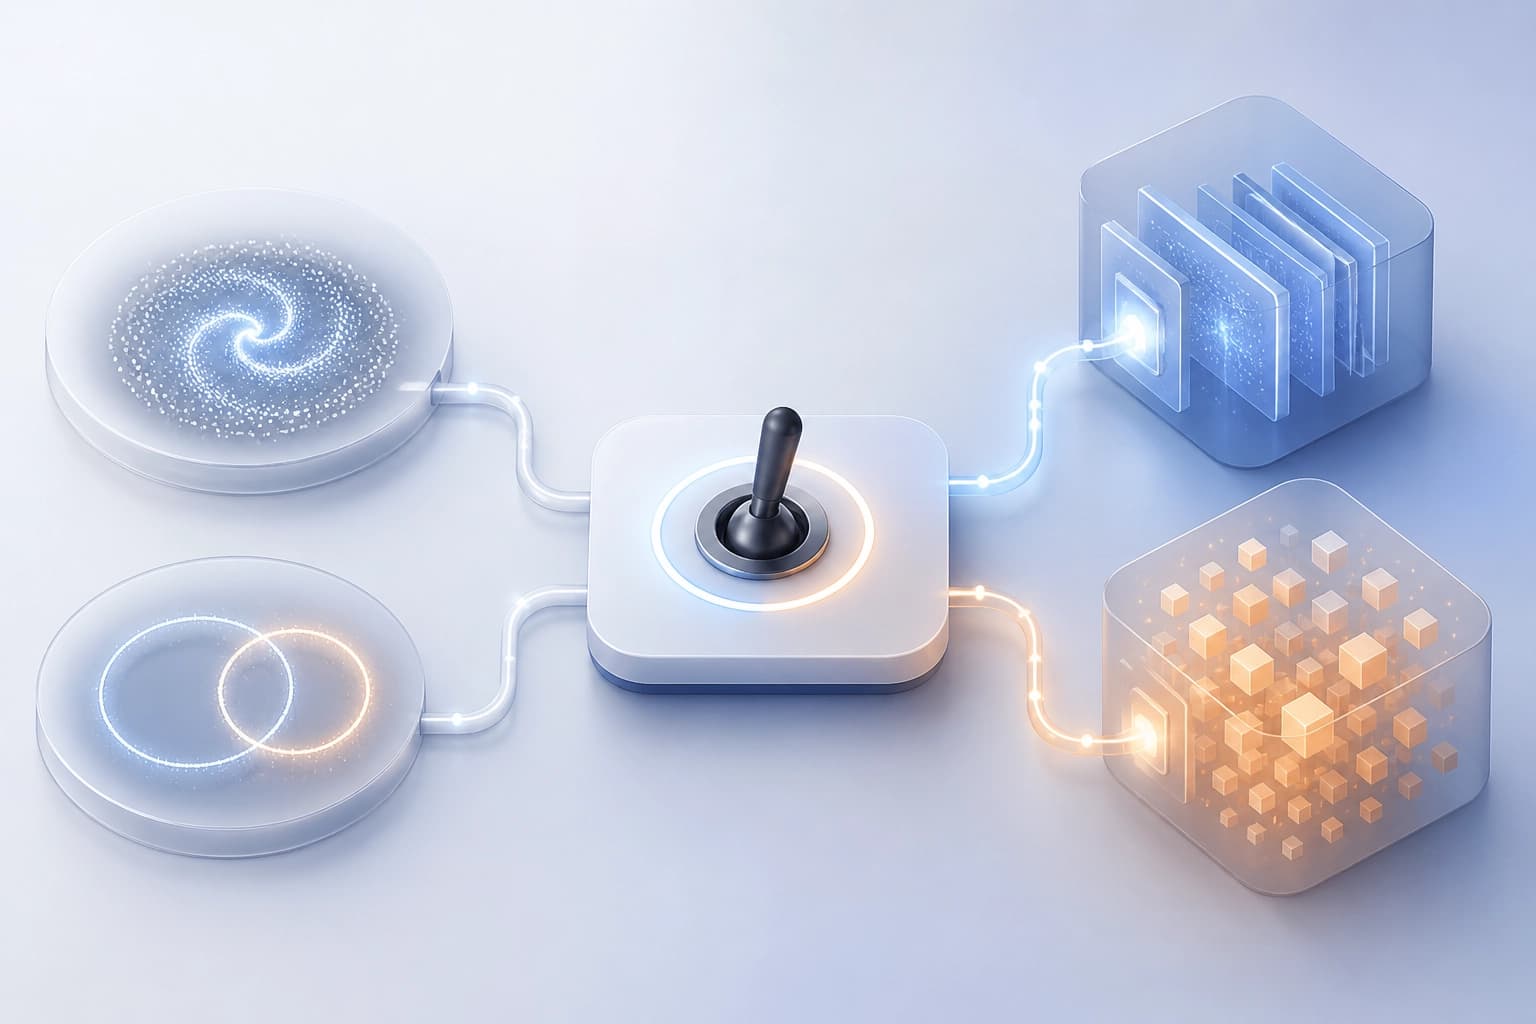
El disparador completa el prefijo RL. La DM condicional completa las soluciones restantes. Criterio práctico: vigilar la entropía de la política y la divergencia RL-DM. Estas señales indican el cambio de régimen y el momento de la transferencia. El disparador se mantiene ligero y adaptativo.
Experimentos y criterio de elección
En experimentos sobre diversos benchmarks, HyCO ofrece mejoras consistentes respecto a ambos solucionadores base. Los resultados también confirman la eficacia empírica del disparador adaptativo.
Criterio práctico de elección: se necesita un algoritmo de inferencia para la optimización combinatoria. Este usa RL para el prefijo temprano y DM para las soluciones restantes. El híbrido reduce el regret esperado respecto a cada esquema base. HyCO sirve como capa de cambio sobre la búsqueda RL y el completado por difusión. Gestiona la transición entre ellos.