
Datos anidados y el viejo problema de la inferencia causal
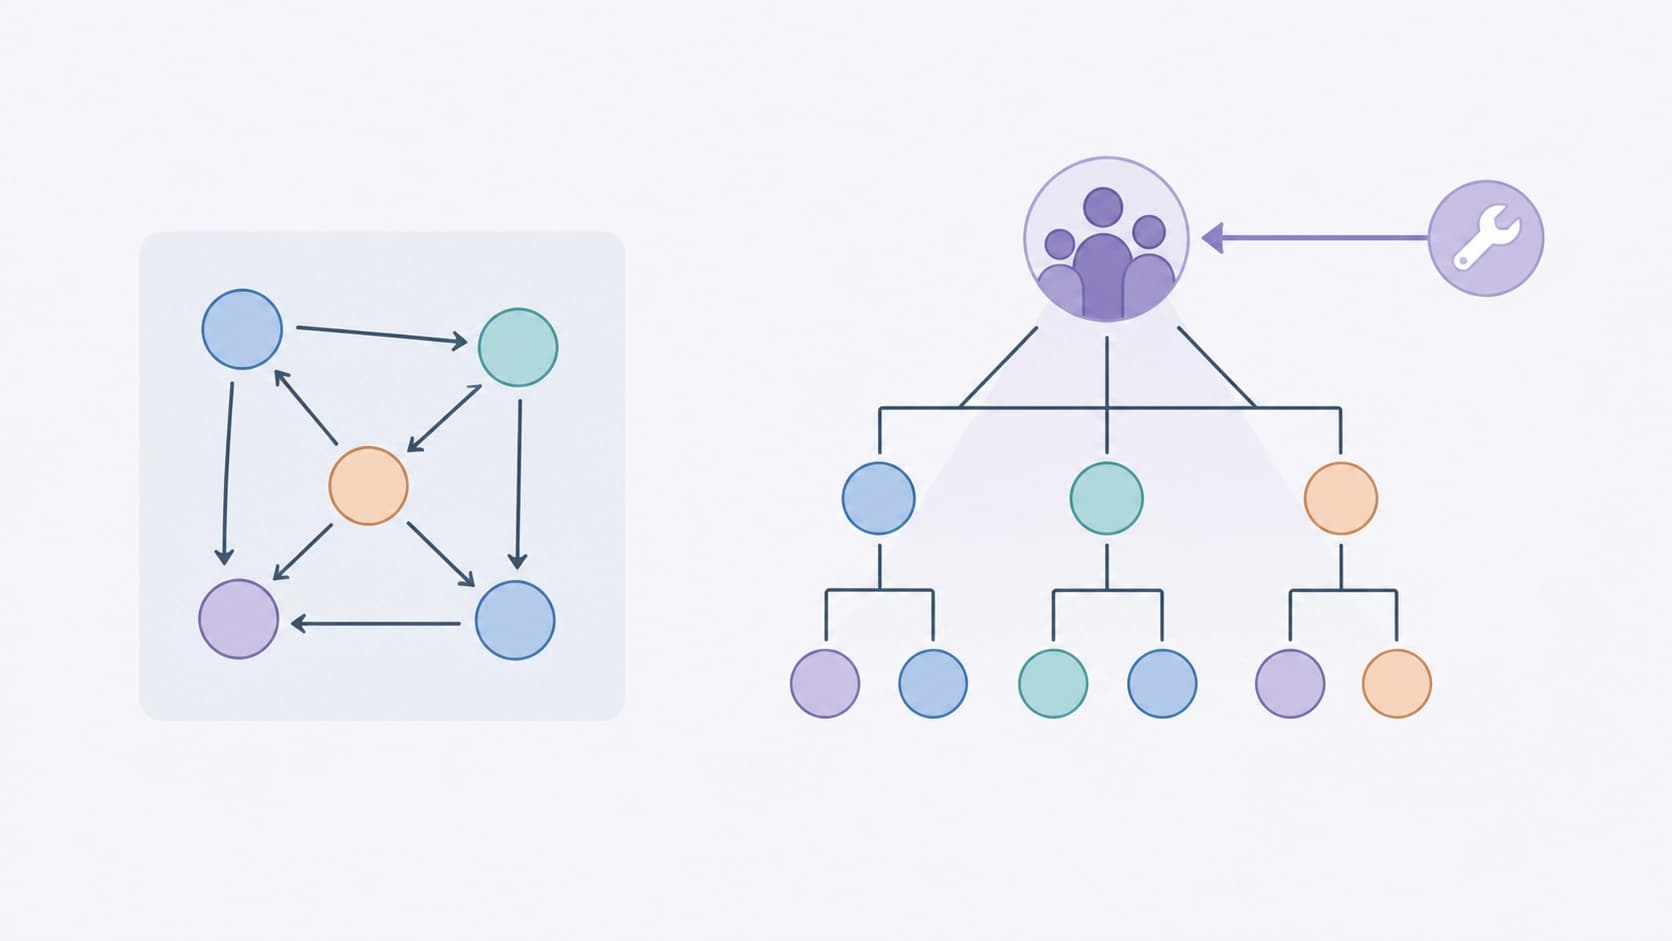
Los métodos clásicos de inferencia causal funcionan bien cuando las observaciones son independientes entre sí. Pero basta con que los datos adquieran una jerarquía —estudiantes dentro de clases, pacientes dentro de clínicas, empleados dentro de departamentos— para que el esquema ingenuo empiece a engañar. El grupo compartido crea una correlación entre los objetos que el modelo confunde erróneamente con señal, y las intervenciones que ocurren en el nivel superior (por ejemplo, un cambio de condiciones en toda una clase) no tienen dónde "conectarse".
De esto trata precisamente el nuevo preprint arXiv:2608.24500 en la sección stat.ML — «Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR». El trabajo se publicó el 25 de agosto de 2026 y lo preparó un grupo de nueve autores — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel y Emilie Devijver. Están disponibles el PDF, la versión HTML y las fuentes TeX; la temática es aprendizaje automático e inteligencia artificial.
El material es interesante no tanto por un modelo más, sino por el intento de armar un pipeline completo y reproducible: desde la notación formal del grafo hasta un número concreto que se pueda defender en un artículo o en un informe ante un cliente.
Qué proponen los autores
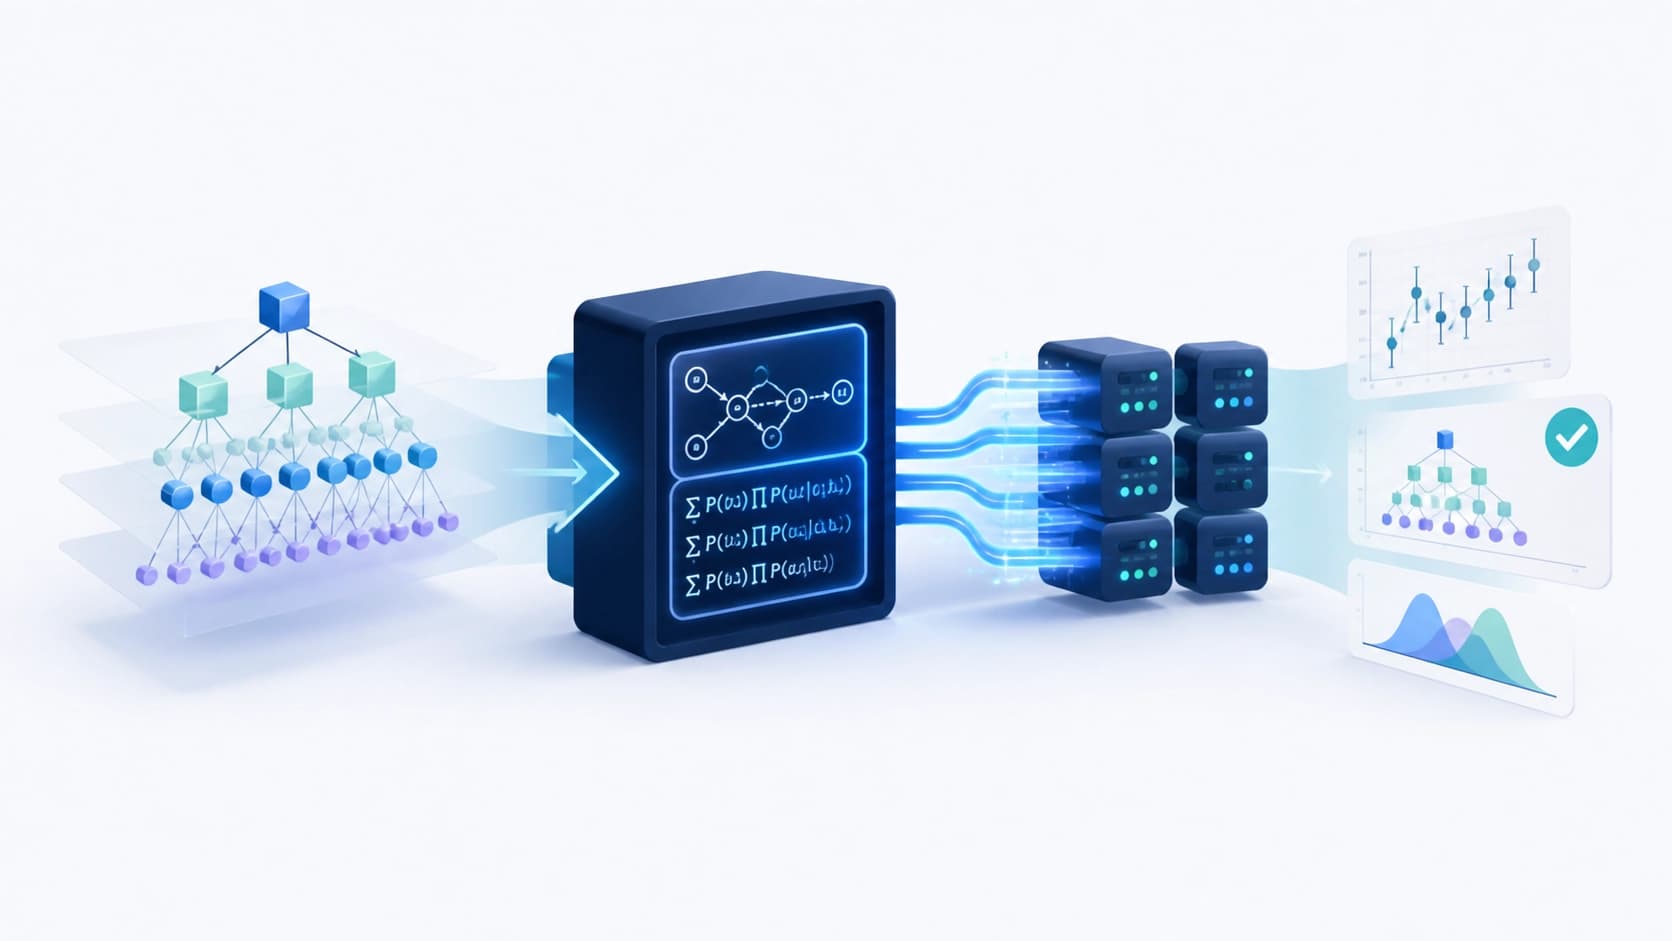
Se trata de un pipeline para modelos causales estructurales jerárquicos (HSCM). Es abierto y está concebido como escalable: la misma lógica debe soportar tanto un pequeño ejemplo didáctico como datos con un gran número de grupos.
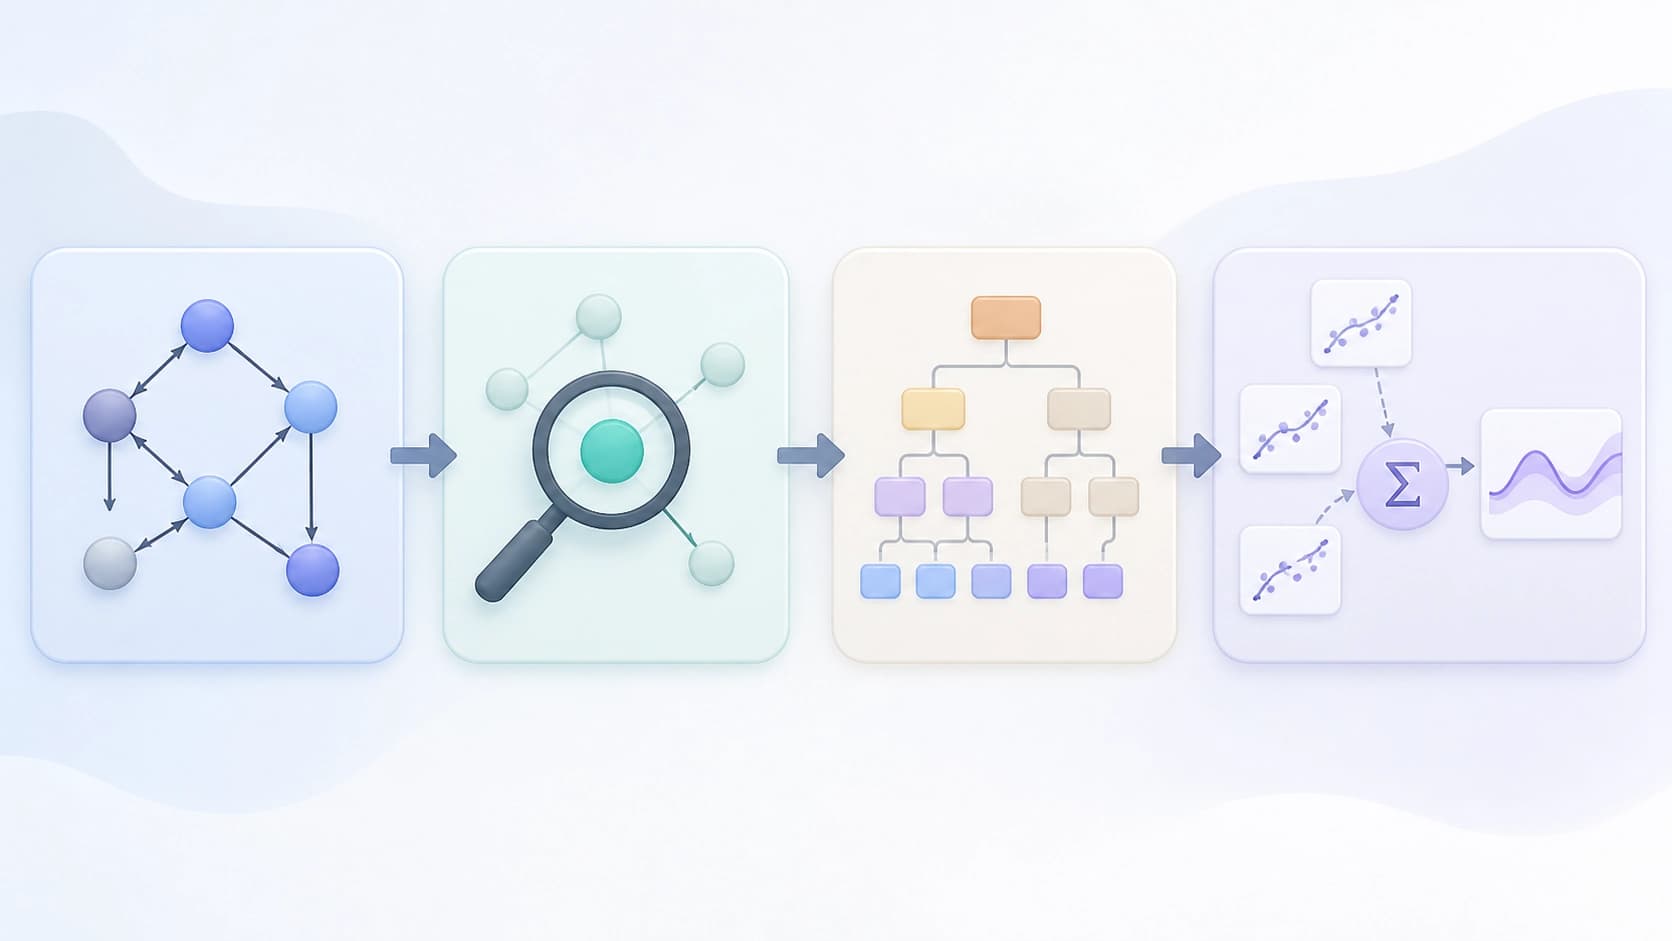
La construcción se arma a partir de cuatro capas:
- transformaciones de grafos — preparación de la estructura que describe las dependencias entre niveles;
- identificación simbólica mediante do-calculus en la biblioteca pyAgrum — la máquina determina por sí sola qué efectos son en principio derivables de los datos disponibles y emite la expresión correspondiente;
- traducción de esa expresión a fórmulas cerradas de HSCM — el resultado simbólico se convierte en algo computable dentro del marco del modelo jerárquico;
- estimación numérica a partir de modelos probabilísticos locales ya ajustados.
La lógica aquí es fundamentalmente de dos etapas. Primero se determina si el efecto es identificable en principio —esto es una cuestión de matemáticas, no de datos—. Y solo después entra en juego la estadística: estimación, error, robustez.
El árbol de sintaxis abstracta como clave de la escala
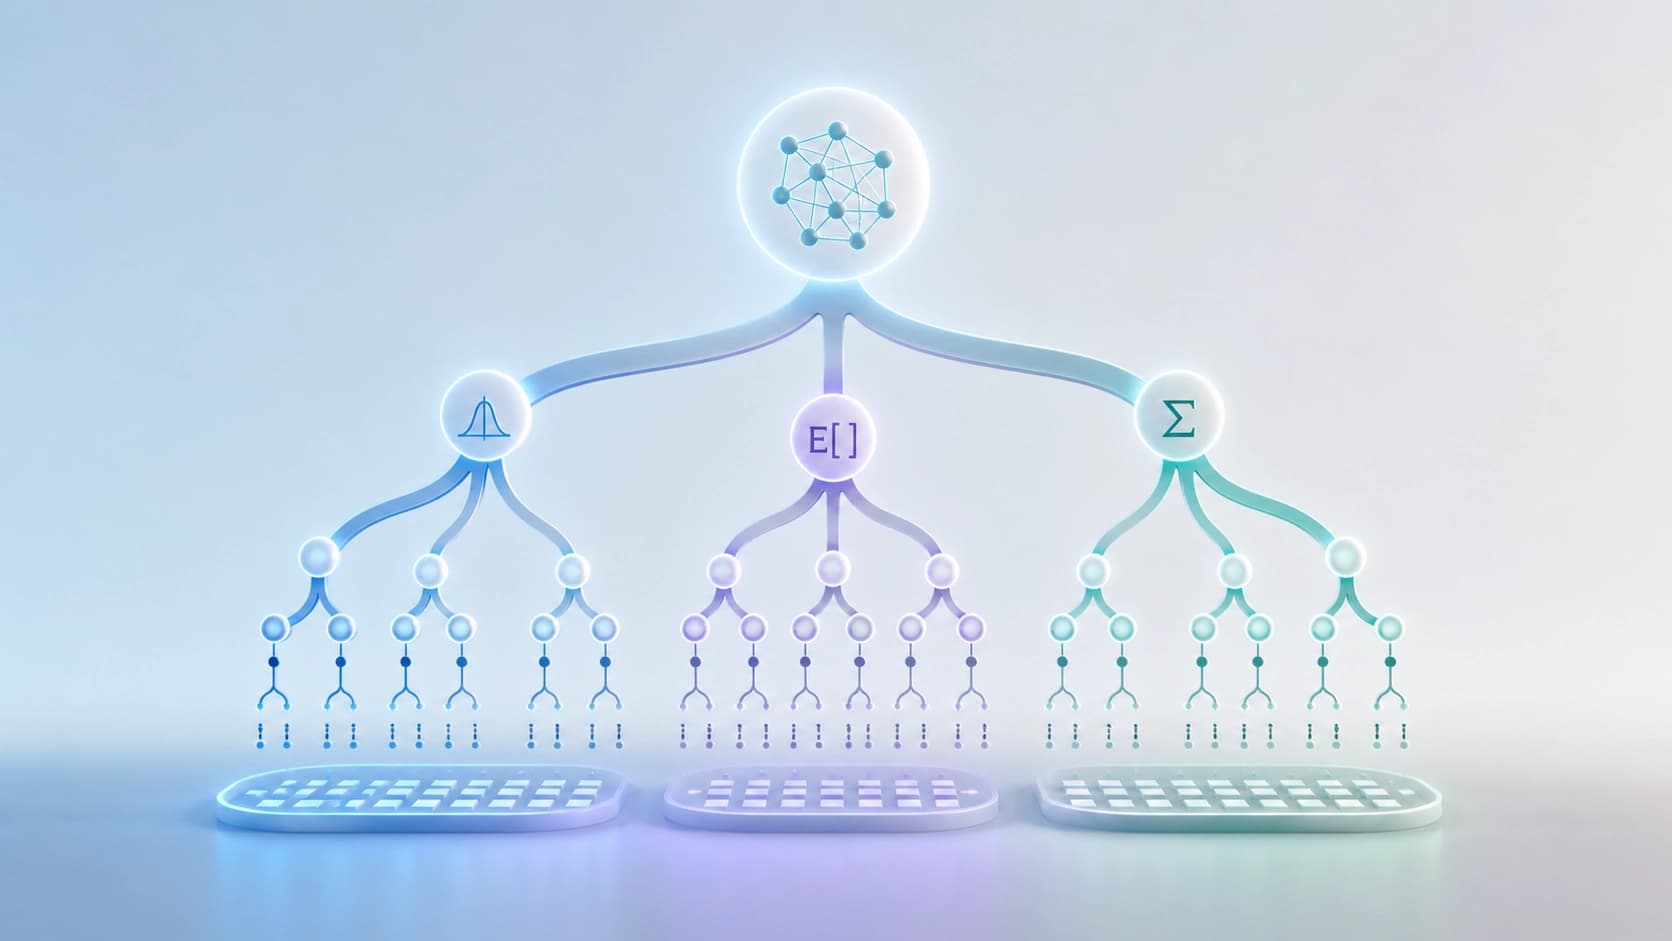
El principal hallazgo técnico del trabajo es un árbol de sintaxis abstracta (AST) adaptado. La fórmula identificada de pyAgrum no se calcula "a lo bruto": se descompone en un árbol, y las hojas de ese árbol se convierten en subtareas independientes de tres tipos — cálculo de densidad, cálculo de esperanza matemática y marginalización.
¿Por qué es importante? Las subtareas resultantes se pueden calcular en paralelo y almacenar en caché los resultados intermedios. En lugar de una única expresión engorrosa, donde un error en un paso temprano arruina todo lo demás, aparece un conjunto de piezas independientes, cada una verificable por separado. En esencia, los autores convierten el problema de la potencia computacional en un problema de organización de los cálculos.
Verificación en Project STAR
Como ejemplo sustantivo se toma el experimento STAR (Student-Teacher Achievement Ratio), realizado en 1985 en el estado de Tennessee, EE. UU. Es un conjunto de datos jerárquico de referencia: se creó para evaluar la influencia del tamaño de la clase en el rendimiento académico, y las observaciones en él están anidadas en clases. Esta estructura es un polígono ideal para HSCM, porque la intervención aquí ocurre naturalmente a nivel de clase, no de un niño individual.
Antes de pasar a los datos reales, los autores verifican el pipeline con motivos canónicos de HSCM y escenarios de benchmark donde la respuesta verdadera se conoce de antemano. Es un orden razonable: primero asegurarse de que el método encuentra la respuesta correcta allí donde se conoce, y solo después aplicarlo a datos donde no hay con qué verificarlo. La aplicación final son los resultados de matemáticas en jardín de infantes en el marco de STAR.
Qué mostraron los resultados
Las conclusiones resultaron aleccionadoras, y en eso radica su valor.
En primer lugar, los modelos base planos, que ignoran la jerarquía, recuperan asociaciones —pero no son capaces de codificar una intervención a nivel de clase—. La correlación "clase más pequeña — puntajes más altos" y el efecto causal de reducir la clase son cosas distintas, y la primera no sustituye al segundo.
En segundo lugar, la identificación simbólica por sí sola no basta. Incluso si la fórmula se deriva correctamente, para la inferencia jerárquica práctica se necesita una capa numérica que funcione.
De ahí la tercera tesis: la estimación escalable y las verificaciones de estabilidad numérica no son un apéndice del método, sino su parte central. Una expresión elegante que no se puede calcular o que se desmorona ante el menor cambio en los datos no aporta valor científico. Por eso en el pipeline se presta tanta atención a la descomposición de los cálculos y al control de la robustez.
Para qué sirve esto más allá de STAR
Los datos jerárquicos aparecen mucho más a menudo de lo que parece. Educación, medicina, pruebas A/B con agrupamiento, encuestas por regiones, mediciones industriales por lotes — en todas partes hay anidamiento, y en todas partes existe la tentación de ignorarlo en aras de la simplicidad.
El valor del trabajo radica en que propone no un truco aislado, sino un procedimiento reproducible. Código abierto, identificación automática mediante pyAgrum, transición formal a fórmulas computables, subtareas independientes — todo esto en conjunto reduce el umbral de entrada: el investigador no necesita derivar por sí mismo las fórmulas para cada nueva estructura de grafo.
Limitaciones y sentido común
Conviene recordar que estamos ante un preprint, no ante una publicación revisada por pares: arXiv:2608.24500 en la versión v1, DOI 10.48550/arXiv.2608.24500. Los resultados sobre motivos canónicos y un único conjunto de datos son una buena verificación, pero no una prueba universal.
Además, toda inferencia causal se apoya en supuestos sobre la estructura del grafo. El pipeline automatiza los cálculos y los hace más transparentes, pero no elimina la pregunta "¿acaso describimos el mundo correctamente?". Si el grafo es incorrecto, un efecto calculado con esmero seguirá siendo un error calculado con esmero.
Por eso el principal resultado práctico del artículo suena terrenal: la identificación sin estimación es inútil, la estimación sin robustez es arriesgada, y los datos anidados requieren un nivel propio en el modelo, pues de lo contrario las intervenciones a nivel de grupos simplemente no tienen con qué correlacionarse.


