
Grafos en lugar de suerte: cómo GxP-Agent hace que la programación LLM de datos clínicos sea fiable
Analizamos un preprint en el que cinco LLM avanzados no lograron preparar un conjunto analítico válido para una presentación regulatoria, mientras que un sistema multiagente basado en un grafo acíclico dirigido de 15 nodos especializados muestra una coincidencia estructural del 100% con el estándar de referencia. Este enfoque transforma la generación monolítica de código en una secuencia de pasos de dominio verificables.
Programación clínica: dónde tropiezan las LLM
La preparación de datos de ensayo clínico para la presentación regulatoria es un proceso con requisitos estrictos. Los protocolos deben convertirse en conjuntos de datos analíticos que cumplan con las normas del CDISC, y cualquier error aquí puede costar un retraso o rechazo de la aplicación. Durante mucho tiempo, esta etapa siguió siendo un cuello de botella: requiere tanto conocimiento de dominio, precisión en código, y una comprensión de la lógica regulatoria.
Cuando se trata de generar tal código con modelos de lenguaje grande, la imagen se ve sombría. En un experimento descrito en un preprint sobre arXiv, cinco modelos fronterizos recibieron once intentos de un solo disparo para crear un conjunto de datos válido a nivel de sujeto, y ninguno logró. Esto no se trata de fallas menores, sino de la total inutilizabilidad del resultado. Los modelos parecen ignorar la estructura misma del proceso: tratan de montar todo el oleoducto a la vez, sin controles intermedios o una comprensión de qué pasos son obligatorios y que dependen de los anteriores.
GxP-Agent: descomposición a través de un gráfico de proceso
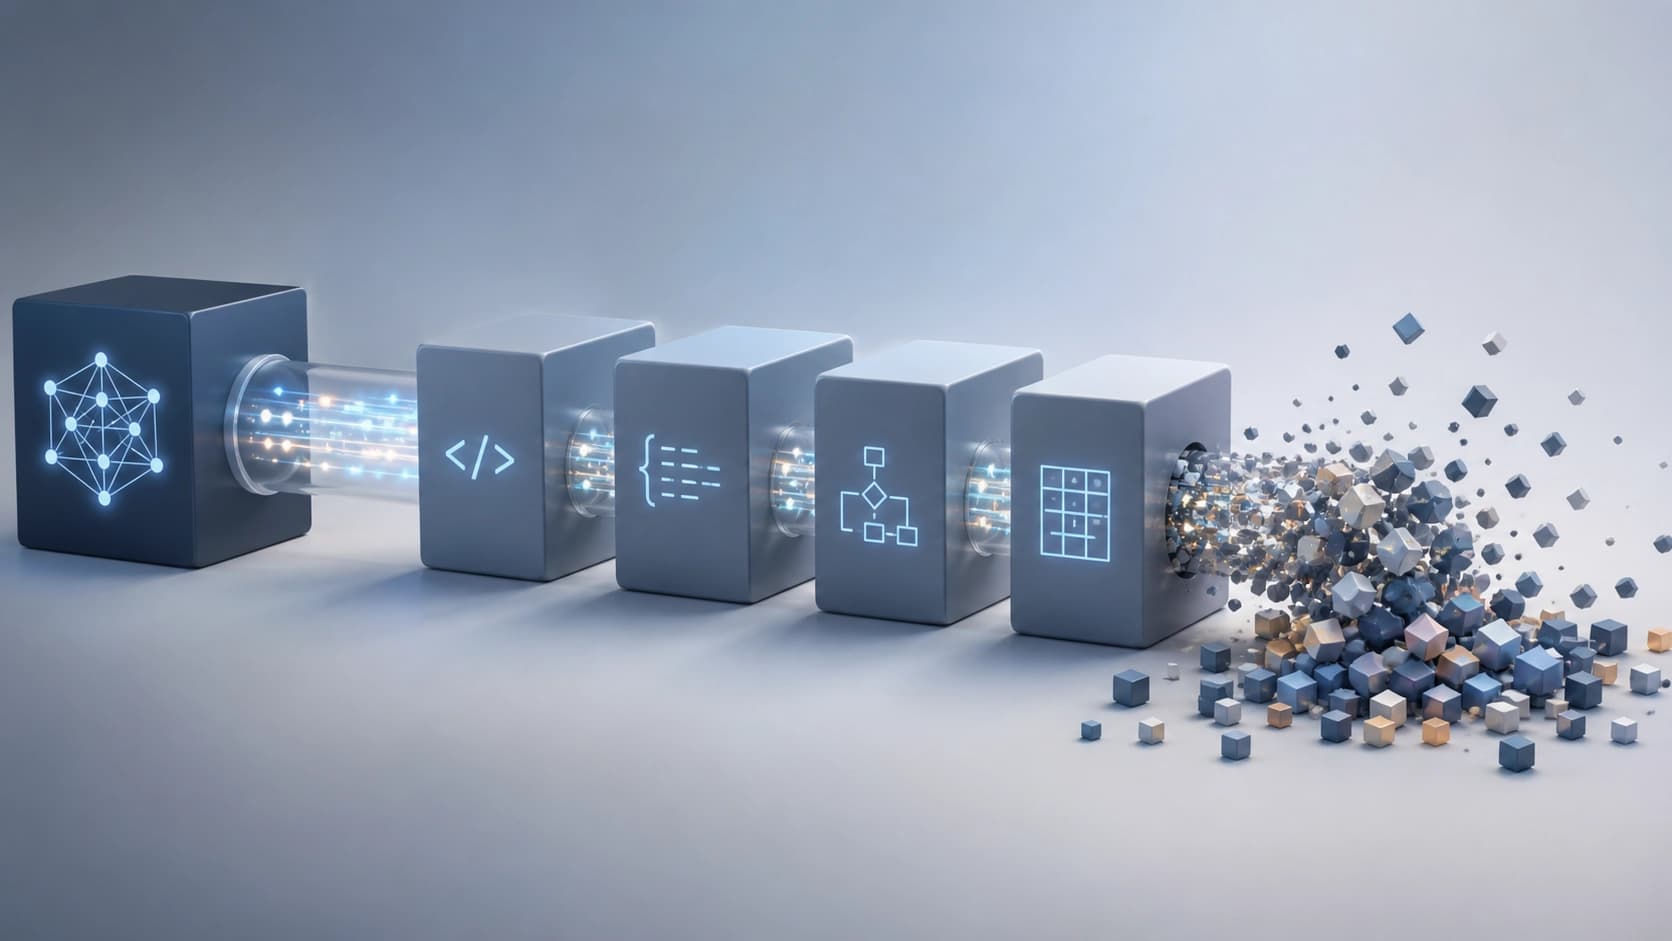
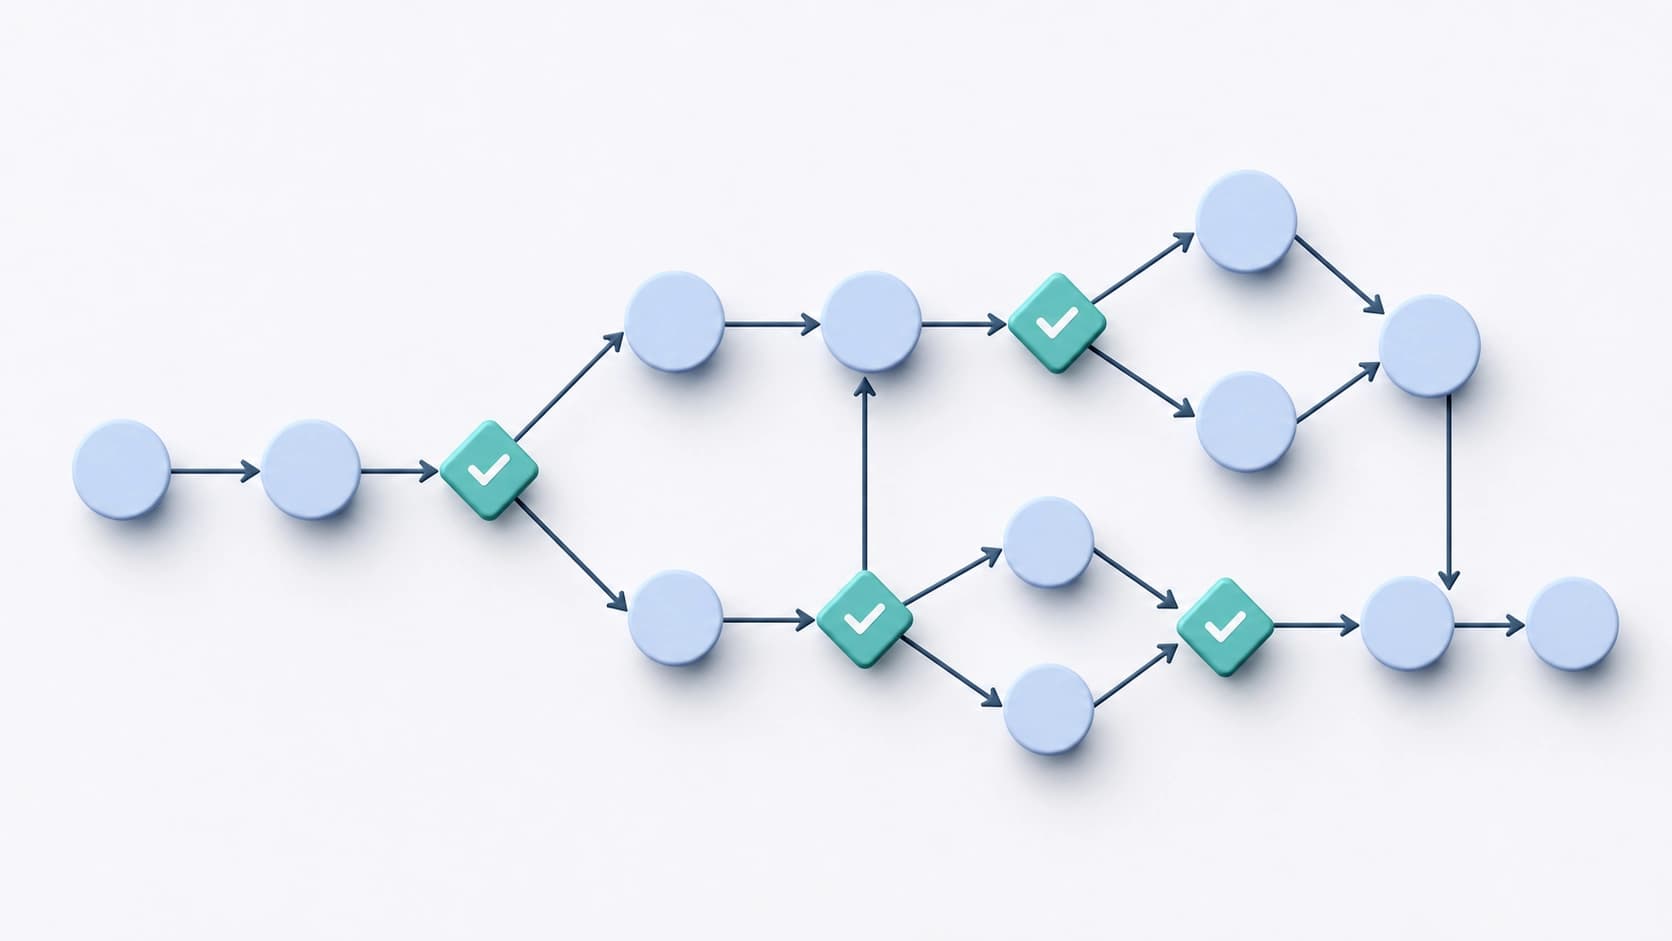
La respuesta a este problema fue el sistema multiagente GxP-Agent. Su idea clave no es confiar en la "razonación" del modelo sobre cómo funciona el proceso regulatorio, sino codificar explícitamente ese proceso. La secuencia regulatoria de acciones está representada como un gráfico acíclico dirigido (DAG). En lugar de la generación monolítica de todo el conjunto de datos en un paso, la tarea se divide en 15 nodos de dominio específico. Cada nodo es una operación separada llevada a cabo por un agente de trabajo equipado con un contexto de habilidades de pharmaverse. Entre los nodos, hay puertas de validación, y se proporcionan retries condicionales cuando sea necesario.
Este enfoque cambia la naturaleza misma de los errores. Si el modelo se desvía del resultado esperado en algún nodo, esto se detecta inmediatamente, y el paso puede ser reiniciado en lugar de rehacer todo el oleoducto. En esencia, el LLM deja de ser un "generador de todo a la vez" y se convierte en un ejecutante de subtascos locales y bien descritos. La topología gráfica proporciona un marco rígido en el que el modelo puede actuar más libremente.
¿Cómo es esto en la práctica
Cada nodo DAG es responsable de un dominio específico de datos, y el trabajador no recibe una tarea abstracta como "construir ADSL", sino una tarea estrecha con entradas claras, salidas y criterios de validación. Si el resultado falla la validación, se activa una retry condicional — el agente recibe comentarios y corrige el código. Esto se asemeja a un bucle "generado — check — fix", pero incrustado en la estructura gráfica en lugar de ejecutar arbitrariamente.
Números en CDISC-Bench: de cero a cien
Para evaluar la eficacia del enfoque, los autores desarrollaron un punto de referencia basado en la ejecución llamado CDISC-Bench. Se basa en la verdadera presentación piloto de la FDA — CDISCPilot01, que incluye 254 temas y 49 variables ADSL de verdad terrestre. Tal punto de referencia no sólo comprueba la sintaxis o semántica del código, sino el resultado real de su ejecución.
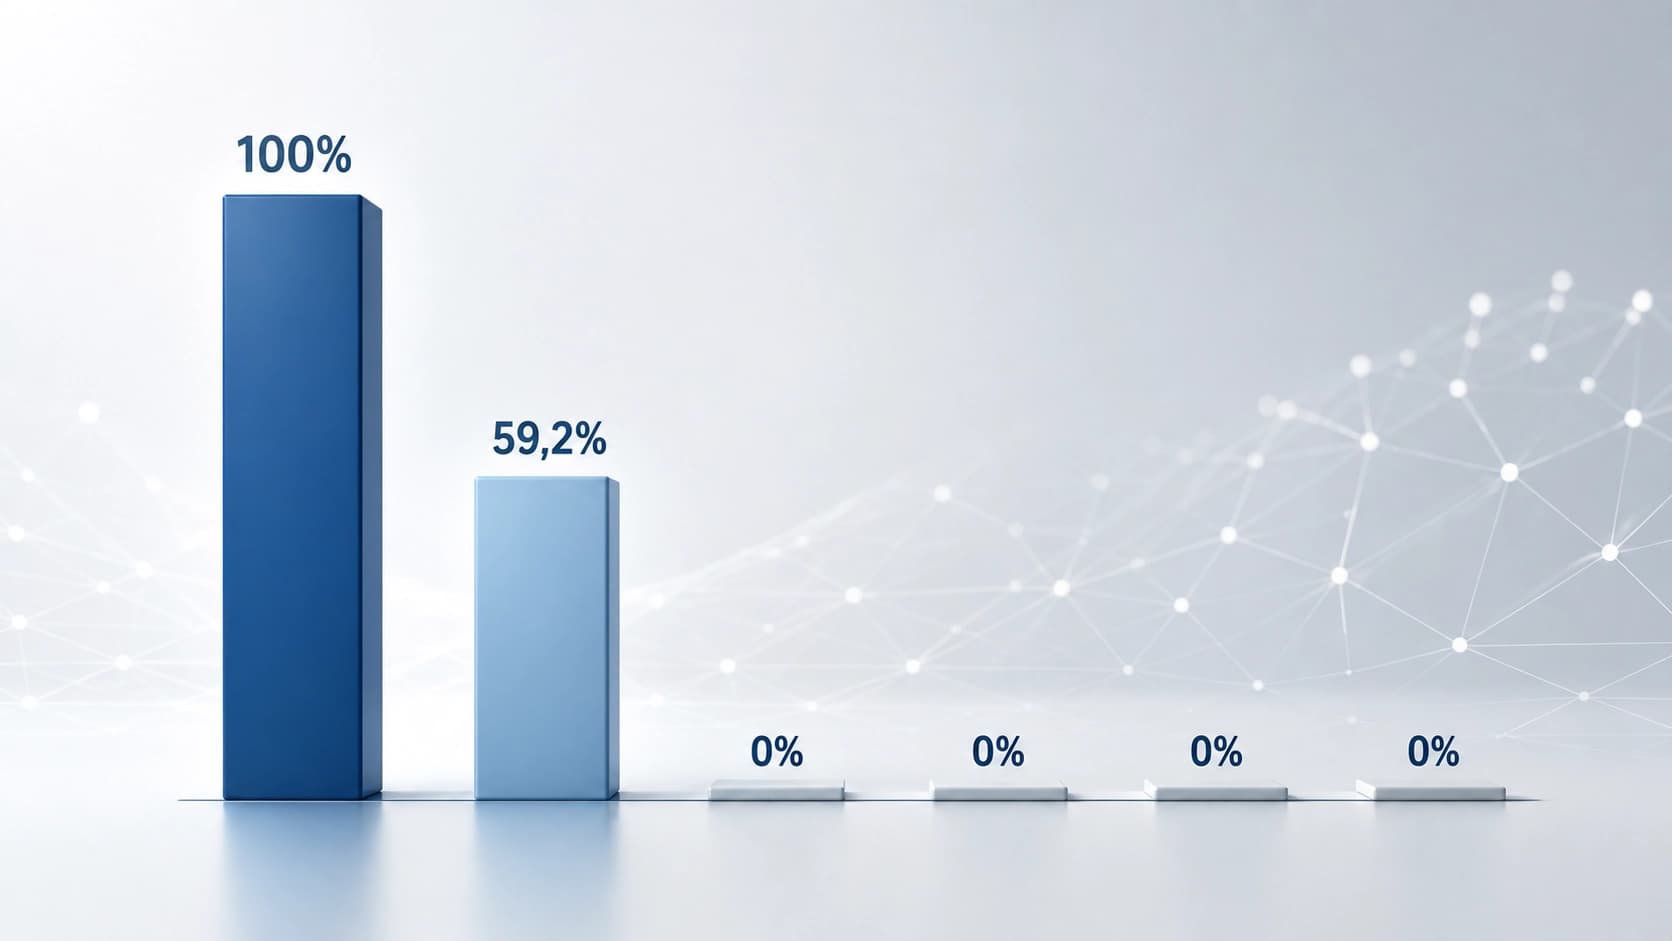
Aquí, GxP-Agent mostró resultados impresionantes: con el modelo Claude Sonnet 4.6, logró un partido 100% estructural, las 49 variables y los 254 registros fueron correctos en tres carreras independientes. Para la comparación, la mejor base aumentada de recuperación se detuvo en el 59,2%, y todos los demás enfoques —un agente único y un agente múltiple plano— marcaron cero por ciento. En otras palabras, cualquier arquitectura sin topología gráfica es simplemente incapaz de manejar la tarea.
Los modelos Weaker también benefician
Un efecto secundario interesante: la topología DAG reduce los requisitos para el modelo mismo. Cuando GPT-4.1 fue utilizado como trabajador en el mismo gráfico, el partido estructural promedio fue 59,2% — el mismo nivel que la base de referencia aumentada de recuperación en un modelo fuerte. Sin la estructura gráfica, GPT-4.1 mostró un resultado cero. Esto confirma que el papel decisivo no es desempeñado por el poder de un modelo individual, sino por cómo se organiza el proceso.
Versatilidad del enfoque y las conclusiones
Los autores no se limitaron a un solo dominio. El mismo principio se aplica al conjunto de datos ADAE (acontecimientos adversos) que utiliza un DAG ramificado de 9 nodos, 55 variables y 1191 registros. Se logró una coincidencia estructural del 100% en el primer intento. Esto sugiere que el método generaliza más allá de ADSL y es adecuado para otros tipos de datos clínicos.
La principal toma de la obra: la confiabilidad en la programación clínica se logra no a través de "razones inteligentes" de LLMs, sino a través de la codificación conocimiento de dominio sobre el proceso en forma de topología gráfica. El modelo sigue siendo un componente importante, pero no el único, del sistema. Es el gráfico que establece las limitaciones y el orden, mientras que el modelo de lenguaje lo llena con código concreto. Esta simbiosis hace posible obtener resultados compatibles con GxP que pueden basarse en las sumisiones regulatorias.
Preguntas frecuentes
Material similar
Todos los materiales
AURA-Eval: cómo comprobar que un agente LLM reconoció el riesgo y cambió su siguiente paso
El framework evalúa el comportamiento de los agentes LLM no por su veredicto final, sino por cómo reaccionan ante el riesgo en puntos clave: se interrumpen las trayectorias de llamadas a herramientas y, a continuación, el modelo debe continuar razonando y actuando, mientras que un panel de jueces LLM analiza la detección del riesgo, la naturaleza del paso y su seguridad. En 1249 tareas recopiladas a partir de 157 trayectorias de R-Judge, los actos inseguros aumentan en 20 modelos cuando no hay una vía segura, y retirar la supervisión antes de la ejecución convierte el 52,3 % de los casos inicialmente seguros en inseguros.
10 noviembre 2026
Memoria del reservorio de Chern-Simons: dinámica autónoma de la conectividad y transporte de densidad
El artículo analiza cómo un reservorio conserva el historial de las señales de entrada tanto en la distribución de densidad como en los grados de libertad geométricos. La comparación de cuatro mecanismos muestra que la corriente crea una componente de conectividad independiente que modifica la respuesta posterior de la densidad, y que tener en cuenta todos los rasgos medidos ofrece una pequeña mejora en la decodificación del orden de los impulsos.
10 noviembre 2026
STAR: normalización adaptativa del contexto temporal y del grafo de servicios para la gestión de incidentes de extremo a extremo
El framework STAR enseña representaciones a partir de métricas, registros y trazas, aplicando una normalización aprendida que tiene en cuenta la dinámica temporal a múltiples escalas y la estructura de dependencias entre servicios. En dos conjuntos de datos reales, este enfoque mejora de forma consistente la detección de anomalías, la clasificación de fallos y la búsqueda de causas raíz frente a los métodos de referencia más avanzados.
10 noviembre 2026