
Recompensa verificable y su punto ciego
El aprendizaje por refuerzo basado en recompensas verificables se ha convertido en una receta habitual para los modelos de lenguaje: hay una tarea con una respuesta verificable de forma inequívoca —matemáticas, código, preguntas de respuesta corta— y hay una señal de «resuelto / no resuelto». El esquema funciona, pero tiene una debilidad conocida. La recompensa final evalúa el resultado en su conjunto, no el camino hacia él. El modelo puede recibir puntuación por una conclusión correcta construida sobre premisas inventadas, y de la misma manera puede perder puntuación por un razonamiento correcto con una formulación final desafortunada.
Aquí es precisamente donde vive el riesgo de alucinaciones. Si la recompensa depende solo de la coincidencia final, la política no tiene incentivo para ser cuidadosa en el camino: basta con adivinar la respuesta. Una de las formas de corregir esto es añadir un control factual a nivel de proceso: verificar las afirmaciones intermedias, no solo el resultado final.
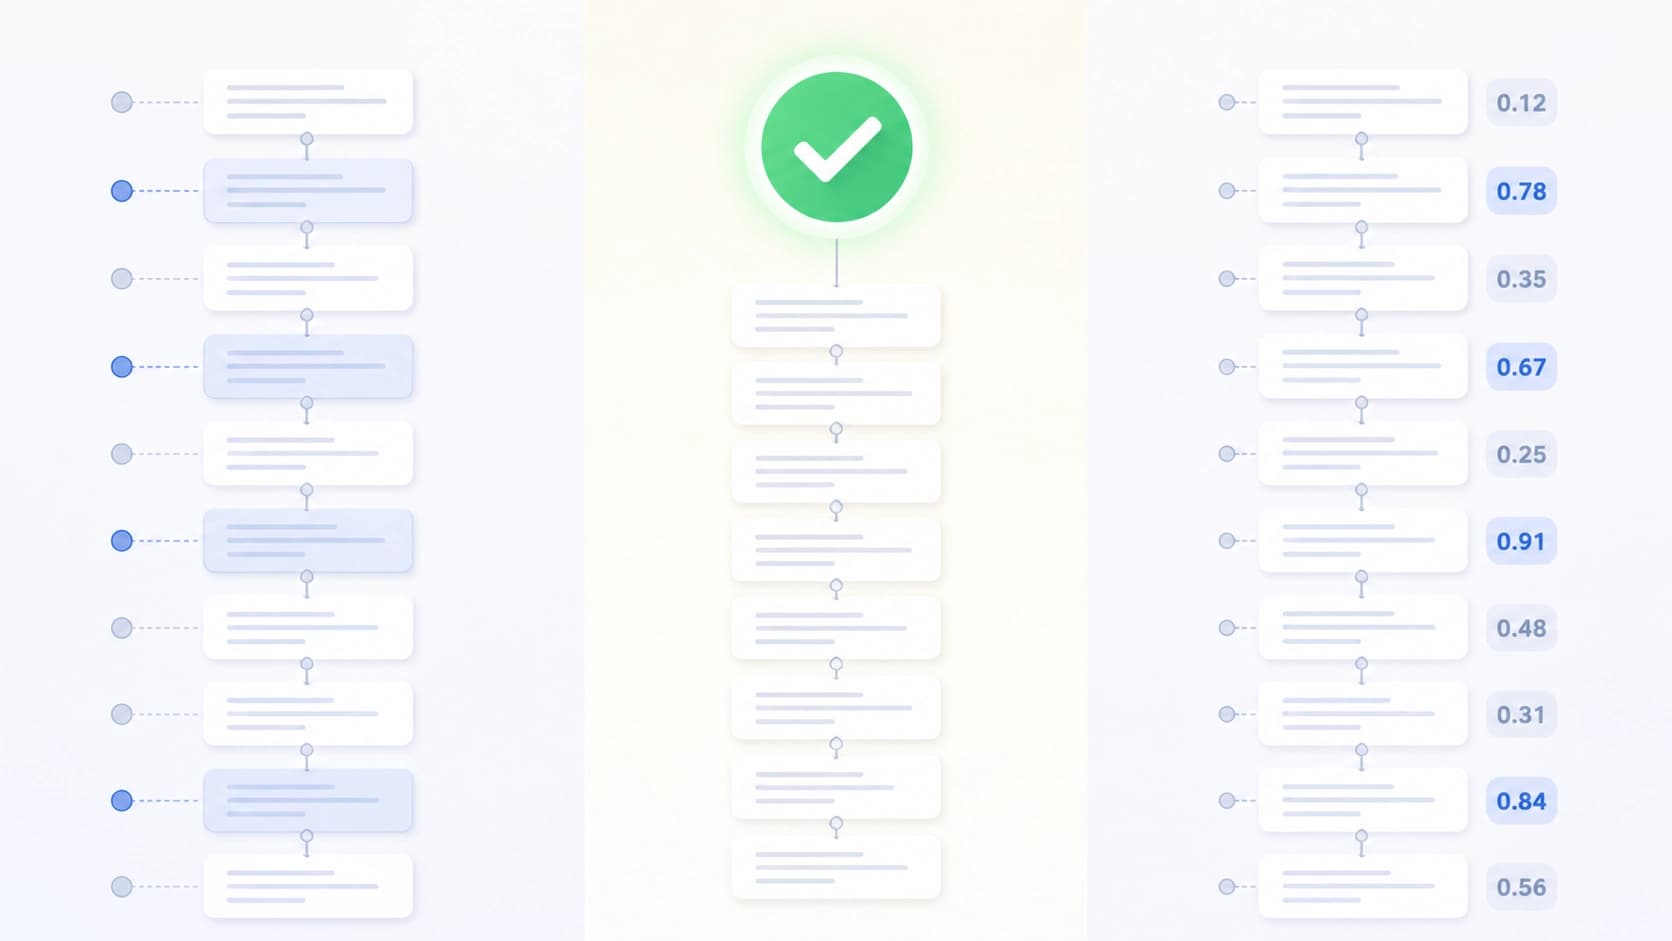
Pero el enfoque a nivel de proceso revela su propio problema. Las verificaciones de hechos se recopilan y se promedian de forma agregada: la señal llega en bloque para todo el fragmento, y nadie evalúa la fiabilidad de las propias verificaciones. Como resultado, surge una brecha entre lo que realmente se verificó y lo que realmente se actualizó en la política.
Dos ambigüedades en lugar de un solo problema
Los autores del trabajo arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) dan nombre a esta brecha —«asignación de crédito factual ruidosa» (noisy factual credit assignment)— y la descomponen en dos aspectos independientes.
- Ambigüedad en la localización del crédito. No está claro a qué token o fragmento concreto atribuir el mérito o la culpa. El hecho se verificó a nivel de oración, pero la actualización se produce a nivel de token: las granularidades no coinciden y la señal se difumina.
- Ambigüedad en la fiabilidad del crédito. No está claro cuánto se puede confiar en la propia verificación. Algunos juicios factuales son fiables y reproducibles; otros son frágiles, dependen del contexto o de una formulación concreta. Sin un peso de confianza, entran en el entrenamiento en igualdad de condiciones.
El segundo aspecto es el más subestimado. Los esquemas habituales de tratamiento de señales factuales se comportan como si todas las verificaciones tuvieran la misma calidad. En la práctica no es así, y las verificaciones débiles empiezan a corromper la optimización al mismo nivel que las fuertes.
Cómo está diseñado FARCA
FARCA son las siglas de Fact-Aligned Reliability-Aware Credit Assignment: asignación de crédito alineada con los hechos y consciente de su fiabilidad. No es un modelo nuevo ni un conjunto de datos, sino un marco de optimización de políticas: reconfigura cómo el control factual se convierte en señal de entrenamiento.
Alinear las granularidades
El primer paso es la localización del crédito a grano fino. La idea es simple en su formulación y no trivial en su implementación: la granularidad de la verificación de hechos debe equipararse a la granularidad de las actualizaciones de la política. Así, la señal factual no llega «como un promedio para toda la respuesta», sino que se vincula a los tokens concretos que realmente responden por esa afirmación. En lugar de un promedio difuso, la política recibe indicaciones puntuales.
Evaluar cuánto se puede confiar en la verificación
El segundo paso son los pesos de fiabilidad. Para calcularlos, los autores introducen la atribución contrafactual de evidencia (counterfactual evidence attribution): observan en qué medida el juicio factual depende del fragmento clave de evidencia. Si al eliminar o sustituir esa evidencia el veredicto cambia, significa que la verificación realmente se apoya en ella, y esa señal merece mayor confianza. Si el veredicto permanece igual independientemente de la evidencia, el juicio probablemente no trata de lo que creemos, y su peso disminuye.
Los pesos obtenidos modulan después las recompensas factuales y las ventajas locales de la política. El sentido práctico: las señales potencialmente poco fiables reciben menor voz en la actualización, en lugar de bloquearse por completo. Es un filtrado suave en vez de un descarte rígido: la política no pierde información, pero deja de seguirla ciegamente.
Qué muestran los experimentos
Los autores probaron el enfoque en distintos modelos y varios benchmarks que evalúan el razonamiento factual. El resultado declarado es un aumento notable de la factualidad manteniendo las capacidades generales de razonamiento. Esta última parte es tan importante como la primera: las mejoras en factualidad a menudo se compran a costa de la degradación de otras habilidades, cuando el modelo se vuelve más cauteloso y a la vez más débil. Aquí, según los datos de los autores, esto no ocurre.
Cabe destacar además que el método permanece dentro del paradigma del RL con recompensas verificables: no exige renunciar al pipeline existente ni sustituirlo por algo radicalmente distinto. Se integra como una capa entre la verificación de hechos y la actualización de la política.
Qué se deduce de esto
La idea principal del trabajo es más amplia que una sola arquitectura. La conversación sobre la factualidad de los modelos suele plantearse en la lógica de «verificar o no verificar». Pero cuando las verificaciones ya existen, la pregunta clave se desplaza: cómo se convierte exactamente su resultado en aprendizaje. Un error en esta articulación no parece un error, parece ruido normal de entrenamiento, y por eso pasa fácilmente desapercibido.
Reconocer que no se confía por igual en todas las fuentes parece casi trivial a nivel de sentido común. Pero en los esquemas de aprendizaje por refuerzo esto sigue siendo poco frecuente: las señales se acumulan en un fondo común y la diferencia entre una evidencia fiable y una conjetura casual se borra. FARCA es un intento de devolver esa diferencia a la fórmula. Hasta qué punto el enfoque resultará transferible más allá de las tareas con respuesta verificable, donde un hecho no se puede confirmar o refutar tan fácilmente, es una pregunta abierta, y es también la dirección más interesante para trabajos futuros.


