El ajuste completo dejó de ser una opción razonable
Los modelos fundacionales para electroencefalografía se entrenan sin etiquetas — con tareas contrastivas o con la reconstrucción de fragmentos enmascarados de la señal. La lógica es la siguiente: el modelo absorbe patrones generales de ritmos, artefactos y transiciones entre estados, y luego se ajusta para una tarea concreta como la detección de descargas epilépticas. En teoría, esto produce representaciones que se transfieren entre clínicas y equipos. En la práctica, todo es más complicado: los archivos clínicos de registros se parecen muy poco entre sí, y la calidad de la transferencia se resiente de forma notable.
El segundo problema es la economía. El ajuste fino clásico actualiza todos los pesos, lo que exige importantes recursos computacionales para cada nueva tarea. En un servicio sin clúster de GPU, ese escenario simplemente no arranca. De ahí la pregunta en torno a la cual se construye el trabajo arXiv:2608.24727: ¿se puede prescindir de una fracción pequeña de parámetros sin perder calidad?
Nueve por ciento: qué se ajusta exactamente
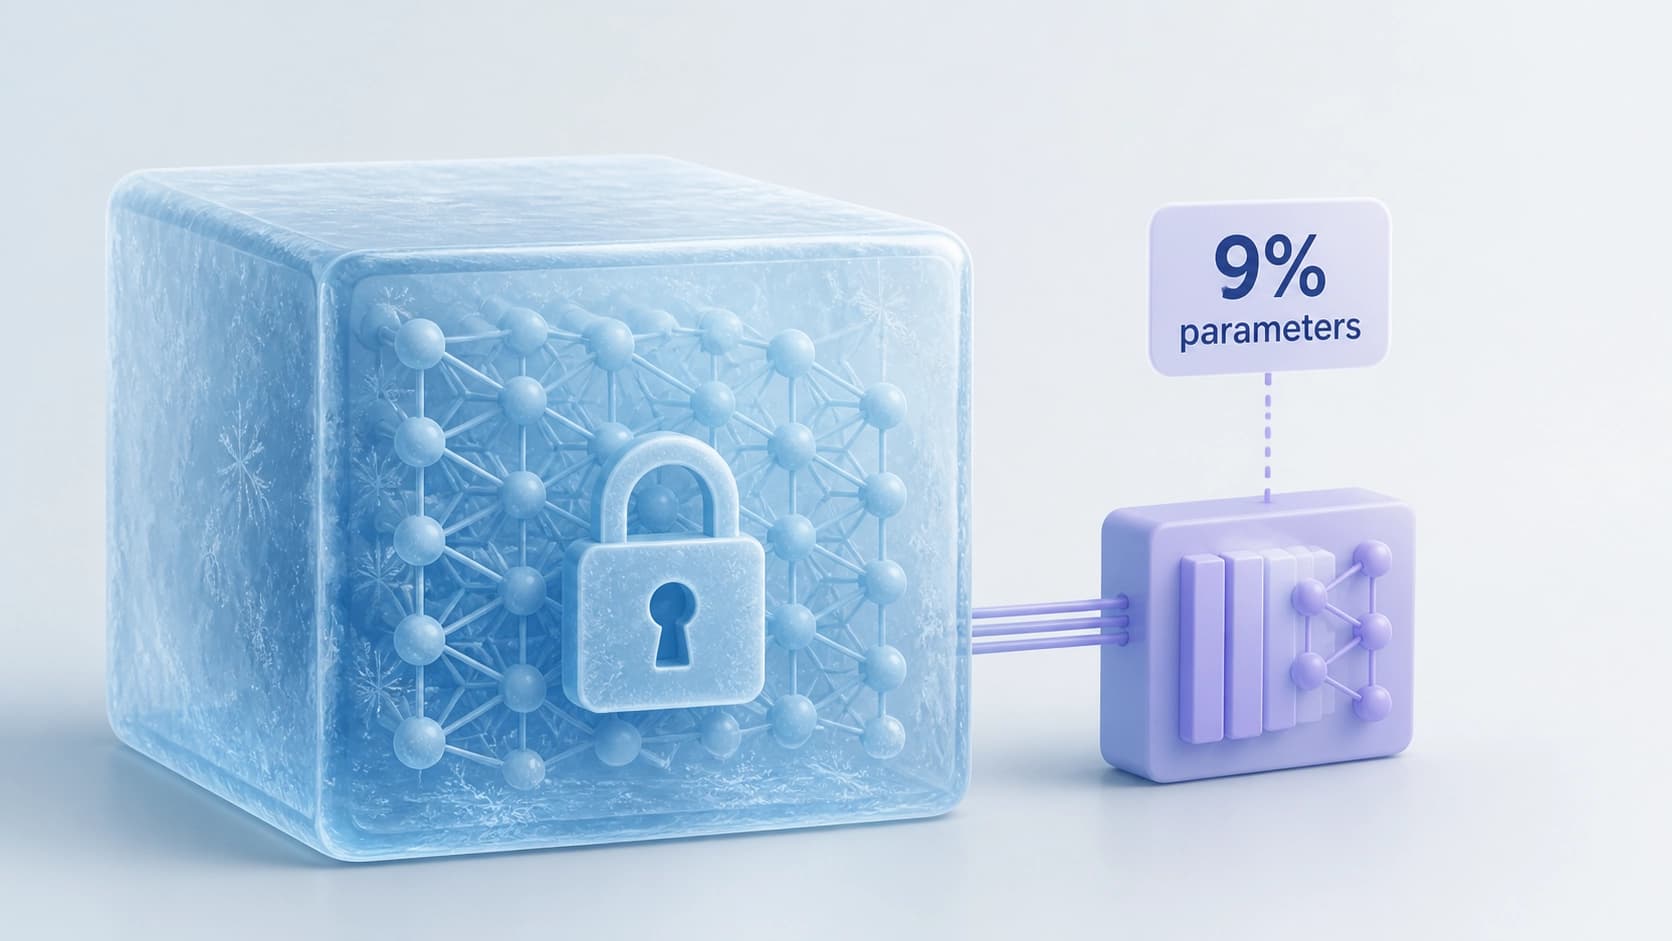
Los autores del preprint son Meghal Dani y Stefanie Liebe. Comprueban un régimen en el que aproximadamente el 9% de los pesos permanecen entrenables, mientras que el resto del modelo queda congelado. La adaptación se realiza de forma autoaprendizante: el modelo no solo se ajusta a las etiquetas de clase, sino que alinea las representaciones internas con la tarea objetivo. El texto se publicó el 25 de agosto de 2026 (versión v1), se clasificó en las secciones cs.LG y cs.AI, DOI — 10.48550/arXiv.2608.24727. El código está abierto para su reproducción.
El sentido no es que haya resultado un modelo "recortado". Es otro modo de explotación: el pesado codificador preentrenado permanece inalterado, y para cada nueva tarea se ajusta un complemento compacto. Para la clínica, esta separación es fundamental — el preentrenamiento costoso se hace una vez, la adaptación barata se repite tantas veces como haga falta.
Dos modelos con distintos objetivos de preentrenamiento
Para que el resultado no dependa de una única arquitectura afortunada, en el experimento participan dos modelos SOTA: BIOT con objetivo contrastivo y CBraMod, entrenado para reconstruir fragmentos enmascarados. Si la técnica funciona en ambos casos, no se trata de una coincidencia, sino de una propiedad del enfoque.
Tres conjuntos clínicos y dos modos de verificación
La evaluación se lleva a cabo en TUAB (detección de anomalías), TUEV (clasificación de eventos) y CHB-MIT (detección de crisis). Las mediciones se hacen dos veces — in-distribution y out-of-distribution, es decir, se comprueba no solo con datos "propios", sino también con una distribución desplazada.
Qué mostraron los resultados
- Frente al sondeo lineal, la adaptación autoaprendizante ofrece una ganancia sostenida — de hasta 20 veces en AUCPR. No es "un poco mejor", sino una diferencia de un orden de magnitud, y se nota especialmente allí donde la clase rara importa más que el accuracy general.
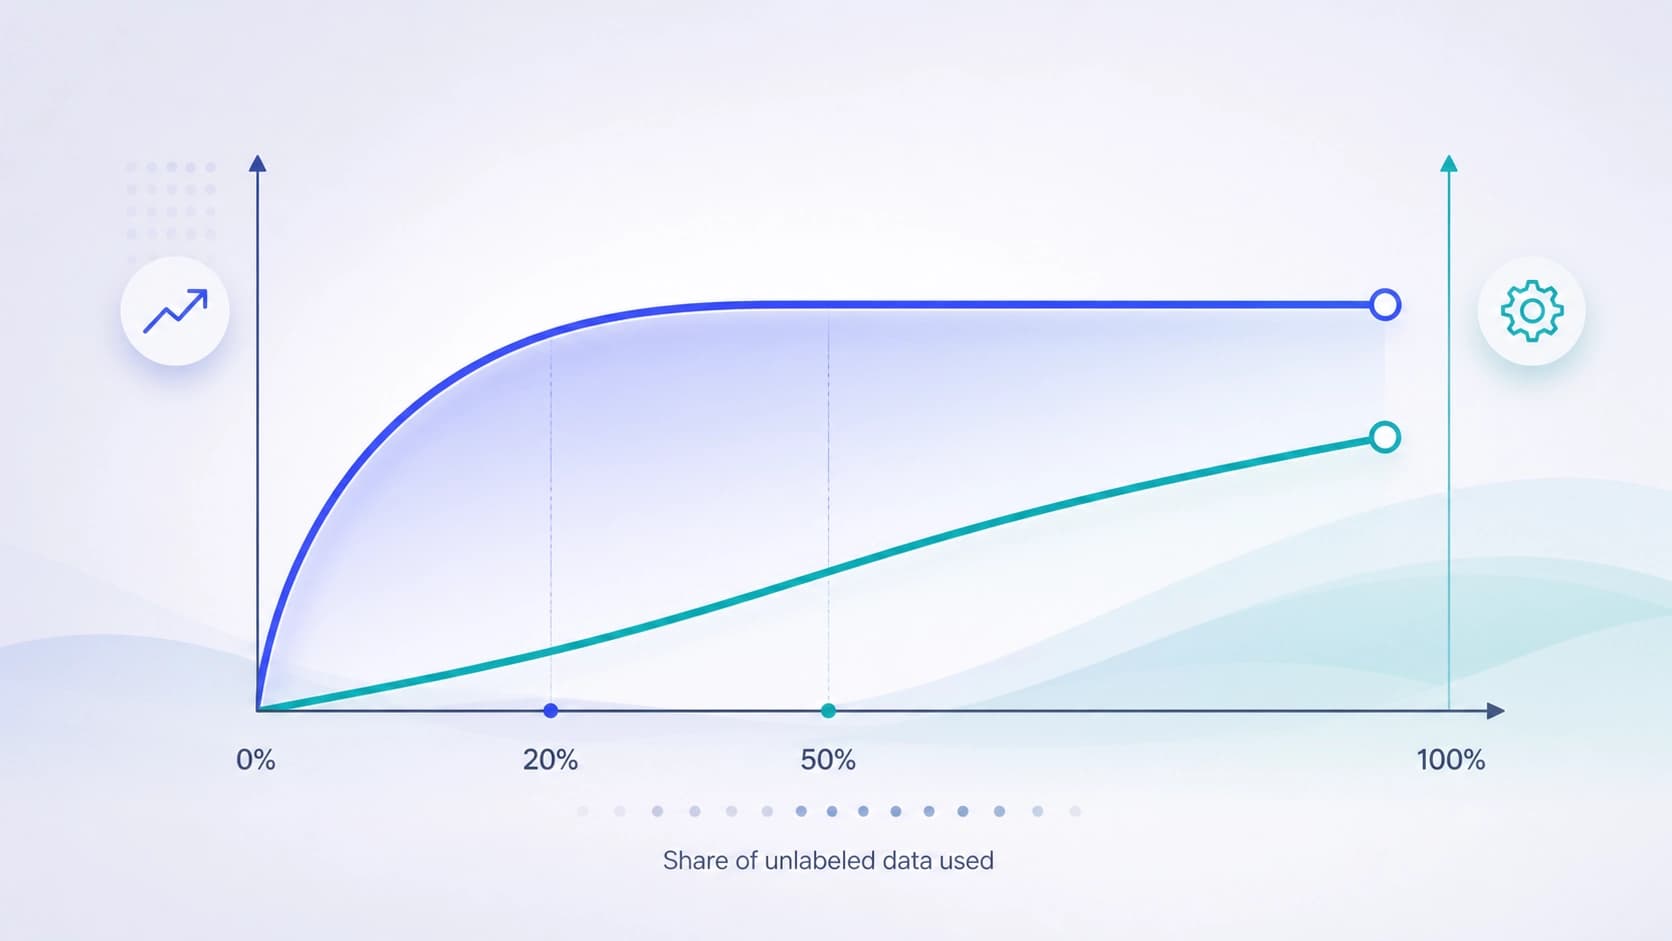
- Con un presupuesto computacional fijo, el pico se alcanza con solo el 20–50% de los registros sin etiquetar disponibles. El resto del corpus ya no aporta ganancia.
- Si el número total de ventanas de señal está fijado, el resultado no depende de cuántos pacientes entren en él. Es decir, lo que funciona no es la "singularidad de las personas", sino la diversidad temporal de los fragmentos: distintos estados, modos y artefactos dentro del registro.
El último punto da la vuelta a la lógica habitual de la recolección de datos. Intuitivamente parece que cuantos más pacientes distintos, más fiable. Aquí, en cambio, resulta que con un límite estricto en el número de ventanas se pueden reunir datos de menos personas — solo hay que vigilar la diversidad de su señal en el tiempo.
Por qué esto cambia el panorama para la clínica
Hasta ahora, la implantación de modelos fundacionales de EEG no chocaba con la calidad de las representaciones, sino con el presupuesto: para obtener provecho de un modelo había que poder permitirse un ajuste completo y un gran corpus etiquetado. El trabajo muestra que esta barrera se puede reducir por dos lados a la vez — en cómputo y en datos. Nueve por ciento de los pesos y la mitad del archivo sin etiquetar en lugar del cien por cien y del volumen completo.
Para un hospital, esto significa un escenario más realista: el modelo se preentrena de forma centralizada, y en el lugar se ajusta para una tarea concreta con equipamiento modesto. Menos dependencia de quién haya reunido más registros, y menos costes de almacenamiento y procesamiento de horas de señal innecesarias.
Qué conviene tener en cuenta
No conviene leer el resultado como "el nueve por ciento siempre es suficiente". Es un régimen concreto de un experimento concreto, no una receta universal para cualquier arquitectura y cualquier conjunto de datos. Los propios autores advierten: la generalización de los modelos de EEG sigue siendo limitada, sobre todo en corpus clínicos heterogéneos. La adaptación eficiente en parámetros no elimina el problema de la transferencia — solo reduce el precio de entrada en ella.
La conclusión práctica es más sencilla de lo que parece: la conversación se desplaza del plano de "si merece la pena siquiera meterse con modelos fundacionales para EEG" al plano de "cómo desplegarlos en el servicio". Y eso ya es una cuestión de ingeniería y de organización del proceso, no solo de aprendizaje automático.