Qué evalúa la simulación
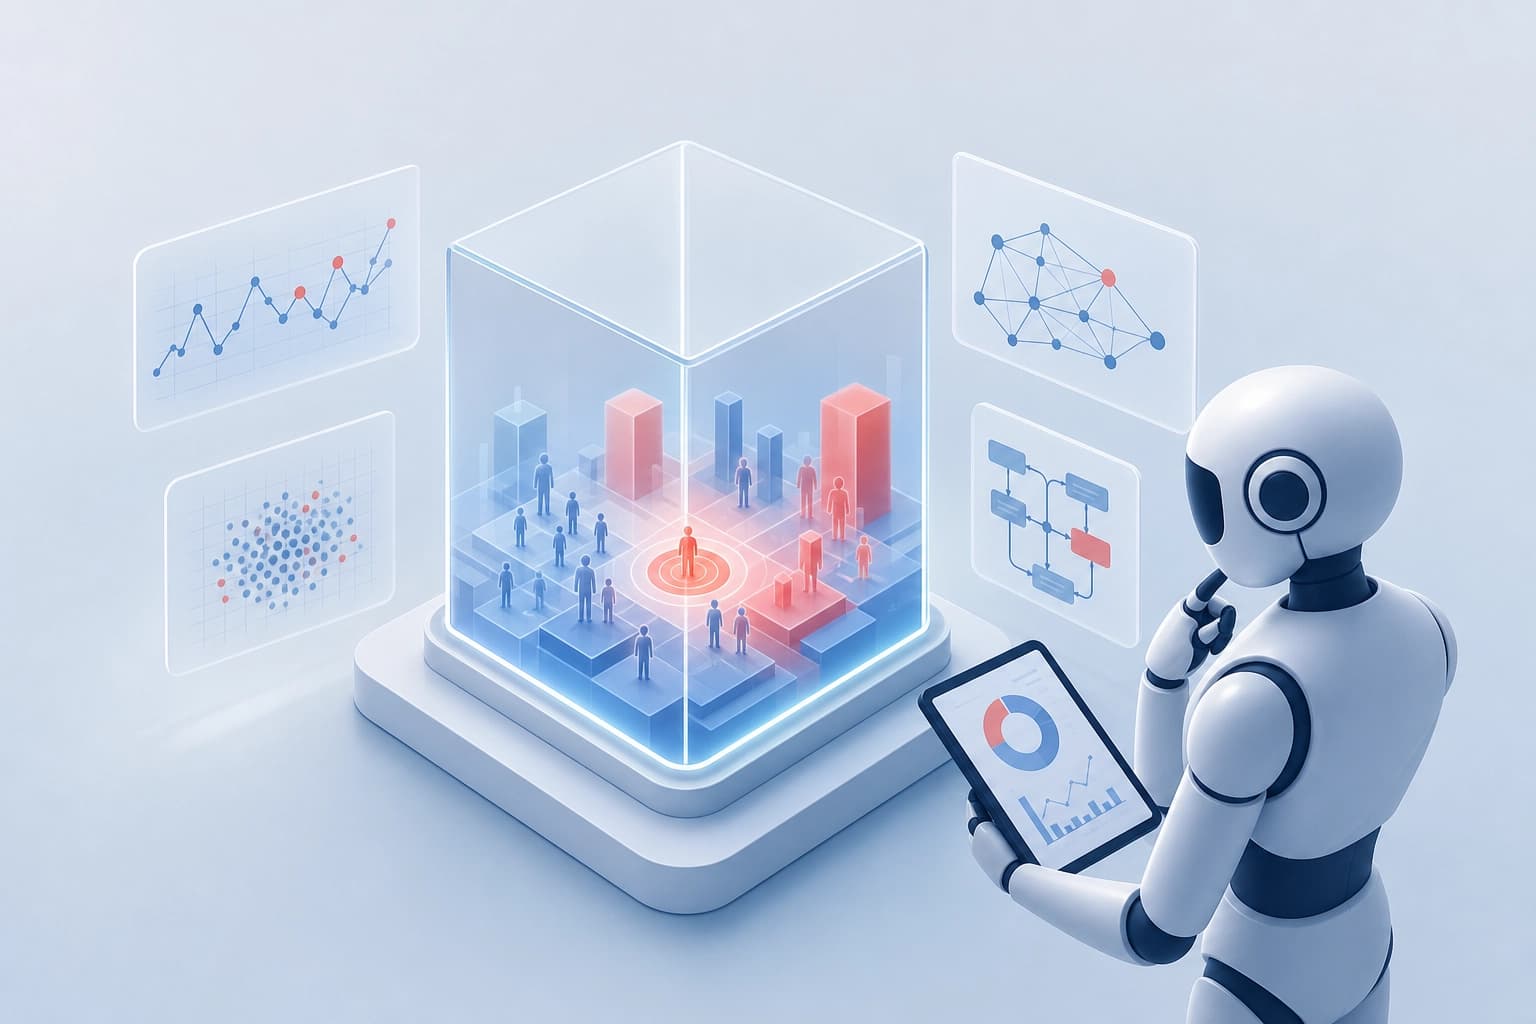
TRACE es un entorno de diagnóstico para la publicidad digital. Abarca 12 causas raíz y una atribución detallada de segmentos. En cada episodio, el agente explora los datos con Python y SQL. Después, identifica la causa raíz y, si corresponde, el segmento afectado.
TRACE se describe en un trabajo de Rui Sun, Zhan Shi y Bing He, presentado en arXiv el 9 de septiembre de 2026. El identificador del trabajo es arXiv:2609.10315.
Cómo se lleva a cabo la evaluación
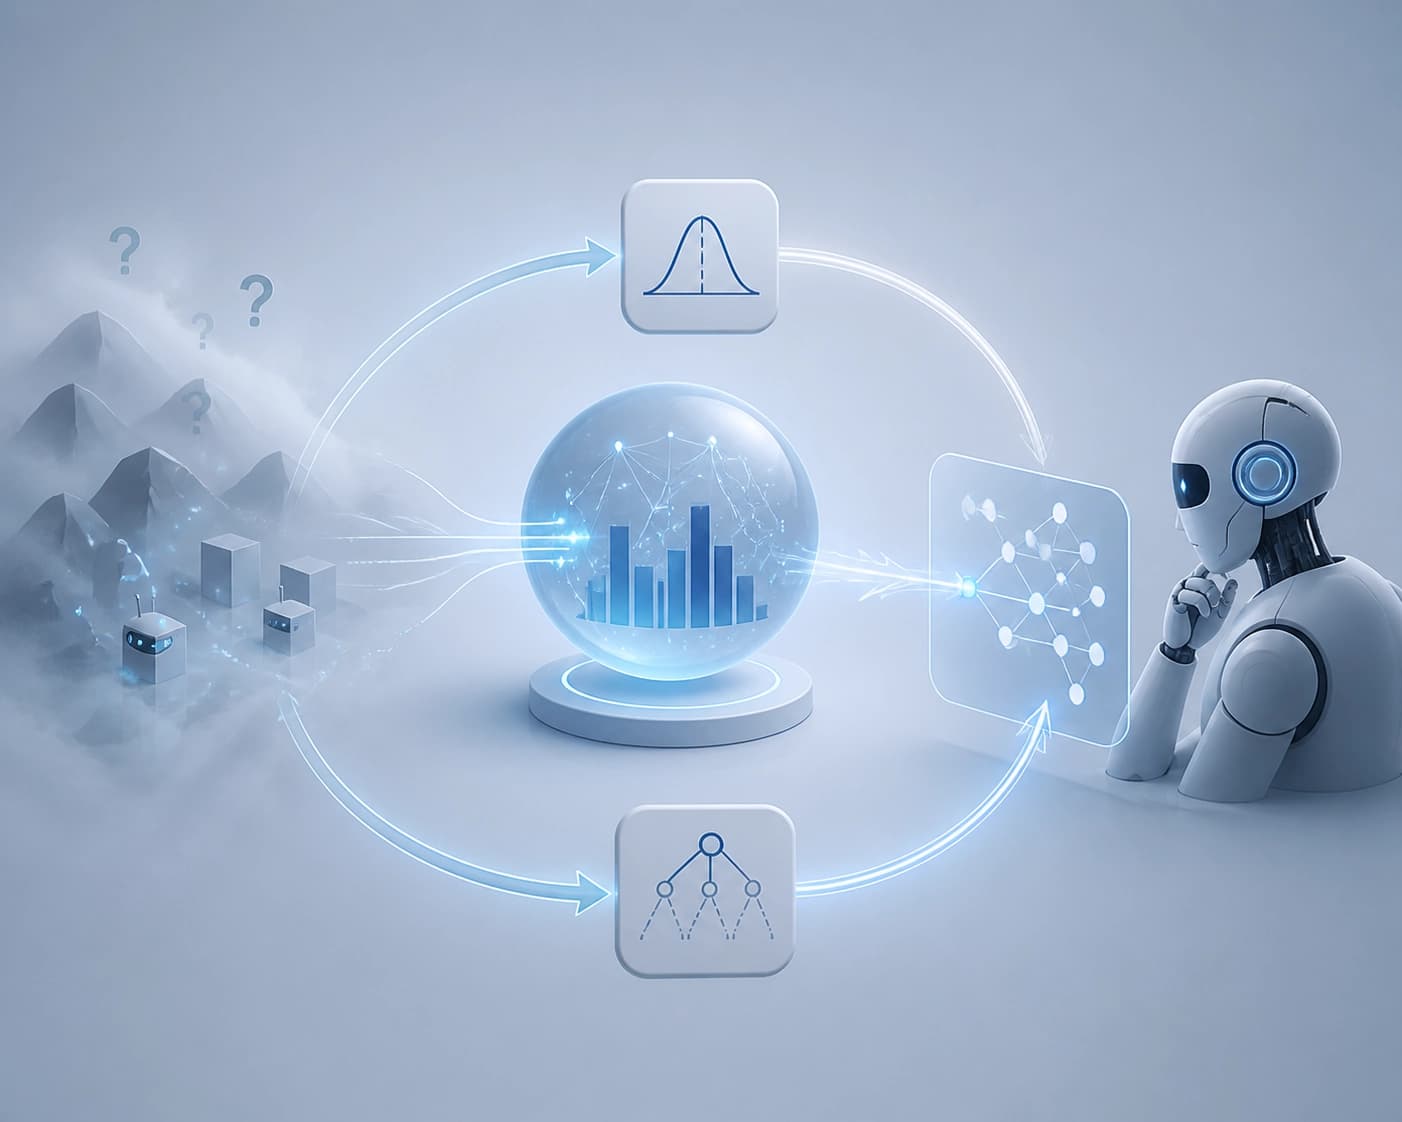
La evaluación se articula en torno a una intervención y las observaciones que esta genera:
- Se elige una intervención y se introduce en un simulador controlado.
- El simulador genera las observaciones correspondientes.
- El agente explora los datos y busca la causa del fallo.
- La intervención oculta sirve como etiqueta de referencia y permite calcular una recompensa objetiva.
El agente no recibe una explicación ya preparada. Debe relacionar indicios ruidosos, mezclados y distribuidos entre los datos. Así, la simulación evalúa la inferencia causal, no solo el reconocimiento de una respuesta predefinida.
Cómo interpretar los resultados
Los autores evaluaron los modelos en un conjunto de prueba reservado de 235 episodios. El mejor baseline de prompting fue Claude Opus 5, con un resultado de 0.686 FullAttr@1.
| Modelo o etapa | Resultado |
|---|---|
| Qwen3.5-35B-A3B después del ajuste fino supervisado | 0.159 → 0.637 |
| El mismo modelo después de RL con recompensas sintéticas | 0.757 |
| Qwen3.5-122B-A10B en el baseline de prompting | Por debajo del resultado de 0.757 |
El resultado de 0.757 superó a todos los baselines de prompting evaluados, incluidos los modelos de frontera de código cerrado. Los autores también informan que la policy obtenida utilizó muchas menos llamadas a herramientas que la versión de prompting del modelo base de 35B.
Qué implican los resultados para el entrenamiento de agentes
Los autores consideran que el acceso a una señal de entrenamiento objetiva y escalable podría ser una limitación más importante que el tamaño del modelo por sí solo. Esta conclusión se basa en los resultados de la tarea descrita y no es una regla universal para todos los sistemas de IA.
Una evaluación mediante simulación puede hacer que las tareas ambiguas de razonamiento diagnóstico sean aptas para el aprendizaje por refuerzo a gran escala. La condición clave es que sea posible comparar la conclusión del agente con la intervención oculta y calcular una recompensa objetiva.
Cuándo conviene este enfoque
La simulación es adecuada para evaluar inferencias causales si la formulación permite:
- definir una intervención e introducirla en un entorno controlado;
- generar observaciones relacionadas con ella;
- conservar la intervención como etiqueta de referencia oculta;
- evaluar tanto la causa raíz como el segmento afectado, cuando corresponda.
Si la tarea no permite esta comparación con una etiqueta de referencia, no se puede garantizar el mecanismo de recompensa objetiva descrito. El criterio práctico para elegir es si se puede verificar la conclusión del agente a partir de la causa oculta sin revelarla durante el análisis.