La ciudad como dominio aparte
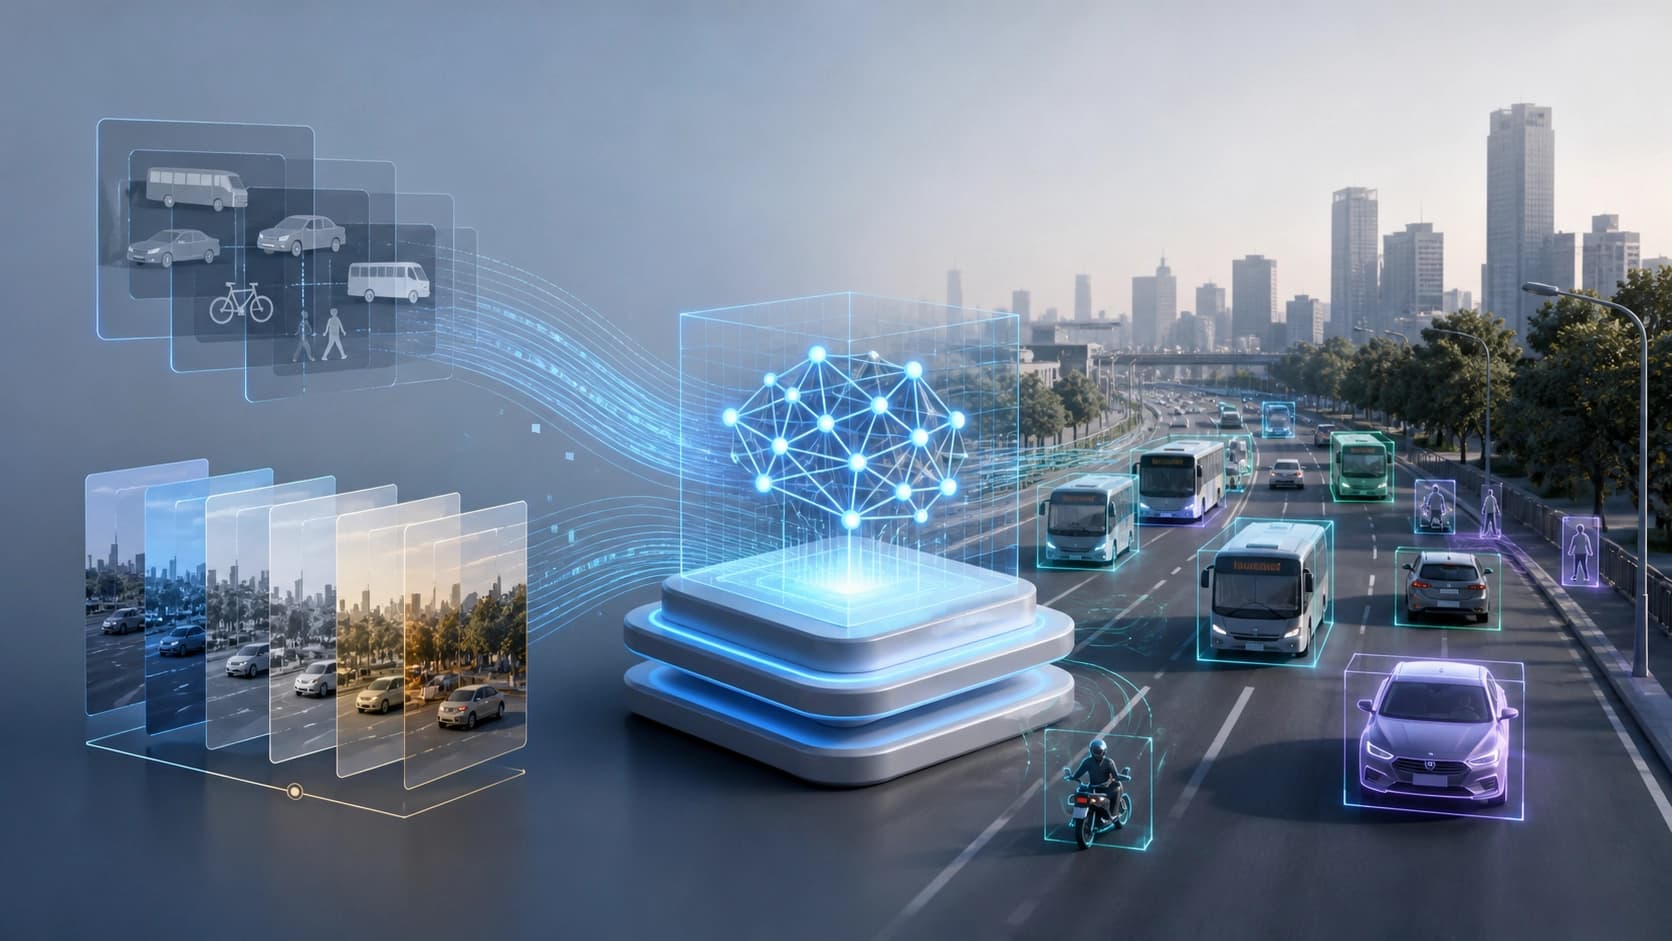
Un detector de coches, semáforos y peatones, entrenado con grabaciones de las cámaras de una ciudad, pierde precisión de forma notable y predecible al trasladarse a otra ciudad. La causa no está en el propio modelo, sino en que cambia literalmente todo a la vez: la iluminación y el balance de blancos de las cámaras, la densidad del tráfico, el trazado de las vías, los colores habituales de las carrocerías e incluso el aspecto de los modelos de transporte típicos. Formalmente esto se denomina desplazamiento de dominio geográfico y, en la práctica, es un dolor de cabeza recurrente para quienes despliegan sistemas de vigilancia de tráfico en varias regiones a la vez.
La salida clásica es la adaptación de dominio. Pero tiene una propiedad desagradable: casi siempre exige o bien un ajuste fino de la arquitectura que se desmorona al cambiar los hiperparámetros, o bien acceso directo a los datos de la ciudad objetivo —perfilarlos, calibrar umbrales con ellos, analizar sus estadísticas—. Y es aquí donde empiezan las restricciones que no son en absoluto de carácter técnico.
Qué significa un ciclo de entrenamiento «a ciegas»
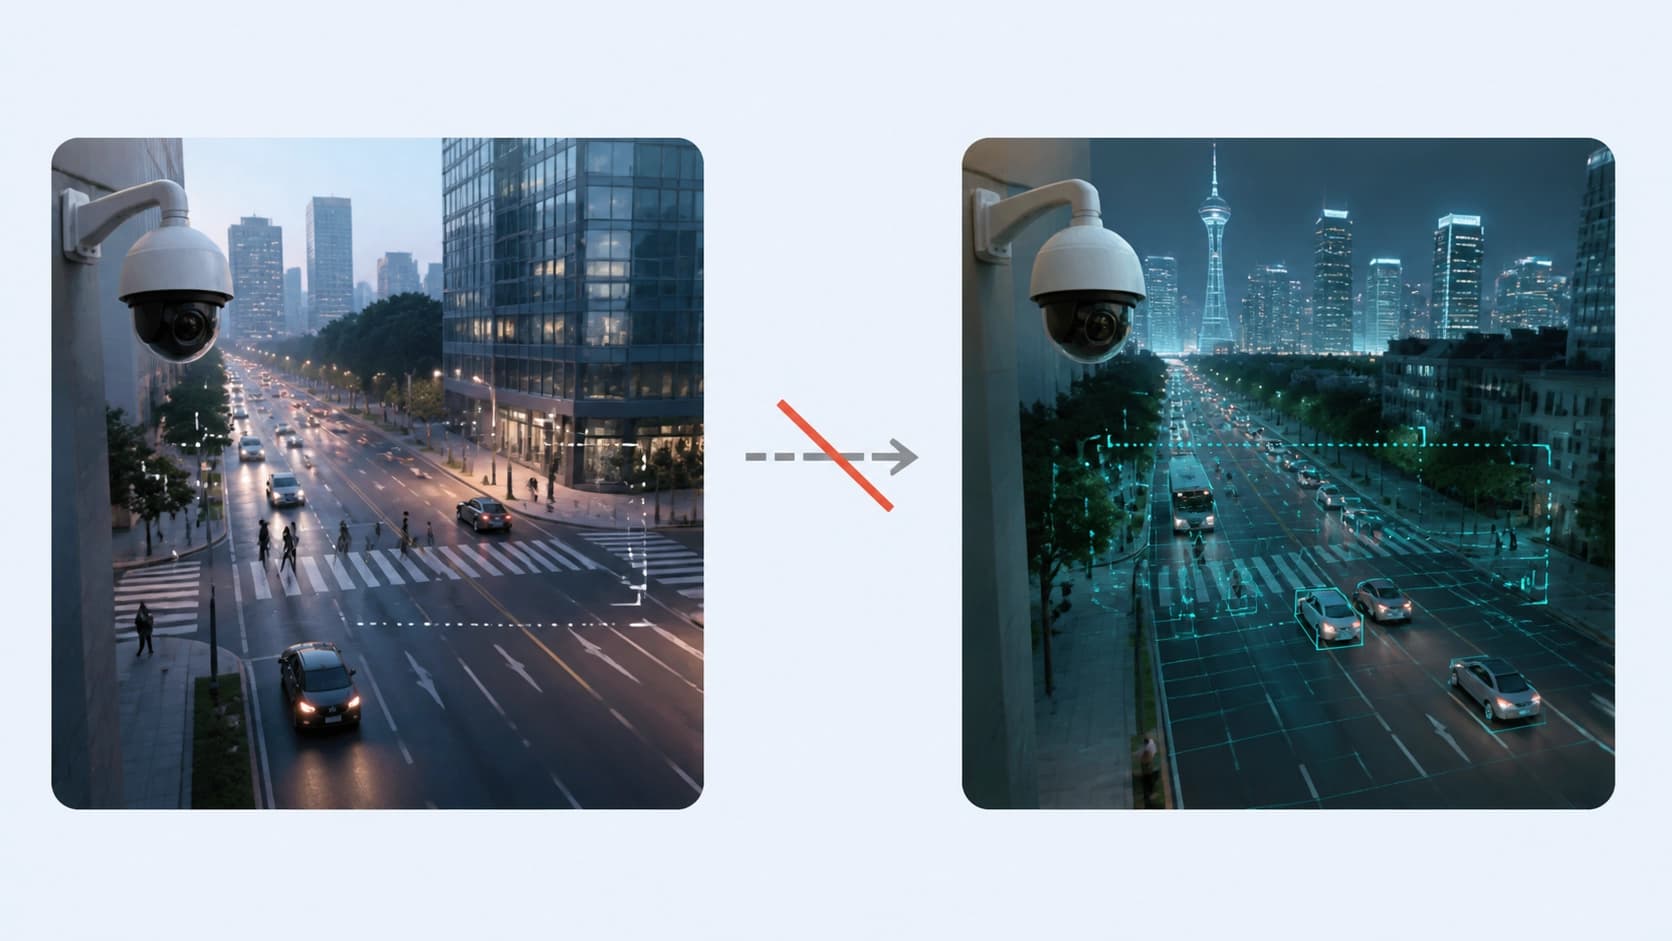
En ecosistemas donde los datos se tratan como información sensible, ambas vías habituales están cerradas por definición. No se pueden exportar fotogramas de la ciudad objetivo a un banco de pruebas de investigación, no se puede construir estadística con ellos, no se puede ajustar el modelo sobre ellos. Solo queda un modo completamente «a ciegas»: el entrenamiento y la evaluación transcurren sin una sola muestra objetivo, y la verificación de calidad solo es posible allí donde ya existe anotación y esta no ha salido del perímetro protegido.
Es precisamente en este marco donde los autores de un nuevo trabajo plantearon su tarea. No les interesa otra capa de adaptación más o menos ingeniosa, sino una pregunta más sencilla y más interesante: cuánto se puede exprimir de lo que ya existe —del preentrenamiento y la aumentación— si se renuncia a cualquier manipulación con los datos objetivo.
Dos pilares ortogonales
El esquema de entrenamiento propuesto para la detección de objetos se apoya en dos mecanismos independientes. La palabra «ortogonales» es aquí clave: no se duplican entre sí y atacan fuentes de error distintas —uno trabaja con la semántica y la estructura del objeto, el otro con aquello a lo que se aferra la atención del modelo.
Preentrenamiento en varios datasets con objectness distillation
El primer pilar es una estrategia de preentrenamiento sobre varios conjuntos de datos a la vez con la denominada class-agnostic objectness distillation. La idea es desacoplar dos cosas que en el entrenamiento habitual van pegadas: la geometría estructural del vehículo y las taxonomías semánticas.
Dicho de forma más simple, el modelo aprende primero a responder a la pregunta «¿hay aquí un objeto de forma característica?», sin entrar en cómo se llama ese objeto en un dataset concreto. Esto importa porque las taxonomías divergen entre conjuntos de datos y entre ciudades: en algunos sitios hay una clase aparte para furgonetas, en otros todo se mete en «vehicle», y los límites entre turismos y camiones se definen de manera distinta. Si el modelo se apoya en una geometría estable y no en convenciones locales sobre las etiquetas, el cambio de ciudad le afecta menos.
Grayworld: obligar a la atención a renunciar al color
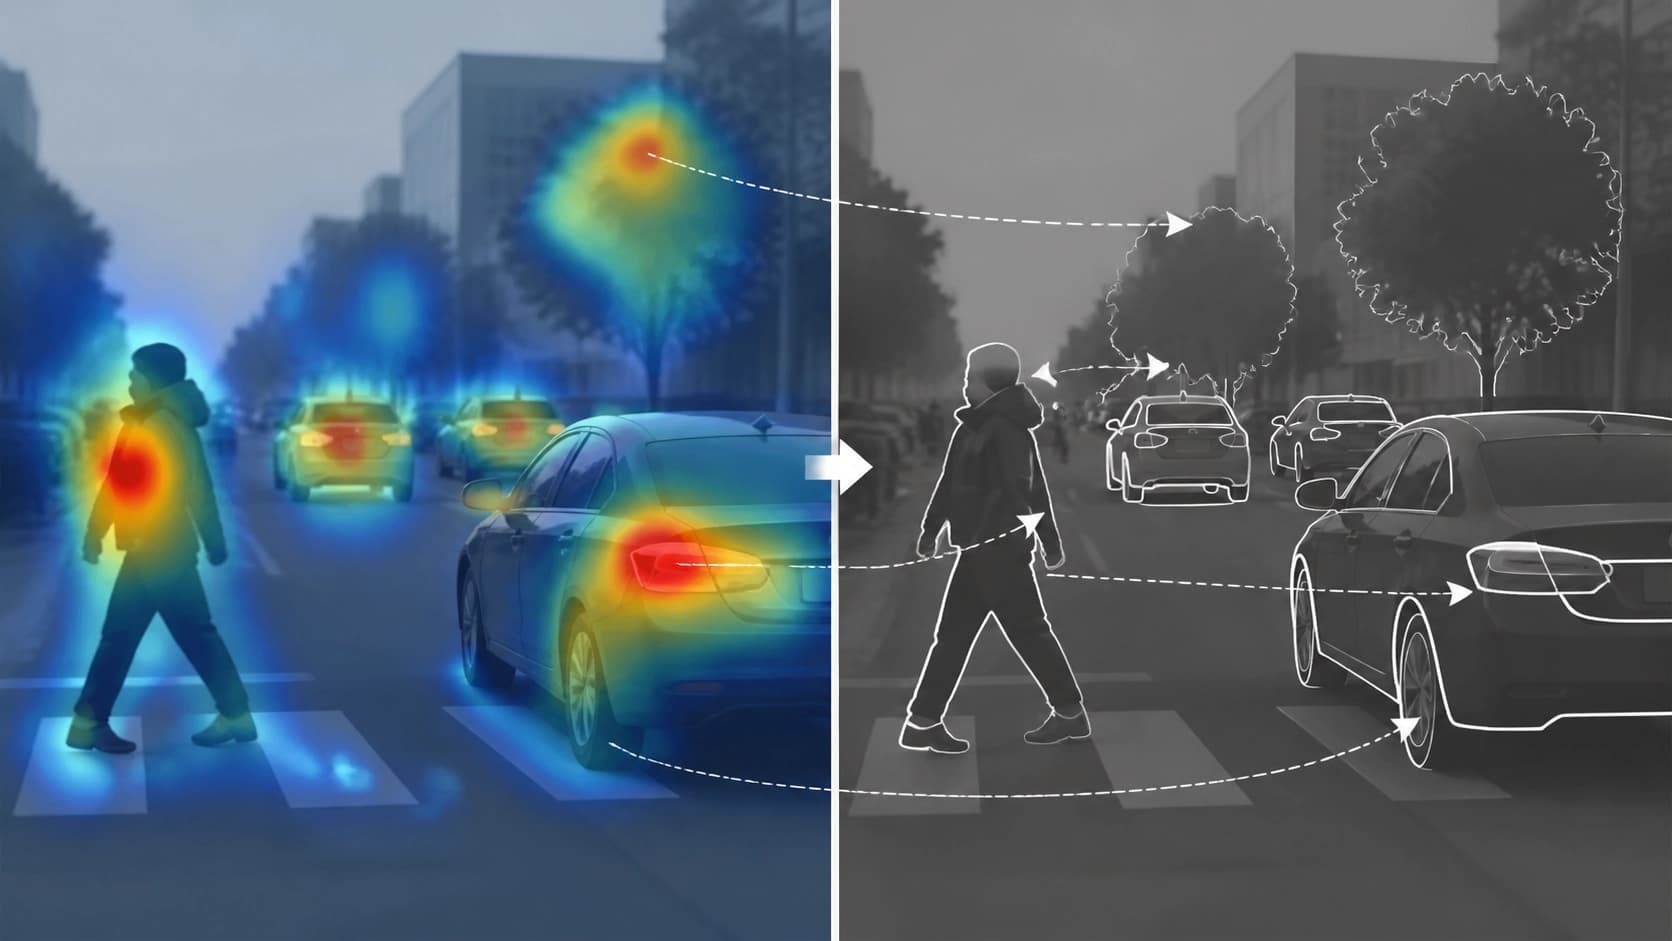
El segundo pilar es un flujo de aumentación robusta al dominio, al que se ha añadido una nueva transformación llamada Grayworld. Su tarea es quitarle terreno al modelo allí donde está acostumbrado a hacer trampa.
Los detectores a menudo encuentran «atajos»: asocian la clase del objeto con el color. Un coche amarillo es un taxi, una silueta roja es un tipo determinado de transporte, un tono específico de cielo o de asfalto es señal de una cámara o una hora del día concretas. Dentro de una misma ciudad esas pistas funcionan, pero al trasladarlas a otra región se desmoronan, porque la reproducción cromática, la luz y los colores habituales allí son otros. Grayworld ataca precisamente esas etiquetas cromáticas, forzando a las cabezas de atención globales a apoyarse en representaciones a priori estables sobre la forma. El color deja de ser una prueba; la geometría permanece.
Experimentos y resultado
La evaluación se llevó a cabo sobre el detector transformer en tiempo real RF-DETR. Los autores subrayan aparte que toda la construcción cabe en un presupuesto modesto de memoria de GPU —16 GB—, es decir, que es reproducible en una estación de trabajo normal, y no solo en un clúster.
Las variantes optimizadas RF-DETR-HR y RF-DETR-Grayworld dieron un incremento de +24.29 respecto al nivel base y ocuparon el primer puesto en la tabla de líderes del AI City Challenge Track 6 con un indicador de 47.53 mAP. Esto ya no es «un poco mejor que la línea base»: es la diferencia entre un detector que en una ciudad nueva es casi inútil y uno que allí funciona.
El trabajo ha sido aceptado en el workshop AI City Challenge en el marco de la conferencia ECCV 2026; el preprint está disponible como arXiv:2608.24154 (cs.CV, cs.AI), y el código y los datos están publicados en el repositorio SKKUAutoLab/aic26_cross_city.
Qué conviene llevarse de aquí a la práctica
Algunas conclusiones útiles más allá del benchmark concreto.
- La aumentación no es cosmética. Es capaz de romper de forma dirigida correlaciones indeseadas si se entiende a qué se aferra exactamente el modelo. Grayworld es un ejemplo de herramienta estrecha pero precisa contra los atajos cromáticos.
- El preentrenamiento se puede diseñar para la transferencia. La objectness class-agnostic y el desacople de la geometría respecto a la taxonomía son un recurso que resultará útil allí donde las clases en los datasets se describen de forma distinta.
- El protocolo «a ciegas» es un planteamiento honesto, no una limitación. Si el método no espía los datos objetivo, su resultado habla de una robustez real y no de la calidad del ajuste.
- El presupuesto de memoria es parte del resultado. El requisito de 16 GB hace que el enfoque sea aplicable en la práctica ingenieril, donde no siempre hay hardware de gama alta.
También es razonable cierta cautela: las conclusiones se obtuvieron con una sola familia de detectores y un solo track de competición, y Grayworld es, al fin y al cabo, una heurística y no una garantía. El desplazamiento geográfico sigue siendo un problema sin una solución universal única, pero ahora queda claro que una parte considerable del progreso se logra incluso antes de que el modelo vea por primera vez una ciudad nueva.