
Por qué merece la pena desglosar los errores del pipeline
Evaluar un sistema RAG con una sola cifra es cómodo, pero casi inútil. Una métrica de extremo a extremo responde a la pregunta «¿acertó la respuesta con lo esperado?», no a la pregunta «¿por qué acertó o falló?». Y es que RAG no es un bloque monolítico, sino una cadena: primero algo se encuentra en la base, luego el sistema decide si lo encontrado es suficiente y solo después el generador escribe el texto. Un fallo en cualquiera de los eslabones produce una respuesta igualmente «incorrecta» a la salida, aunque las causas de dos de esos fallos pueden ser directamente opuestas.
De este problema se ocupa precisamente el trabajo The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, sección cs.CL, enviado el 25 de agosto de 2026). Los autores — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak y Jan Deriu — proponen no medir el pipeline en su conjunto, sino describirlo como un modelo probabilístico en el que cada etapa es una variable aleatoria independiente con sus propias relaciones. A partir de ahí, la evaluación del sistema se convierte en un problema de inferencia: qué valores de las variables latentes explican con mayor verosimilitud las respuestas observadas y el etiquetado.
Qué modela exactamente el marco bayesiano
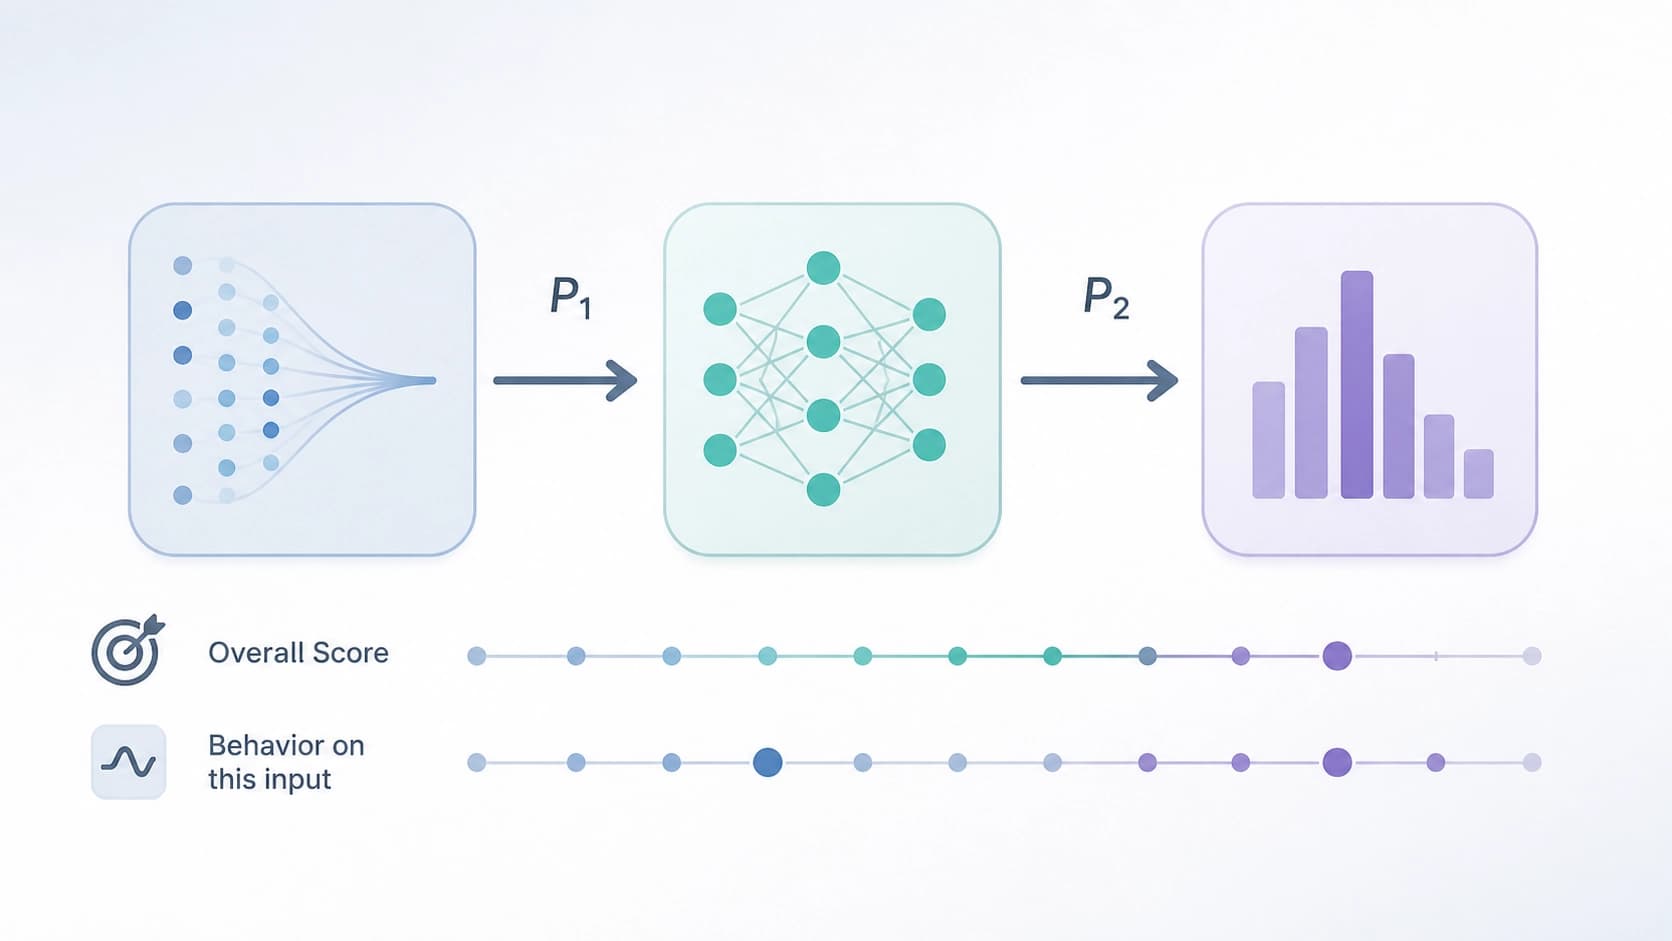
La idea clave es la factorización según el flujo de información. Las variables no se introducen «por componentes del pipeline» de forma mecánica, sino en el orden en que la información se mueve realmente por el sistema: el éxito de la recuperación influye en cómo debe comportarse el generador, y el comportamiento del generador junto con el resultado de la recuperación determina la corrección final de la respuesta. Esta estructura hace explícitas las dependencias, en lugar de esconderlas dentro de una evaluación agregada.
Así, el modelo The RAT obtiene tres capas con contenido propio que normalmente se funden en un único indicador.
Task success y generator success son preguntas distintas
La primera capa es el task success: si el usuario recibió finalmente la respuesta correcta. La segunda es el generator success: si el generador se comportó de forma adecuada dado lo que le tocó recibir a la entrada. Formalmente, lo segundo es calidad condicional: hasta qué punto el comportamiento del modelo es adecuado para ese resultado de recuperación concreto, y no en general.
La diferencia es fundamental. El sistema puede dar una respuesta correcta a pesar de una mala recuperación: el generador acertó por memoria paramétrica. Formalmente es un éxito de la tarea, pero el comportamiento fue incorrecto: el sistema respondió sin apoyarse en las fuentes, y ante otra consulta ese hábito acabará en una alucinación. Y al contrario: la recuperación encontró todo lo necesario, el generador respondió con cuidado, y aun así el resultado es incorrecto porque la pregunta se entendió mal. La métrica de extremo a extremo no distingue estos dos casos; la condicional, sí.
La abstención no es un fallo, sino una decisión
El tercer elemento del modelo es el abstention behavior, el comportamiento de abstención. En el contexto RAG, negarse a responder es a veces la única reacción correcta: si en la base no hay nada relevante, un honesto «no lo sé» es mejor que una invención segura de sí misma. Pero esa misma negativa se convierte en error cuando el documento necesario se había encontrado y el sistema no lo aprovechó.
Por eso la abstención no puede evaluarse al margen del resultado de la recuperación, solo de forma condicional. El modelo The RAT lo tiene en cuenta directamente: observa si el hecho de abstenerse o de responder encaja con lo que realmente había en el contexto. Esta perspectiva también es útil para las decisiones de producto: si el sistema se abstiene masivamente cuando la recuperación ha sido exitosa, el problema no está en el generador, sino en cómo se le hace llegar el contexto.
Por qué engañan las métricas marginales
Los autores aplicaron el marco a 27 configuraciones: son tres conjuntos de datos, tres retriever y tres generadores, combinados en todas sus variantes. La enumeración completa no es aquí un fin en sí mismo: muestra cómo se comporta la descomposición cuando cambia exactamente un eslabón y los demás permanecen igual.
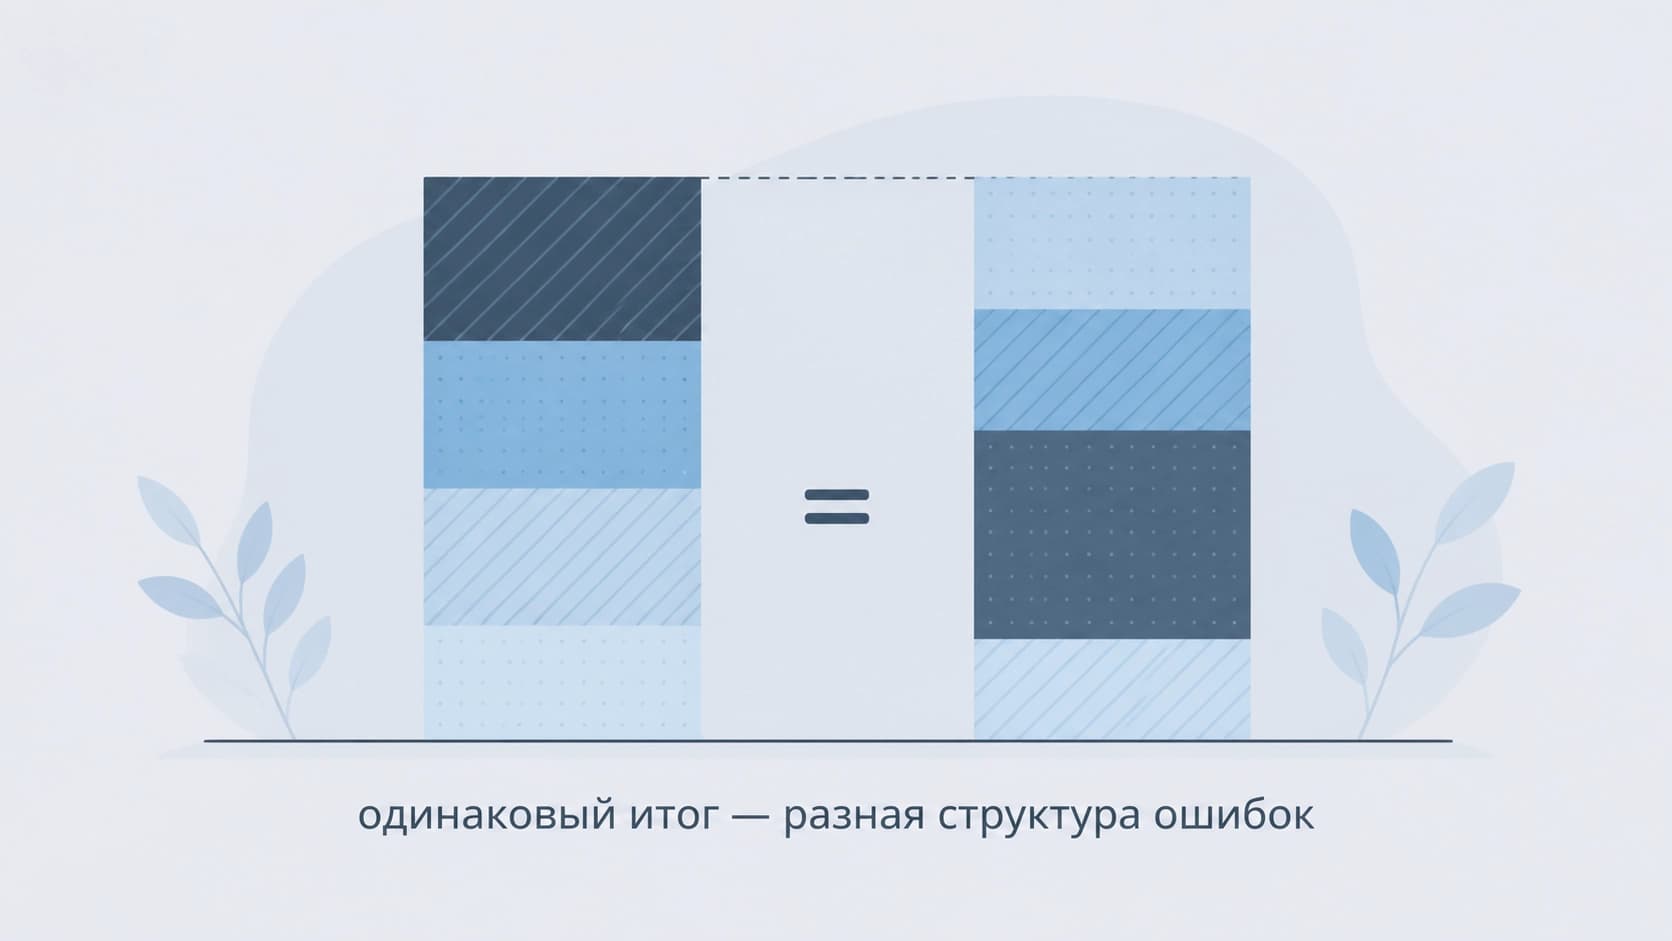
El resultado por el que se hizo todo esto: la descomposición condicional revela diferencias de comportamiento notables entre sistemas que según las métricas marginales parecen equivalentes. Dos pipelines pueden mostrar la misma proporción de respuestas correctas y, aun así, divergir en decenas de puntos porcentuales en cuanto a dónde se equivocan exactamente: en la recuperación, en la política de abstención o en la generación. Para quien elige una configuración para un producto, son sistemas distintos; para quien mira una sola cifra en una tabla, son iguales.
Dónde destinar el presupuesto de etiquetado
Una parte aparte del trabajo está dedicada a la distribución de las anotaciones. El etiquetado es caro, y es lógico preguntarse: si a las personas solo se les puede hacer una pregunta sobre cada ejemplo, ¿qué pregunta elegir?
La respuesta de los autores: las anotaciones sobre el éxito de la recuperación son más informativas que las anotaciones sobre el éxito de la tarea, si el objetivo es juzgar el cumplimiento de la política del sistema (policy adherence). La razón no es la comodidad, sino la estructura del modelo: el etiquetado de la recuperación recae sobre una variable situada al inicio de la cadena causal, por lo que también «ilumina» las capas inferiores. El etiquetado del éxito final corresponde a una variable de salida, y dice mucho menos sobre lo que ocurría dentro. Los autores dan a este efecto asimétrico una explicación desde la teoría de la información.
La conclusión práctica es sencilla: si el presupuesto es limitado, a los anotadores conviene preguntarles no «¿es correcta la respuesta?», sino «¿se encontró lo necesario?». Lo primero suena mejor en un informe; lo segundo es más útil para el diagnóstico.
El juez LLM como observación ruidosa
La tercera parte es la extensión del modelo a las evaluaciones automáticas. El esquema de The RAT permite incorporar los veredictos de LLM-as-a-judge no como sustituto de la persona, sino como observaciones ruidosas calibradas: el juez tiene su propia probabilidad de equivocarse, y esta se estima dentro del mismo modelo probabilístico.
Esto elimina la oposición artificial entre «etiquetado humano caro frente a evaluación automática barata». En un mismo modelo se puede mantener un corpus pequeño de juicios expertos, que fijan la escala y la calibración, y un gran flujo de evaluaciones automáticas, que afinan los parámetros. El juez deja de ser un oráculo y se convierte en una fuente de señal más, con un error conocido y, lo que es importante, medible.
Qué llevarse a la propia práctica
- No consideres el pipeline como un único nodo. En cuanto en el informe aparece una métrica aparte para la recuperación, otra para el comportamiento del generador y otra para la abstención, las discusiones sobre «qué se ha roto» se convierten en diagnóstico, y no en un desfile de hipótesis.
- Evalúa el comportamiento de forma condicional. La corrección de la respuesta y la adecuación del comportamiento dado un contexto son preguntas distintas, y un buen resultado final no justifica un mal proceso.
- Construye el informe por segmentos, no por promedio. Dos sistemas con la misma calidad de extremo a extremo pueden requerir mejoras completamente distintas.
- Elige qué etiquetar. Si el recurso humano es limitado, el etiquetado de las etapas tempranas aporta más información sobre el sistema en su conjunto.
- Mantén las evaluaciones automáticas con correa. El juez LLM es útil como observación con un modelo de error, no como verdad absoluta.
La mirada bayesiana es valiosa aquí no por las matemáticas en sí, sino por la disciplina de pensamiento: obliga a nombrar de antemano qué magnitudes están ocultas, cuáles son observables y cómo se relaciona una con otra. Después de eso, cualquier tabla de resultados deja de ser un conjunto de cifras y se convierte en una descripción de cómo el sistema toma decisiones.


