
Quejas de los datos de entrada pueden interrumpir el funcionamiento de los cascadas de IA energéticamente eficientes.
Los investigadores identificaron tres escenarios de fallo en modelos en cascada ante daños en los datos: ruptura del enrutamiento, degradación de ambos modelos o falsa estabilidad de las predicciones. Esto demuestra que, al evaluar estos sistemas, no se puede confiar únicamente en la precisión — también es importante considerar la robustez del mecanismo de enrutamiento frente a cambios en la distribución.
Cascadas de IA energéticamente eficientes: cuando la corrupción de datos rompe el enrutamiento
Los sistemas de IA modernos se construyen cada vez más no como un único modelo gigante, sino como una cascada de varios modelos de diferentes tamaños. La idea es simple: para consultas sencillas basta con un modelo ligero y rápido, mientras que los casos complejos o ambiguos se derivan a un modelo más grande y preciso para su procesamiento. Este enfoque permite reducir drásticamente el consumo de energía manteniendo al mismo tiempo una alta calidad de las predicciones. Sin embargo, este esquema tiene un punto débil: el enrutamiento, que determina a qué modelo se le confían los datos de entrada.
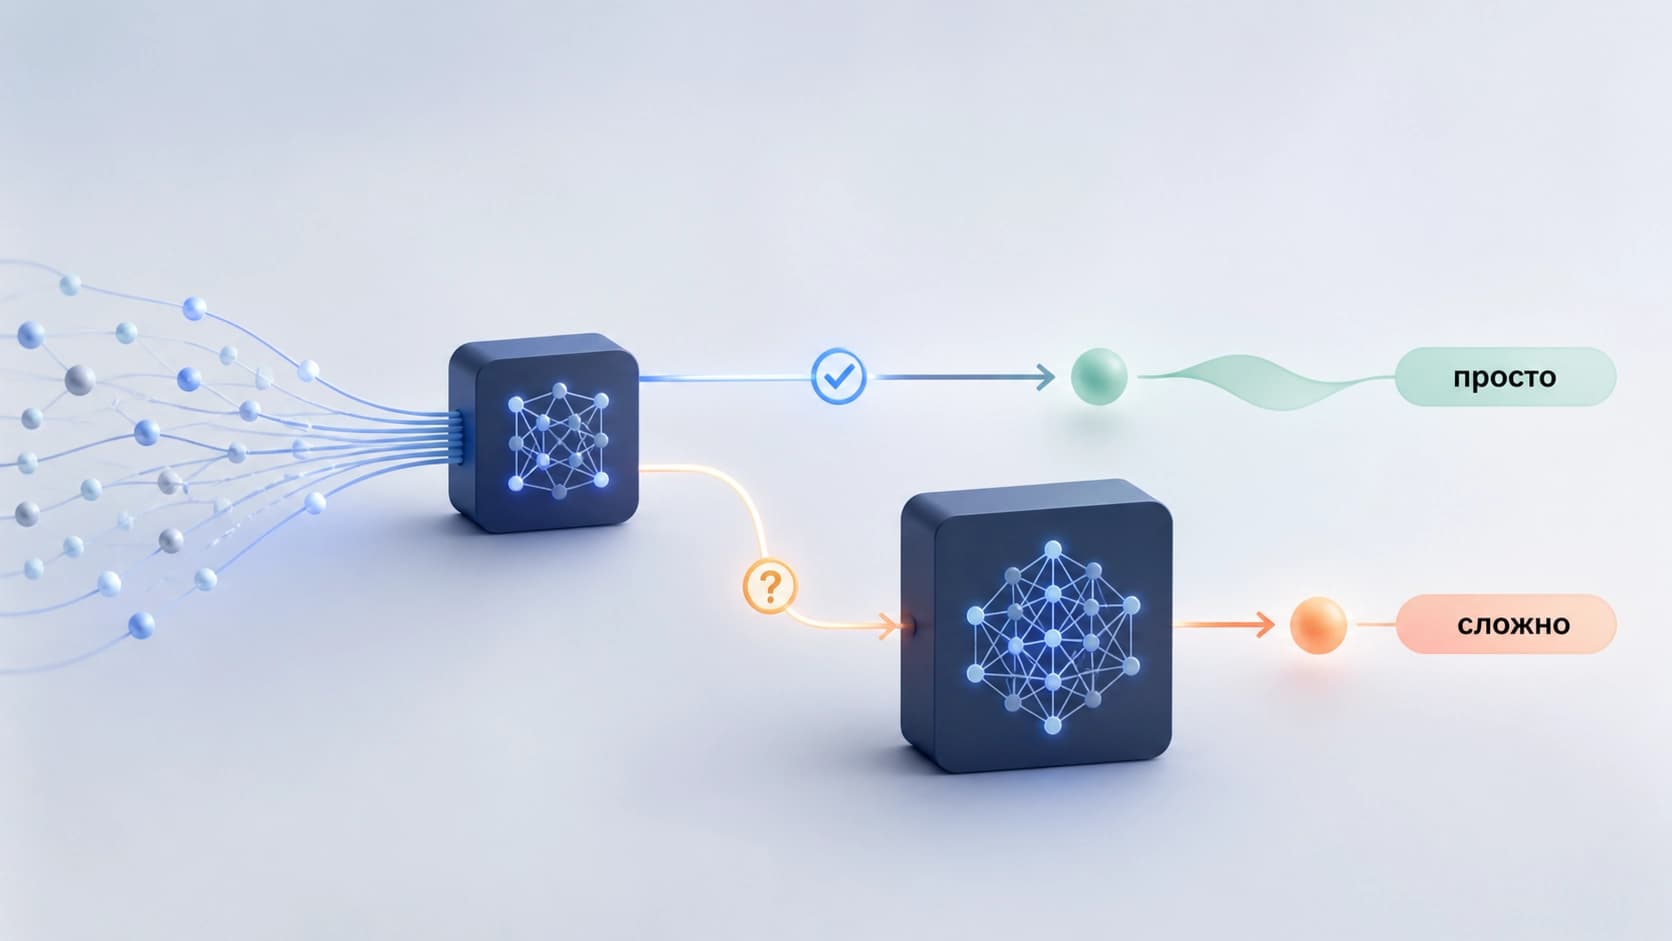
Cómo funciona una cascada de modelos
El elemento clave de la cascada es el mecanismo de diferimiento (deferral) basado en la confianza. El modelo compacto procesa los datos y produce no solo una predicción, sino también una estimación de su propia confianza. Si la confianza es alta, se acepta la respuesta. Si es baja, la muestra se transfiere a un modelo más pesado, que da la respuesta final. Con datos limpios y sin distorsiones, este enrutamiento suele funcionar de forma estable y ofrece un ahorro de energía sin pérdida de precisión.
El problema surge cuando los datos de entrada contienen perturbaciones — por ejemplo, daños estáticos (ruido, recortes, artefactos) o distorsiones secuenciales que cambian de una consulta a otra. Incluso pequeños cambios pueden desplazar la estimación de confianza del modelo y, con ella, la decisión sobre si enviar la muestra más adelante en la cascada.
Qué mostró la investigación
El reciente trabajo «Accuracy and Robustness of Model Cascades Under Data Perturbations» (autores — Pallavi Mitra, Jai Kushwaha, Felix Biessmann, aceptado en el GREEN-AI Workshop at ECML-PKDD 2026) se centra precisamente en la robustez de estas cascadas ante perturbaciones. Los autores construyeron una cascada de modelos para clasificación de imágenes, eligiendo una configuración en el óptimo de Pareto en cuanto a precisión, calidad de enrutamiento y consumo de energía. Esta configuración, con datos limpios, demuestra un rendimiento predictivo competitivo y, además, reduce las emisiones de CO₂ hasta 10 veces en comparación con el uso exclusivo del modelo grande. Sin embargo, al dañar artificialmente los datos de entrada, el comportamiento de la cascada cambia notablemente — y no siempre en la dirección esperada.
Tres modos de fallo
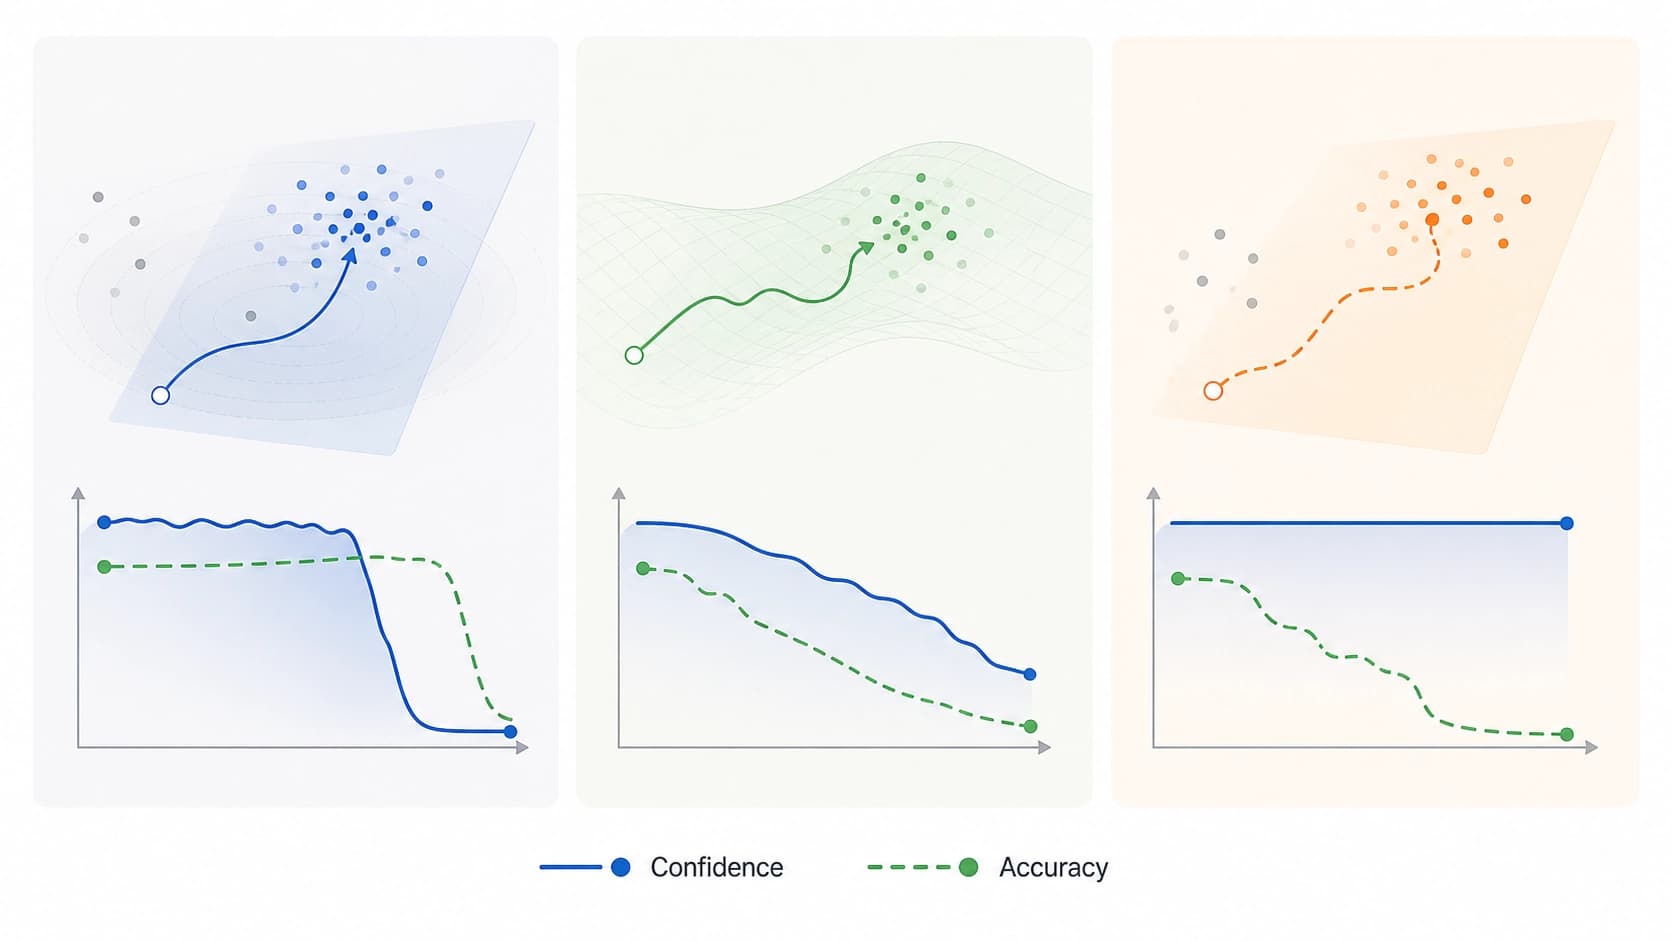
El análisis mostró que las perturbaciones conducen a tres escenarios característicos, cada uno de los cuales rompe el funcionamiento normal de la cascada a su manera.
Primer modo: se rompe la señal de enrutamiento. Los daños estáticos pueden hacer que la estimación de confianza sea prácticamente inútil. El modelo compacto no comprende que los datos están corruptos y, con alta confianza, produce una respuesta incorrecta o, por el contrario, envía todo hacia arriba sin distinción. En este caso, el modelo grande sigue siendo capaz de corregir errores, pero se pierde la ventaja energética — la cascada degenera en un simple procesamiento secuencial.
Segundo modo: fallan ambos modelos. A veces los daños empeoran el rendimiento no solo del modelo ligero, sino también del grande. Entonces el mecanismo de diferimiento deja de ayudar: incluso después de transferir el caso difícil hacia arriba, la precisión no se recupera. En la práctica, la cascada no mejora a ninguna de sus partes, y el consumo de energía sigue siendo alto.
Tercer modo: estabilidad en lugar de fiabilidad. Este escenario surge con perturbaciones secuenciales, cuando las distorsiones se acumulan o cambian de una consulta a otra. Los modelos comienzan a producir predicciones estables — pero establemente incorrectas. Además, el mecanismo de diferimiento se suprime: el sistema confía en sus respuestas, aunque sean erróneas. Este caso es el más peligroso, porque el error es difícil de detectar observando el comportamiento de la cascada.
Por qué es importante
La conclusión de los investigadores es directa: evaluar las cascadas energéticamente eficientes solo por su precisión en datos limpios no es suficiente. Es necesario considerar explícitamente cómo se comportará el enrutamiento ante un cambio en la distribución de los datos de entrada. En la operación real, los datos casi siempre difieren de los de entrenamiento — debido a cambios de iluminación, ruido en las fotografías, nuevos formatos o ataques al modelo. Si la cascada no se ha probado en cuanto a la robustez de su enrutamiento, su eficiencia energética se convierte en una ilusión.
Para los profesionales, esto significa que al implementar arquitecturas en cascada conviene incluir en las pruebas no solo muestras ideales, sino también daños sintéticos de diferentes tipos. De lo contrario, se puede obtener un sistema que ahorra energía solo hasta el primer encuentro con el mundo real — y luego emite silenciosamente decisiones seguras pero incorrectas.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026