

HierSpeech++
Red neuronal para síntesis de voz y clonación con intonaciones naturales y coloración emocional.
Examen
HierSpeech++
Descripción de la red neuronal HierSpeech+
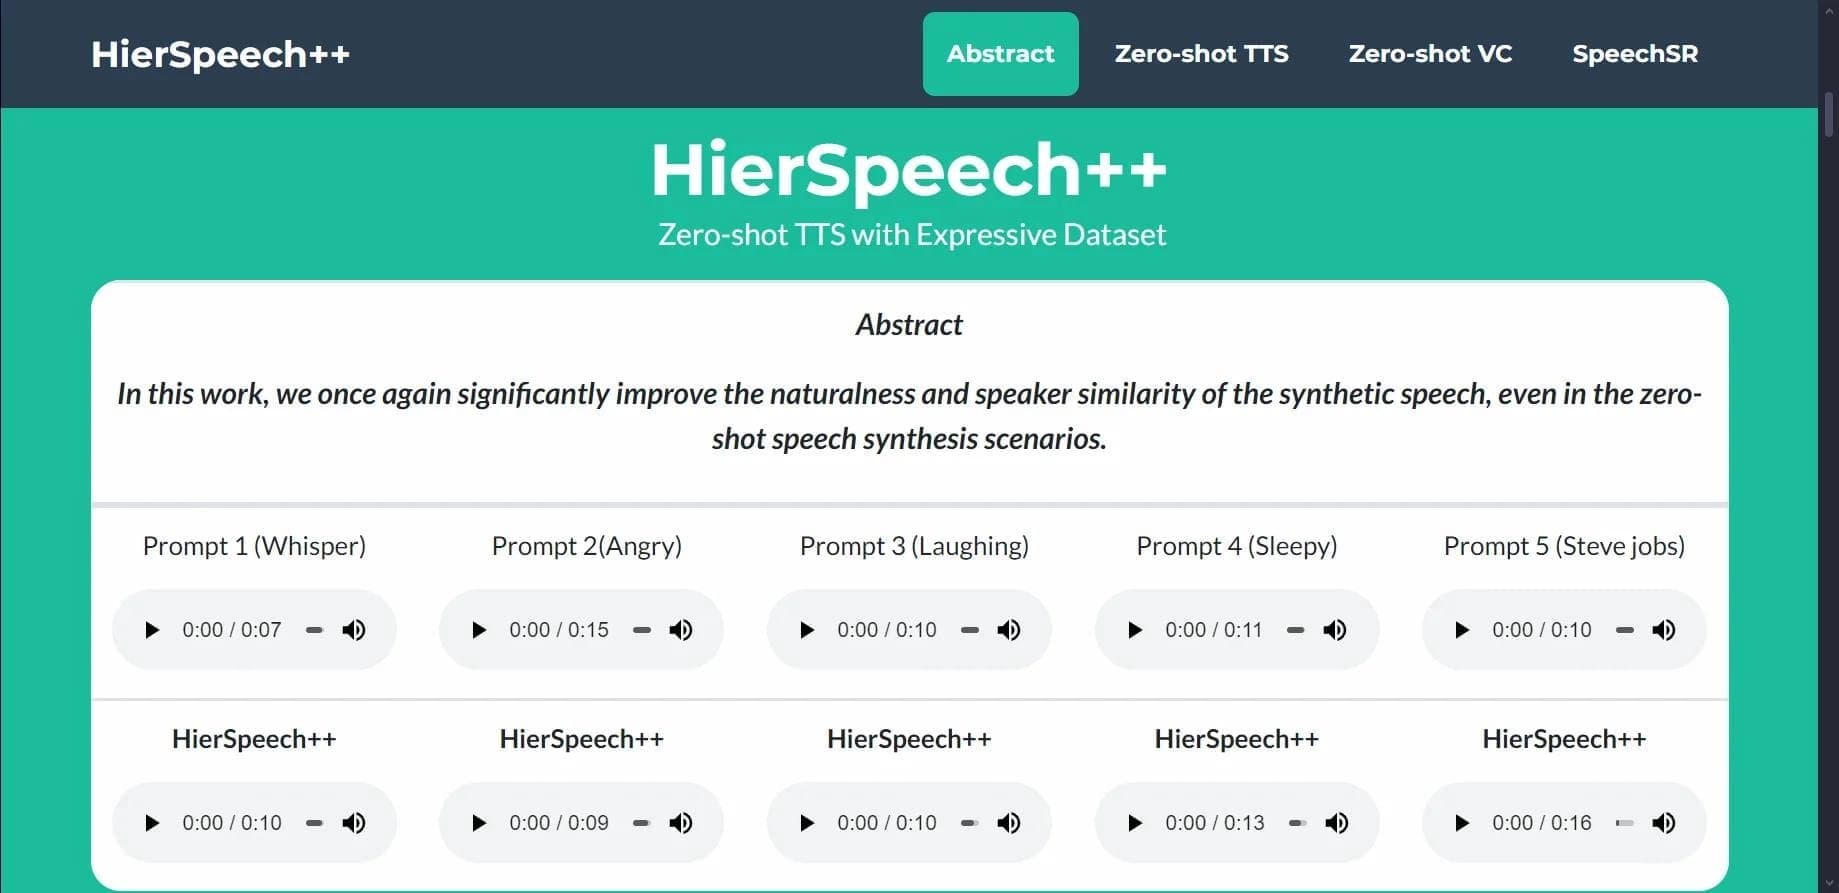
HierSpeech++ es una red neuronal diseñada para la síntesis del habla y la clonación de voz. La característica principal de la herramienta es un enfoque jerárquico del procesamiento de datos, que alcanza un alto nivel de naturalidad en el sonido, incluyendo intonaciones vivas y coloración emocional.
La tecnología no funciona con una representación plana de texto y audio, sino que construye una estructura de procesamiento multinivel. Esto permite que el modelo reproduzca con más precisión los matices del discurso humano: pausas, estrés y cambios en el timbre dependiendo sobre el contexto. El modelo admite varios idiomas, incluido el ruso, que amplía su alcance para proyectos locales.
Características HierSpeech++
| Características | Valor |
|---|---|
| Tipo | Red neuronal para la síntesis del habla |
| Categoría | Voces y voz, generación de voz |
| Apoyo al idioma ruso | Sí. |
| Sitio web | sh-lee-prml.github.io |
| Modelo de distribución | No especificado |
¿Quién es la red neuronal HierSpeech++ adecuado para?
Usuarios regulares
La herramienta está diseñada para aquellos que necesitan voz rápida texto sin una configuración compleja. Simplemente suba el contenido, seleccione los parámetros y consiga un archivo de audio listo con una voz natural.
Desarrolladores de productos comerciales
HierSpeech+ es adecuado para la integración en asistentes virtuales, plataformas multimedia y otras aplicaciones que requieren generación de voz. La arquitectura del modelo permite adaptarse a casos específicos de uso.
¿Cómo utilizar la red neuronal HierSpeech++?
Preparación de datos
Para empezar, necesita subir contenido de texto y, si es necesario, archivos de audio para la formación de modelos. Esto le permite personalizar la voz para tareas específicas.
Sintesis de ejecución
Después de subir los datos, necesita definir el modelo de idioma y el estilo de habla. Luego comienza el proceso de síntesis.
Ajuste del resultado
Después de la generación, la intonación y la configuración de timbre están disponibles. Usted puede hacer cambios a la voz resultante hasta alcanzar el resultado deseado.
Características clave de HierSpeech++
- síntesis de discursos de alta calidad — generación de voz limpia e inteligible sin artefactos.
- Apoyo a varios idiomas — incluido el ruso, que hace universal el modelo.
- Ajuste del estilo y la intonación — la capacidad de cambiar la naturaleza de la pronunciación a encajar en el contexto.
- Modelo de emociones y características de voz individuales — creación de perfiles de voz únicos.
- algoritmos de aceleración de generación eficiente — tiempo de procesamiento reducido sin pérdida de calidad.
Ventajas de HierSpeech++
Naturalidad de la síntesis
El uso de un enfoque jerárquico para el procesamiento de datos permite reproducir con precisión el discurso. Intonaciones y matices emocionales suenan naturales, lo que distingue favorablemente el modelo de sistemas TTS simples.
Adaptabilidad
La herramienta admite diferentes casos de uso: desde el contenido de vídeo voicing para crear interfaces de voz. La integración en aplicaciones abre oportunidades para la automatización de procesos.
Multilingüismo
El apoyo al idioma ruso es una ventaja importante para los usuarios de habla rusa. El modelo no se limita a un idioma, que expande su audiencia.
Desventajas de HierSpeech++
Las fuentes disponibles no enumeran ninguna limitación explícita o inconvenientes de la herramienta. Vale la pena señalar que se pueden requerir muestras de audio de alta calidad para el entrenamiento para trabajar plenamente con la clonación de voz. Además, el modelo se distribuye como un proyecto de investigación abierto, por lo que el apoyo comercial y la documentación pueden ser limitados.
¿Qué tareas resuelve HierSpeech++?
- Texto a palabra — convertir contenido escrito en audio.
- Generación de discursos y conversión — crear nuevos modelos de voz basados en datos existentes.
- Crear modelos de voz realistas — sintetizador de voz con coloración emocional para uso en multimedia y asistentes.
Precio HierSpeech++
La información sobre el costo del uso del modelo no se revela en fuentes abiertas. El modelo se distribuye como un proyecto de investigación, que implica el libre acceso para las pruebas. Para uso comercial, necesita aclarar los términos con los desarrolladores.
Términos de uso para HierSpeech++
Las condiciones exactas de licencia y uso comercial no se describen en las fuentes disponibles. El modelo está disponible para pruebas a través de un sitio demo público, que le permite evaluar sus capacidades antes de integrarlo en sus propios proyectos.
Disponibilidad de HierSpeech++
La red neural trabaja con el idioma ruso y está disponible a través de un enlace a un sitio demo en GitHub Pages (sh-lee-prml.github.io). Esto significa que puede probar la herramienta directamente en su navegador sin instalar software adicional.
Cómo HierSpeech+ difiere de alternativas
Arquitectura jerárquica
A diferencia de muchas soluciones que utilizan la generación de audio directa del texto, HierSpeech++ aplica procesamiento multinivel. Esto hace posible lograr una reproducción más precisa de las intonaciones y emociones.
Centrarse en la naturalidad
El modelo pretende crear una voz difícil de distinguir de una persona humana. Esto se logra modelando las características individuales del habla y ajustando el estilo a tareas específicas.
Conclusión
HierSpeech+ es una red neuronal funcional para la síntesis del habla con énfasis en la calidad del sonido y la naturalidad. El procesamiento de datos jerárquicos, el apoyo al idioma ruso y la capacidad de ajustar las intonaciones hacen que sea adecuado tanto para el texto simple como para la integración en los productos comerciales. La herramienta está abierta para la prueba, lo que le permite evaluar sus capacidades antes del uso a gran escala.
Preguntas frecuentes
Redes neuronales similares

Vea también

Secretario de AI para grabación automática de reuniones y transcripción con la generación de tareas y mapas mentales.

Herramienta AI para la creación rápida y rediseño de sitios sin código.
Una plataforma para mejorar las capacidades de los sistemas distribuidos.
Plataforma AI para transcribir audio y vídeo con soporte para más de 100 idiomas subtítulos.
Generador de vídeo AI que sincroniza la animación con acompañamiento musical.

Plataforma para la creación de sitios web de aplicación web y descripción de texto con AI.

Servicio de grabación de audio y vídeo para 98 idiomas y exportaciones a diferentes formatos.

Herramienta para el análisis de los comandos basados en datos de las actividades de ingeniería de los repositorios y los rastreadores de tareas.