
WILSON: রোগীর প্যাথোমরফোলজিক্যাল বিশ্লেষণ ও রিপোর্ট তৈরির জন্য ম্যাগনিফিকেশন ও স্লাইড একত্রিত করা
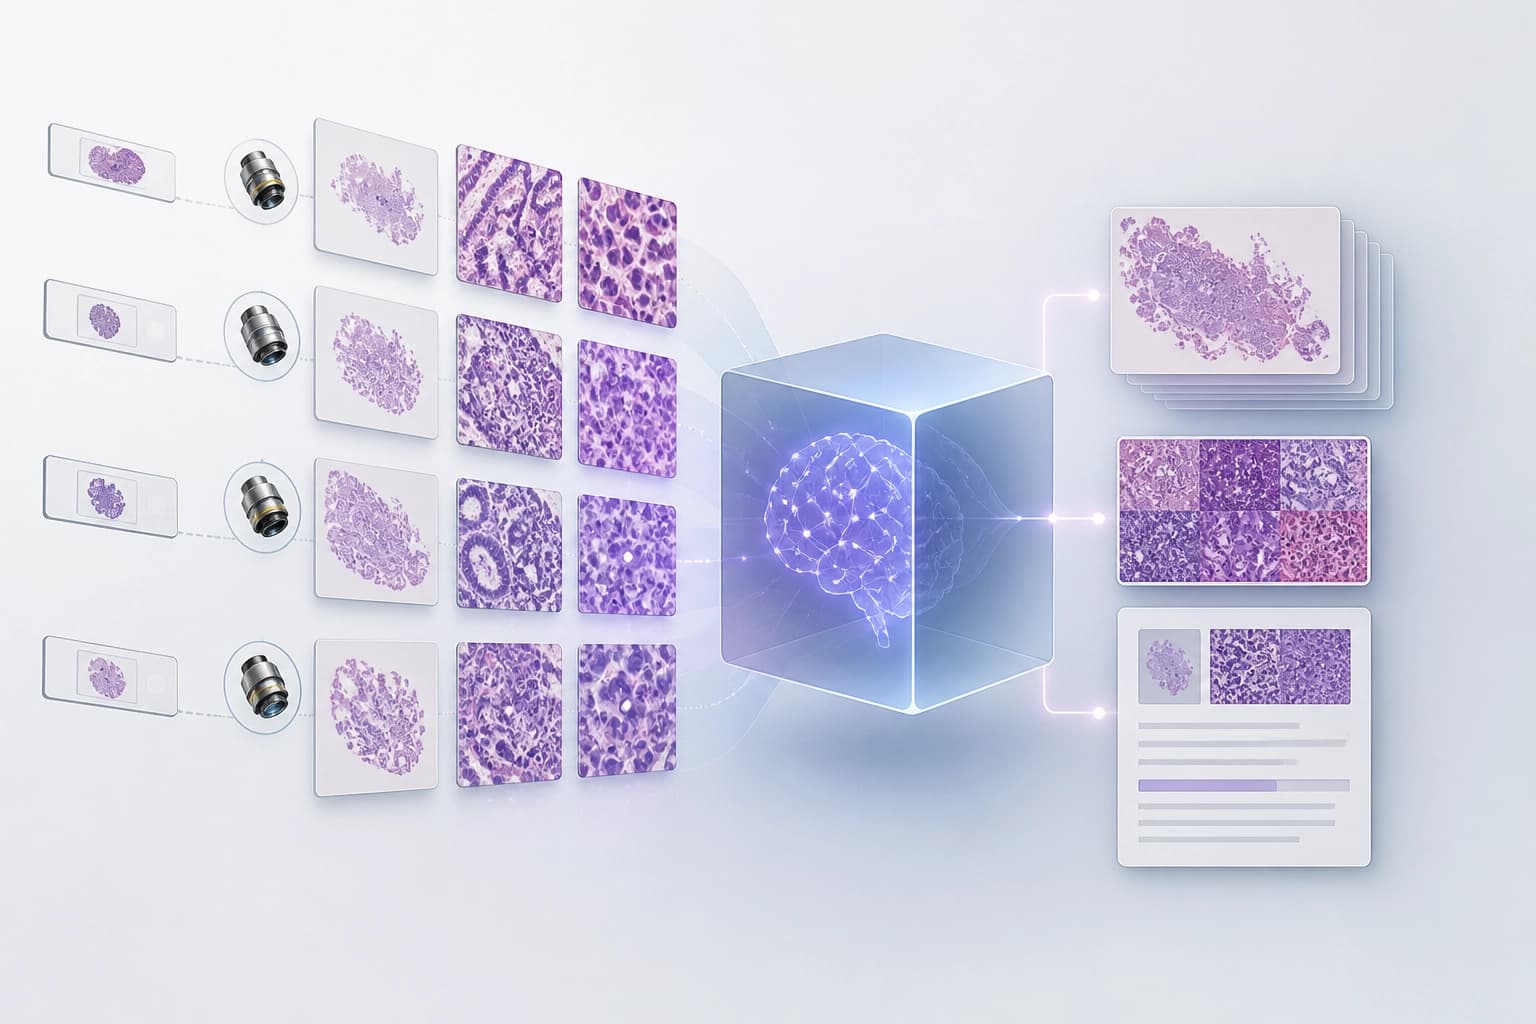
প্রিপ্রিন্টে WILSON উপস্থাপন করা হয়েছে—একটি ভিশন-ল্যাঙ্গুয়েজ মডেল, যা শুধু একটি আলাদা “সেরা” স্লাইড নয়, বরং সম্পূর্ণ স্লাইডের ছবি এবং একই রোগীর বিভিন্ন বিবর্ধনে তোলা নমুনার সিরিজ এনকোড করে। নির্দিষ্ট কাজের জন্য অতিরিক্ত প্রশিক্ষণ ছাড়াই, উল্লেখযোগ্যভাবে কম কম্পিউটেশনাল ব্যয়ে এটি বিভিন্ন মেট্রিকে বিশেষায়িত ও আরও বড় স্লাইড-মডেলগুলোকে ছাড়িয়ে যায়; পাশাপাশি, এর রোগনির্ণয়মূলক বর্ণনাগুলো প্যাথলজিস্টদের কাছ থেকে বেশি নম্বর পেয়েছে।
একটি প্রতিনিধিত্বমূলক স্লাইডই কেন যথেষ্ট নয়
প্যাথোলজিস্টরা বিভিন্ন বিবর্ধনে এবং একাধিক স্লাইডে টিস্যুর সেকশন পরীক্ষা করেন। রোগনির্ণয়ের জন্য তাঁরা আকারগত তথ্য একত্র করেন। প্যাথোলজির বেশিরভাগ ফাউন্ডেশন মডেল একটি প্রতিনিধিত্বমূলক («best») স্লাইড থেকে হাজার হাজার ছবির খণ্ডকে কোড করে। এরপর মডেলগুলো এই বৈশিষ্ট্যগুলো একত্র করে।
এই পদ্ধতির সীমাবদ্ধতা:
- মডেলটি পুরো কেসের বদলে একটি «best» স্লাইড পায়;
- বিভিন্ন বিবর্ধনের বৈশিষ্ট্য একত্র হয়ে একটি সাধারণ উপস্থাপনায় রূপ নেয় না;
- ছবির খণ্ড একত্র করার সময় রোগী-স্তরের প্রেক্ষাপট হারিয়ে যায়।
ব্যবহারিক মানদণ্ড: case-level কাজের জন্য এমন মডেল দরকার, যা একাধিক স্লাইড ও বিভিন্ন বিবর্ধন গ্রহণ করে। একটি প্রতিনিধিত্বমূলক স্লাইড দিয়ে এ ধরনের কাজ সম্পন্ন হয় না।
মডেল কীভাবে বিভিন্ন বিবর্ধন ও স্লাইড একত্র করে
WILSON একটি vision-language ফাউন্ডেশন মডেল। এটি multi-magnification composites-এর মাধ্যমে whole-slide images এবং একাধিক স্লাইডের কেস উপস্থাপন করে। এটি রোগী-স্তরে বিশ্লেষণ সমর্থন করে।
উপস্থাপনার অন্তর্ভুক্ত বিষয়গুলো:
- whole-slide images;
- একাধিক স্লাইডের কেস;
- multi-magnification composites-এর অংশ হিসেবে একাধিক বিবর্ধন।
উপসংহার: মডেলটি বিভিন্ন মাত্রা ও স্লাইডের আকারগত তথ্য একটি উপস্থাপনায় ধরে রাখে। এ দিক থেকে এটি একটি «best» স্লাইডের পদ্ধতি থেকে আলাদা।
প্রশিক্ষণ ও ডেটার পরিধি
WILSON-এর প্রশিক্ষণ ডেটাসেটে প্রায় 189 000টি স্লাইড রয়েছে। ডেটায় 42টি অঙ্গ এবং 838টি রোগনির্ণয়-সত্তা অন্তর্ভুক্ত।
পরিধি:
- 189 000টি স্লাইড;
- 42টি অঙ্গ;
- 838টি রোগনির্ণয়-সত্তা।
অঙ্গ ও সত্তার তালিকা কাজটি যাচাই করার ভিত্তি নির্ধারণ করে। বিশেষজ্ঞ এই তালিকার সঙ্গে অঙ্গ ও রোগনির্ণয়-সত্তা মিলিয়ে দেখেন।
নির্দিষ্ট কাজের জন্য প্রশিক্ষণ ছাড়াই ফলাফল
নির্দিষ্ট কাজের জন্য প্রশিক্ষণ ছাড়াই WILSON একটি বিশেষায়িত case-level model-কে macro-F1-এ ছাড়িয়ে গেছে। ফল ছিল যথাক্রমে 0.52 ও 0.38।
| তুলনা | WILSON | বিকল্প |
|---|---|---|
| case-level কাজের Macro-F1 | 0.52 | 0.38 |
| গণনামূলক অপারেশন | 400–1 350 গুণ কম | অনেক বড় slide-level models |
মডেলটি অনেক বড় slide-level models-এর সমতুল্য ফলও দেখিয়েছে। একই সঙ্গে, এতে 400–1 350 গুণ কম গণনামূলক অপারেশন লাগে।
উপসংহার: case-level বিশ্লেষণের মান গণনামূলক খরচের সঙ্গে বাড়তেই হবে, এমন নয়। সংক্ষিপ্ত বহুমাত্রিক উপস্থাপনা একটি ব্যবহারিক দিকনির্দেশ দেয়।
নির্দিষ্ট কাজের জন্য ফাইন-টিউনিং
End-to-end fine-tuning করলে WILSON-এর ফল উন্নত হয়েছে এই কাজগুলোতে:
- স্তন ক্যানসারের সাবটাইপিং;
- স্ট্রোমাল লিম্ফোসাইটের গ্রেড নির্ধারণ।
ব্যবহারিক মানদণ্ড: নির্দিষ্ট কাজের জন্য end-to-end fine-tuning বিবেচনা করা উচিত। বেস মডেলটি fine-tuning ছাড়াই case-level বিশ্লেষণ করে, আর fine-tuning নির্দিষ্ট কাজগুলোতে ফল উন্নত করে।
অনুসন্ধান ও রোগনির্ণয়মূলক লেখা তৈরি
image-text retrieval-এ WILSON recall@1-এ PRISM-কে ছাড়িয়ে গেছে। ফল ছিল যথাক্রমে 75.6% ও 58.1%।
| মেট্রিক | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
WILSON-এর রোগনির্ণয়মূলক বিবরণ পাঁচজন বোর্ড-সার্টিফায়েড প্যাথোলজিস্টের কাছ থেকে বেশি নম্বর পেয়েছে। প্রতিদ্বন্দ্বী মডেলগুলো কম নম্বর পেয়েছে।
ব্যবহারিক মানদণ্ড: অনুসন্ধান ও প্রতিবেদন তৈরির ক্ষেত্রে দুটি সক্ষমতা গুরুত্বপূর্ণ—retrieval এবং লেখা তৈরি। কর্মপ্রবাহের কাছাকাছি কাজ দিয়ে এগুলো যাচাই করা হয়।
মডেল বেছে নেওয়ার ক্ষেত্রে এর তাৎপর্য
লেখকদের উপসংহার, সংক্ষিপ্ত বহুমাত্রিক উপস্থাপনা গণনাগতভাবে দক্ষ এবং ক্লিনিক্যাল কাজে উপযোগী ফাউন্ডেশন মডেলকে সমর্থন করতে পারে। ব্যবহারিকভাবে মডেল বেছে নেওয়ার জন্য কয়েকটি বিষয় যাচাই করতে হবে।
মানদণ্ড:
- মডেল একাধিক স্লাইড গ্রহণ করে;
- মডেল বিভিন্ন বিবর্ধনকে সংযুক্ত করে;
- বিশ্লেষণ রোগী-স্তরে হয়;
- case-level কাজ দিয়ে মান মাপা হয়;
- গণনামূলক অপারেশন বিবেচনায় নেওয়া হয়;
- retrieval এবং লেখা তৈরি আলাদাভাবে যাচাই করা হয়।
উপসংহার: একটি «best» স্লাইড ও হাজার হাজার ছবির খণ্ড একত্র করা রোগীর প্রেক্ষাপটকে ধারণ করে না। মডেল বেছে নেওয়ার সময় দেখতে হবে, এটি কীভাবে সেই প্রেক্ষাপট একত্র করে এবং কত গণনা প্রয়োজন হয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ড্যাশবোর্ড বিশ্লেষণে GUI এজেন্টদের ধাপে ধাপে ডায়াগনস্টিকস: DashAct বেঞ্চমার্ক
DashAct উপস্থাপন করা হলো—মানুষের দ্বারা যাচাই করা ৩৪৮টি ট্র্যাজেক্টরির একটি বেঞ্চমার্ক, যা ইন্টারঅ্যাকটিভ প্যানেলে GUI এজেন্টদের কাজকে তিনটি ধাপ ও চারটি ভিজ্যুয়াল পরিস্থিতিতে বিশ্লেষণ করে। ফলাফলগুলোতে অ্যাকশন পূর্বাভাস এবং ভিজ্যুয়াল লক্ষ্য শনাক্তকরণে ধারাবাহিক সমস্যা, পাশাপাশি প্রাসঙ্গিক ও স্থানিক সহায়তার ওপর এজেন্টদের প্রতিক্রিয়ার নির্ভরতা দেখা যায়।
11 নভেম্বর 2026
RL সিমুলেটরের ব্যর্থতা নির্ণয়ে ক্যানোনিক্যাল বহুপদী ইনভেরিয়েন্ট: এগুলো আসলে কোথায় কাজে লাগে
এই কাজটি পরীক্ষা করে, প্রশিক্ষণযোগ্য গতিবিদ্যার মডেলগুলোতে পদার্থবিজ্ঞানের সূত্র অন্তর্ভুক্ত করা কতটা যুক্তিযুক্ত: ট্র্যাজেক্টরি থেকে আহরিত এবং গ্রোবনার ভিত্তির মাধ্যমে ক্যানোনিকাল রূপে আনা ইনভারিয়ান্টগুলো পূর্বাভাসে সামান্য উন্নতি আনে, তবে রোগনির্ণয়ে কার্যকর—এগুলো লঙ্ঘিত সীমাবদ্ধতাটি কোথায় ঘটেছে তা নির্দিষ্ট করতে এবং নির্দিষ্ট ভুল প্যারামিটার শনাক্ত করতে সাহায্য করে।
10 নভেম্বর 2026
AURA-Eval: কীভাবে যাচাই করবেন যে LLM এজেন্ট ঝুঁকি শনাক্ত করেছে এবং পরবর্তী পদক্ষেপ পরিবর্তন করেছে
এই ফ্রেমওয়ার্ক LLM এজেন্টদের আচরণকে চূড়ান্ত রায় দিয়ে নয়, বরং গুরুত্বপূর্ণ মুহূর্তে ঝুঁকির প্রতিক্রিয়া দিয়ে মূল্যায়ন করে: টুল কলের ধারা মাঝপথে থামিয়ে দেওয়া হয়, এরপর মডেলকে তার যুক্তি ও কাজ চালিয়ে যেতে হয়; আর LLM বিচারকদের একটি প্যানেল ঝুঁকি শনাক্তকরণ, পদক্ষেপের ধরন ও নিরাপত্তা বিশ্লেষণ করে। R-Judge-এর 157টি ট্র্যাজেক্টরি থেকে সংগৃহীত 1249টি কাজে, 20টি মডেলের নিরাপদ পথ না থাকলে অনিরাপদ পদক্ষেপ নেওয়ার প্রবণতা বেড়ে যায়; আর কাজ সম্পন্ন হওয়ার আগে তদারকি তুলে নিলে শুরুতে নিরাপদ থাকা ঘটনাগুলোর 52,3% অনিরাপদ হয়ে ওঠে।
10 নভেম্বর 2026