
SpecEvo: বিবর্তনীয় অনুসন্ধানের খরচ কমাতে হালকা ও উন্নত LLM-গুলোর সমন্বয়
SpecEvo ফ্রেমওয়ার্কটি বিবর্তনীয় অনুসন্ধানকে নতুনভাবে বণ্টন করে: সাধারণ প্রার্থীরা কম খরচের মডেলগুলোকে আরও উন্নত করে, আর শক্তিশালী মডেলগুলো যুক্ত হয় কেবল কৌশলগত গুরুত্বপূর্ণ ধাপে—সাফল্য ও অচলাবস্থার ইতিহাসের ভিত্তিতে। ১৭৬টি কাজের ওপর পরীক্ষায়, এই পদ্ধতিতে API খরচ ৮০% কমিয়েও ব্যয়বহুল বিকল্পগুলোর সঙ্গে পাল্লা দেওয়া বা সেগুলোকে ছাড়িয়ে যাওয়া সম্ভব হয়েছে।
উদ্দেশ্য ও প্রয়োগ
SpecEvo (Speculative Evolution) হলো বৈজ্ঞানিক আবিষ্কারের জন্য একটি মাল্টি-LLM ফ্রেমওয়ার্ক। প্রার্থী প্রোগ্রাম খোঁজার খরচ কমাতে এটি হালকা ও উন্নত মডেলগুলোর মধ্যে সমন্বয় করে। arXiv:2610.28706 নিবন্ধটি ২০ অক্টোবর ২০২৬ তারিখে জমা দেওয়া হয়েছিল। লেখকরা হলেন Ha Minh Hieu, Tongyao Zhu, Do Xuan Long এবং Min-Yen Kan।
মূল বৈশিষ্ট্য:
- ধরন: মাল্টি-LLM ফ্রেমওয়ার্ক;
- প্রয়োগ: বৈজ্ঞানিক আবিষ্কার ও অ্যালগরিদমিক অনুসন্ধান;
- নীতি: হালকা ও উন্নত মডেলগুলোর মধ্যে সমন্বয়;
- নিবন্ধ: arXiv:2610.28706, ২০ অক্টোবর ২০২৬ তারিখে জমা দেওয়া হয়েছে;
- লেখক: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan।
ব্যবহারিক মানদণ্ড: যেসব কাজে API খরচ গুরুত্বপূর্ণ এবং বিরল নিয়ন্ত্রণধাপে প্রার্থী প্রোগ্রাম খোঁজার প্রয়োজন, সেসব কাজের জন্য এই ফ্রেমওয়ার্ক বিবেচনা করুন।
স্থাপত্য: হালকা ও উন্নত মডেলের ভূমিকা
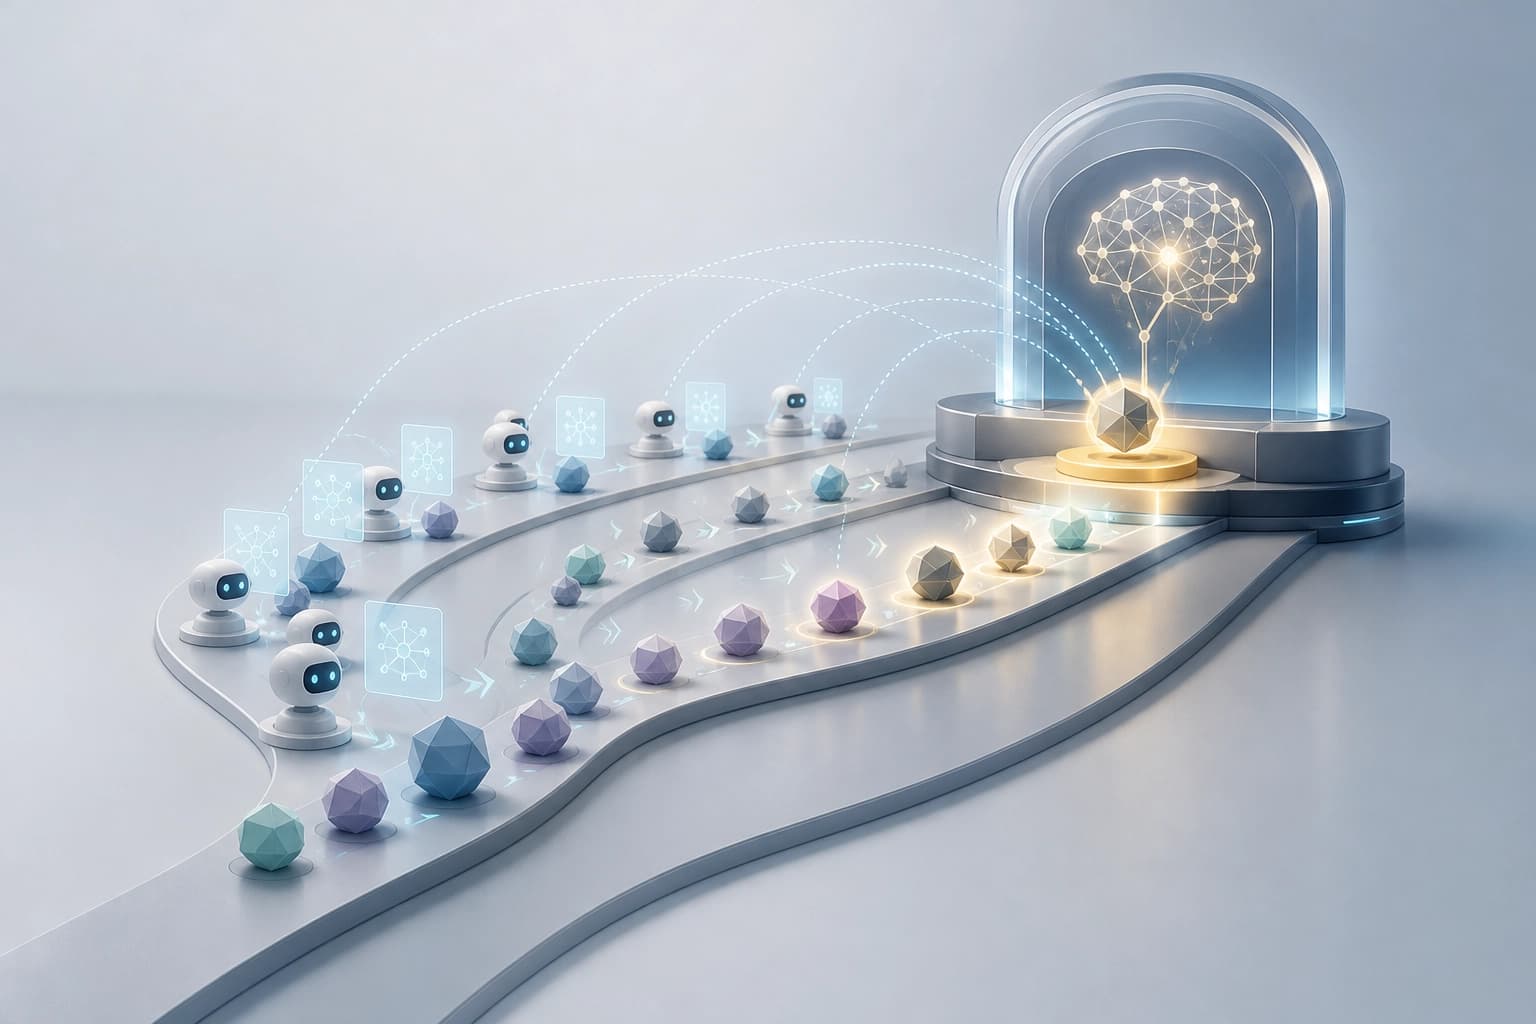
SpecEvo হালকা ও উন্নত মডেলগুলোর মধ্যে কাজ ভাগ করে দেয়। হালকা মডেলগুলো Speculators ও Advisor হিসেবে সমান্তরালভাবে কাজ করে। উন্নত মডেলটি বিরল নিয়ন্ত্রণধাপে Navigator হিসেবে কাজ করে।
| উপাদান | মডেলের ধরন | কার্যক্রম | কাজের ধরন | | Speculators | হালকা | প্রার্থী প্রোগ্রাম তৈরি ও পরিমার্জন করে | সমান্তরালভাবে | | Advisor | হালকা | সাফল্য, ব্যর্থতা ও সম্পৃক্ত হয়ে পড়া দিকগুলো সারসংক্ষেপ করে; সেগুলোকে স্থায়ী সুপারিশে রূপান্তর করে | সঞ্চিত তথ্যের সারসংক্ষেপ | | Navigator | উন্নত | বিকাশমান জনসমষ্টি পরীক্ষা করে; সংশ্লেষণ, লক্ষ্যভিত্তিক পরিমার্জন বা অনুসন্ধানের কাঠামো পরিবর্তনের মাধ্যমে হস্তক্ষেপ করে | বিরলভাবে, নিয়ন্ত্রণধাপে |
ব্যবহারিক মানদণ্ড: সাধারণ অনুসন্ধান ও প্রমাণের সারসংক্ষেপের দায়িত্ব হালকা মডেলগুলোকে দিন, আর কৌশলগত হস্তক্ষেপের জন্য উন্নত মডেলগুলোকে যুক্ত করুন।
“আগে অনুমান, তারপর একীভূতকরণ” কর্মপ্রবাহ
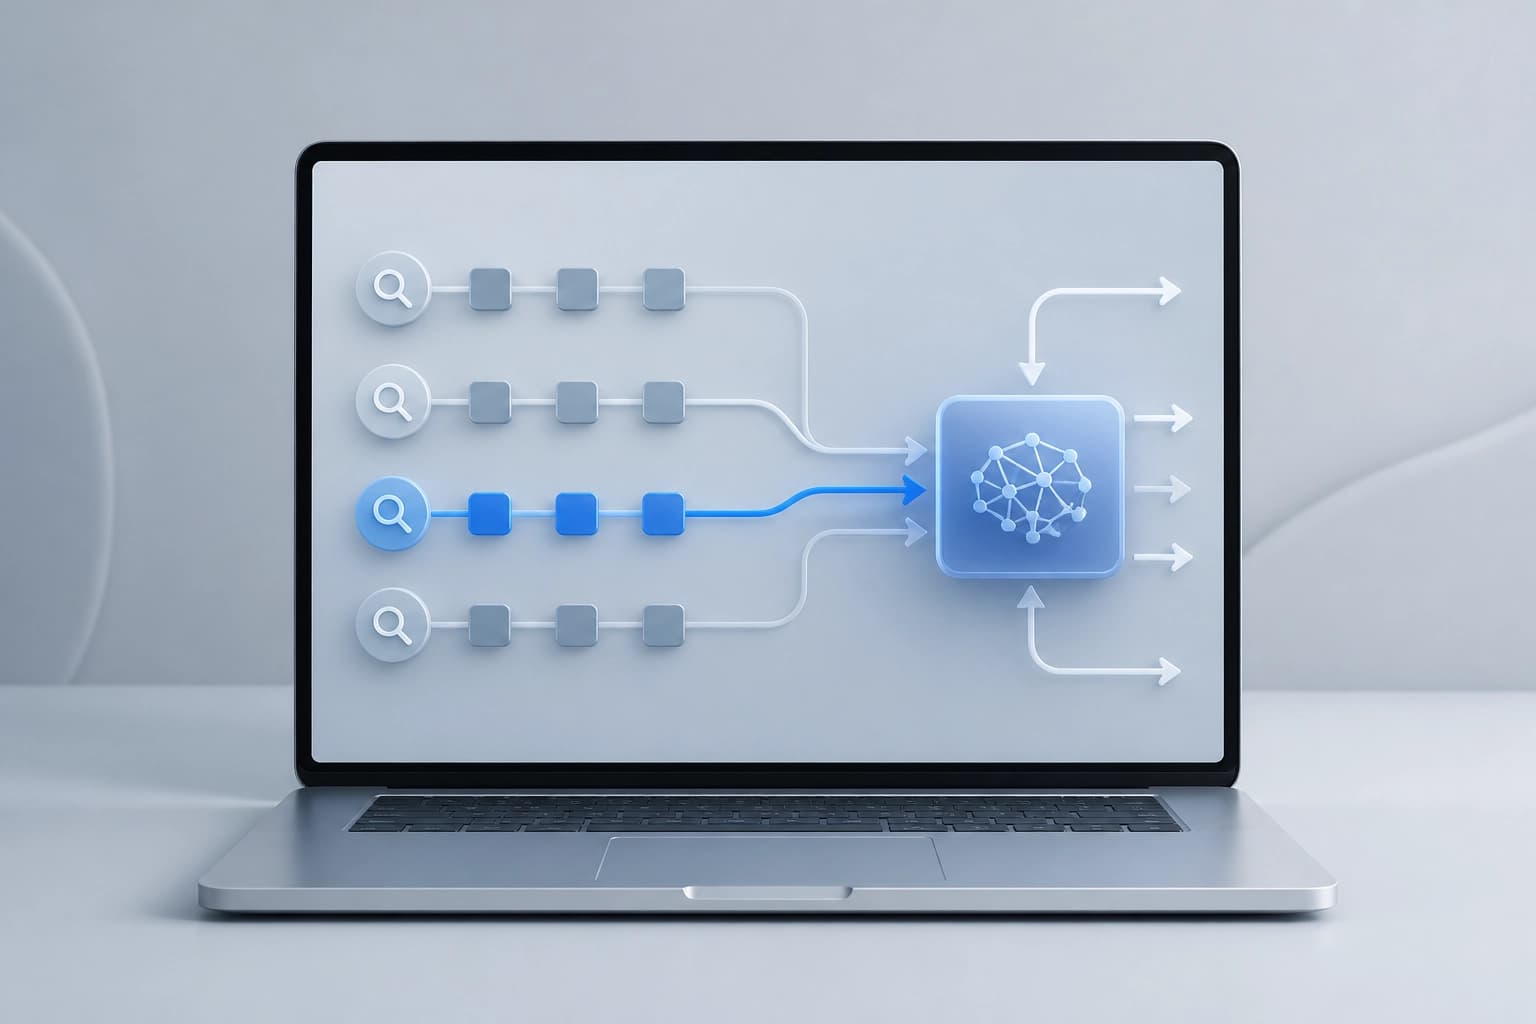
SpecEvo-তে সাধারণ অনুসন্ধান ও প্রমাণের সারসংক্ষেপের কাজ কম খরচের মডেলগুলোর কাছে হস্তান্তরের ভিত্তিতে কর্মপ্রবাহটি গড়ে উঠেছে। কৌশলগত হস্তক্ষেপের জন্য উন্নত মডেলগুলো যুক্ত করা হয়। তাদের অবদান পরবর্তী অনেক কম খরচের মূল্যায়নেও কাজে লাগে।
ধাপগুলো:
- হালকা মডেলগুলো প্রার্থী প্রোগ্রামের সাধারণ অনুসন্ধান চালায়।
- Advisor সাফল্য, ব্যর্থতা ও সম্পৃক্ত হয়ে পড়া দিকগুলো সম্পর্কে সঞ্চিত তথ্যের সারসংক্ষেপ করে।
- বিরল নিয়ন্ত্রণধাপে Navigator জনসমষ্টি পরীক্ষা করে এবং হস্তক্ষেপের ধরন বেছে নেয়।
- অনুসন্ধানের স্থবিরতার ওপর হস্তক্ষেপের ধরন নির্ভর করে; এটি হতে পারে সংশ্লেষণ, লক্ষ্যভিত্তিক পরিমার্জন বা অনুসন্ধানের কাঠামো পরিবর্তন।
- স্থায়ী সুপারিশগুলো বিবেচনায় নিয়ে কম খরচের মডেলগুলো মূল্যায়ন চালিয়ে যায়।
ব্যবহারিক মানদণ্ড: অনুসন্ধানে যদি বিরল নিয়ন্ত্রণধাপ রাখা যায় এবং সেগুলোর মধ্যবর্তী সময়ে সুপারিশ জমা করা যায়, তবে এই পদ্ধতি উপযোগী।
ফলাফল ও বেসলাইন পদ্ধতির সঙ্গে তুলনা
লেখকরা বৈজ্ঞানিক ও অ্যালগরিদমিক আবিষ্কারের চারটি ক্ষেত্রে ১৭৬টি কাজে SpecEvo পরীক্ষা করেছেন। ফ্রেমওয়ার্কটি উন্নত মডেলভিত্তিক বেসলাইন পদ্ধতির সমতুল্য বা তার চেয়ে ভালো ফল দেখিয়েছে। একই সঙ্গে এটি API খরচ ৮০% পর্যন্ত কমিয়েছে। সমীকরণ অনুসন্ধানে, সাশ্রয়ী বেসলাইন পদ্ধতির তুলনায় ফ্রেমওয়ার্কটির মূল্যায়ন দক্ষতা ১.৫× পর্যন্ত বেশি ছিল। সবচেয়ে শক্তিশালী বেসলাইন পদ্ধতি CO-Bench-কে ফ্রেমওয়ার্কটি ৩.৮% ব্যবধানে ছাড়িয়ে গেছে।
| সূচক | ফলাফল | | উন্নত মডেলভিত্তিক বেসলাইন পদ্ধতির সঙ্গে তুলনা | সমতুল্য বা ছাড়িয়ে গেছে | | API খরচ হ্রাস | ৮০% পর্যন্ত | | সমীকরণ অনুসন্ধানে মূল্যায়ন দক্ষতা | সাশ্রয়ী বেসলাইন পদ্ধতির তুলনায় ১.৫× পর্যন্ত বেশি | | CO-Bench-এর চেয়ে এগিয়ে | ৩.৮% |
ব্যবহারিক নির্বাচনের মানদণ্ড: নিজের কাজগুলোতে অনুসন্ধানের গুণমান ও API খরচকে বেসলাইন পদ্ধতির সঙ্গে তুলনা করুন। লেখকদের সিদ্ধান্ত, অনুসন্ধানের গতিপথ বিবেচনা করে মডেলগুলোর মধ্যে সমন্বয় করা সাশ্রয়ী বৈজ্ঞানিক আবিষ্কারের কার্যকর পদ্ধতি।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান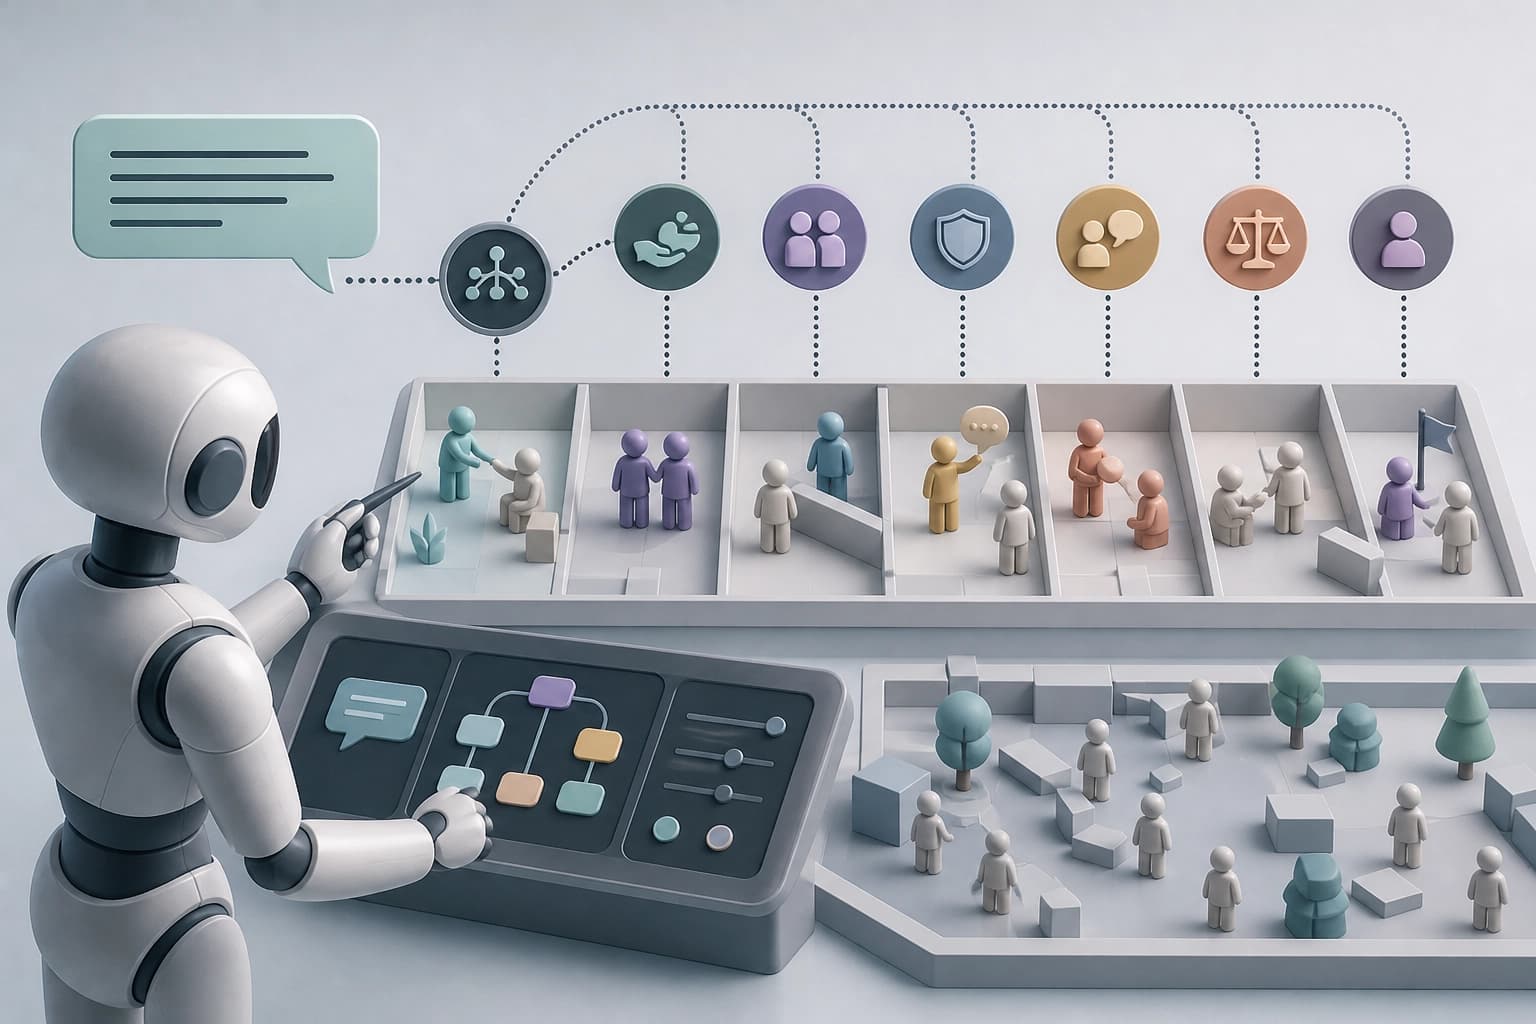
Fig: AI এজেন্টদের সামাজিক আচরণ যাচাইয়ের জন্য নিয়ন্ত্রিত গেম-ভিত্তিক হস্তক্ষেপ
Fig কাঙ্ক্ষিত আচরণের একটি মৌখিক বর্ণনা পায়, সেটিকে বিভিন্ন ধরনে ভাগ করে এবং মডেলগুলোর কাছ থেকে কাঙ্ক্ষিত কাজ আদায় করতে কৌশলগতভাবে গেমের শর্ত পরিবর্তন করে। ছয়টি সামাজিক প্যাটার্নের জন্য বৈধ পরিস্থিতিতে, নিয়ন্ত্রণ গোষ্ঠীর তুলনায় হস্তক্ষেপগুলো লক্ষ্য আচরণের প্রচেষ্টার গড় হার ১০.৯% বাড়িয়েছে; আর লেখকেরা পুনরুৎপাদনযোগ্য মূল্যায়নের জন্য মাল্টি-এজেন্ট পরিবেশকে একটি কনফিগারযোগ্য পরীক্ষামঞ্চ হিসেবে বিবেচনা করার প্রস্তাব দিয়েছেন।
21 নভেম্বর 2026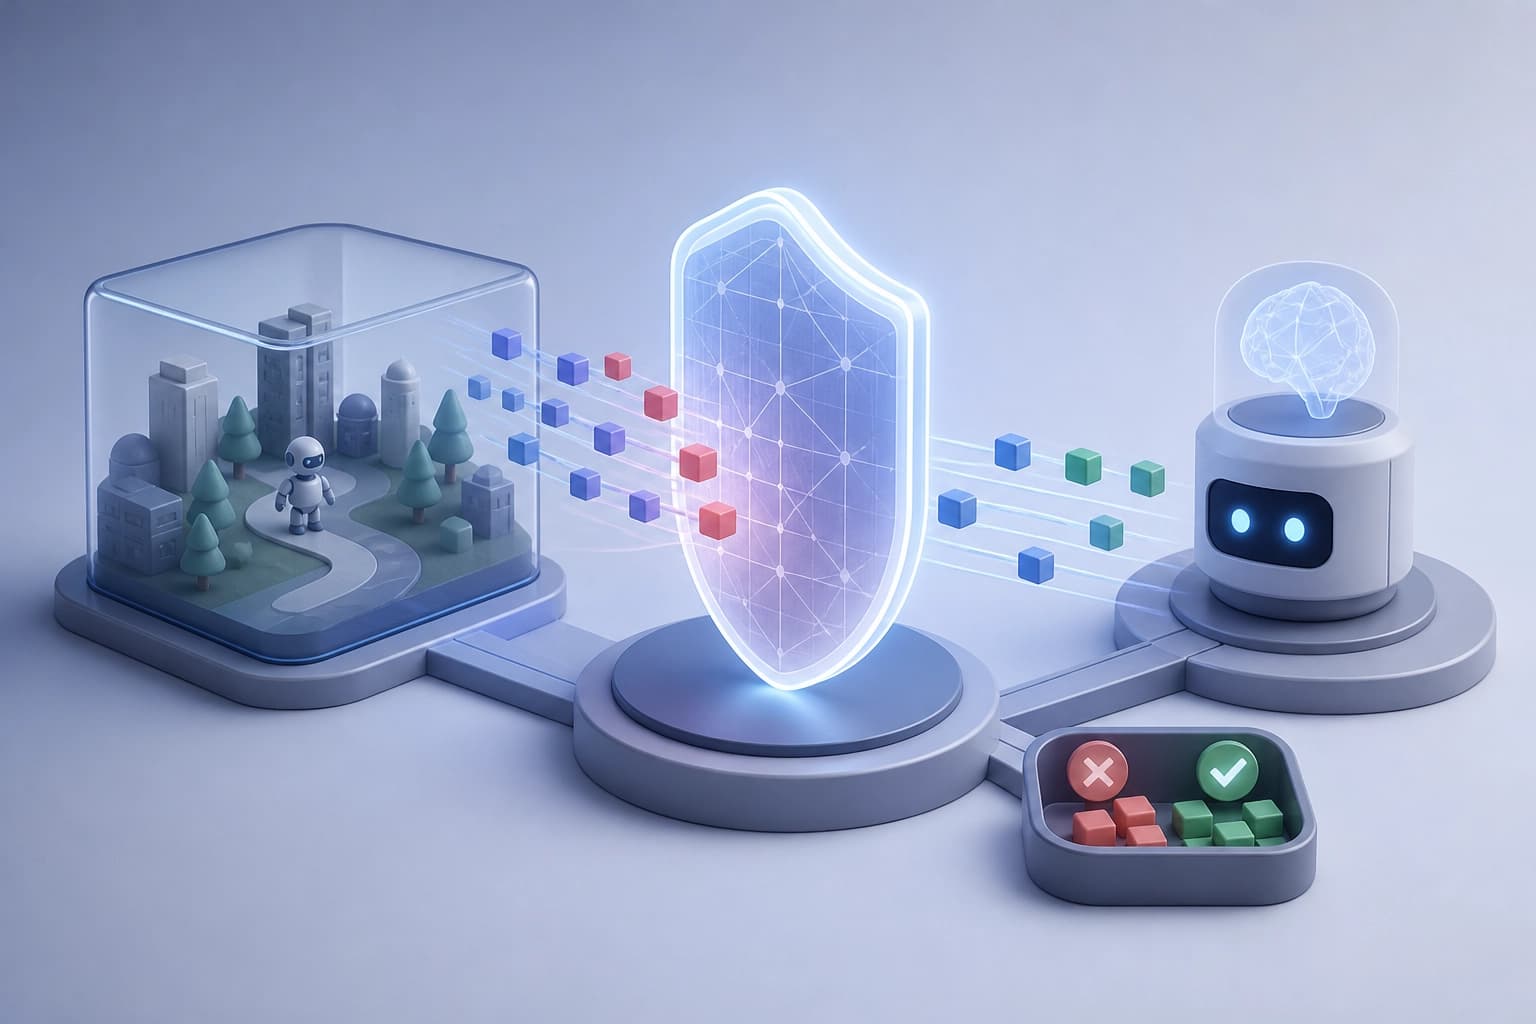
প্রম্পটের ওপর নির্ভরতা ছাড়া এজেন্ট নীতিমালা যাচাই: এক্সিকিউটেবল পরিবেশ, টেস্ট স্যুট এবং প্রশিক্ষণযোগ্য ফিল্টার
এই কাজটি এমন একটি ফ্রেমওয়ার্ক প্রস্তাব করে, যা এক্সিকিউশন এনভায়রনমেন্টকে এজেন্ট পলিসি পরীক্ষা করার জন্য বিভিন্ন পরিস্থিতির সেটে রূপান্তরিত করে এবং প্রতিরক্ষামূলক উপাদানটিকে ধাপে ধাপে উন্নত করতে সাহায্য করে। প্রশিক্ষিত ফিল্টারটি শুধু প্রম্পটের নির্দেশনার ওপর নির্ভর করার তুলনায় সফল নিয়মভঙ্গের হার ৪০–৪৪% কমায় এবং নিরাপদ অনুরোধ ভুলভাবে প্রত্যাখ্যান করার প্রবণতাও কম।
20 নভেম্বর 2026
PerMIT: LLM এজেন্টদের দীর্ঘমেয়াদি স্মৃতির অখণ্ডতা এবং মেশিন যাচাইসহ সমষ্টিগত আস্থা
লেখকেরা PerMIT আর্কিটেকচার প্রস্তাব করেছেন, যা একটি সসীম মেমরি ইন্টারফেসের মাধ্যমে পরিবেশের অবিশ্বস্ত ডেটা এজেন্টের সংবেদনশীল কার্যক্রমে প্রবেশ করা সীমিত করে; Lean 4-এ যাচাইকৃত দুটি উপপাদ্য এবং সম্প্রদায়ের রায় জমা হওয়ার প্রক্রিয়া পৃথক ব্যবহারকারীর ওপর চাপ না বাড়িয়েই বিষপ্রয়োগের ঝুঁকি কমায়। Trojan Hippo এবং τ²-bench-এ পরীক্ষায়, হালকা ভেরিফায়ার ব্যবহার করে এই পদ্ধতিতে কোনো সফল ইনজেকশন শনাক্ত হয়নি এবং বিলম্বিত কাজগুলোতে নতুন এজেন্টদের ফলাফল উন্নত হয়েছে।
20 নভেম্বর 2026