
OWP পদ্ধতি: Omni-LLM-এ প্রমাণ ও প্রায়র সংকেতের পুনর্বণ্টন
প্রশিক্ষণ ছাড়াই ব্যবহারযোগ্য Omni-Woodpecker ফ্রেমওয়ার্কটি বিভিন্ন মোডালিটির মধ্যে দ্বন্দ্ব শনাক্ত করে এবং ডিকোডিংয়ের আগে হিডেন স্টেটে কনটেক্সটের তথ্য ও মুখস্থ প্রায়রের মধ্যে ভারসাম্য পরিবর্তন করে। Qwen2.5-Omni-7B এবং VideoLLaMA2-AV-তে এই পদ্ধতিটি CMM ও AVHBench-এ অডিওভিজ্যুয়াল ত্রুটির বিরুদ্ধে স্থিতিশীলতা বাড়ায়, আর সাধারণ যুক্তি-বিষয়ক বেঞ্চমার্কে মাঝারি মাত্রার উন্নতি আনে।
OWP কী এবং এটি কোন সমস্যার সমাধান করে
Omni-Woodpecker (OWP) হলো Omni LLMs-এ আন্তমোডাল হ্যালুসিনেশন সংশোধনের জন্য একটি প্রশিক্ষণবিহীন ফ্রেমওয়ার্ক। এই পদ্ধতি সংশোধনের কাজকে আউটপুটের স্তর থেকে সরিয়ে মোডালিটির দ্বন্দ্বের কারণে সৃষ্ট উপস্থাপনার পুনঃভারসাম্যায়নে নিয়ে যায়। লেখকেরা ১৯ অক্টোবর ২০২৬ তারিখে প্রবন্ধটি জমা দেন: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He।
প্রচলিত সংশোধন পদ্ধতি তৈরি হয়ে যাওয়া উত্তরের ওপর কাজ করে। OWP ডিকোডিংয়ের আগে অভ্যন্তরীণ উপস্থাপনায় হস্তক্ষেপ করে। এতে পদ্ধতিটির প্রয়োগের স্থান বদলে যায়।
উপসংহার: OWP তৈরি হয়ে যাওয়া উত্তর সংশোধন করে না, বরং সংশোধনের স্থান বদলে দেয়।
প্রমাণ ও পূর্বানুমানের সংকেত পুনর্বণ্টনের ধাপ
OWP কয়েকটি ধাপে পুনঃভারসাম্যায়ন সম্পন্ন করে। প্রথমে পদ্ধতিটি পৃথক মোডালিটির অতিরিক্ত উপস্থাপনাগুলোর মাধ্যমে আন্তমোডাল দ্বন্দ্ব শনাক্ত করে।
- পৃথক মোডালিটির অতিরিক্ত উপস্থাপনাগুলোর মাধ্যমে আন্তমোডাল দ্বন্দ্ব শনাক্তকরণ।
- গ্রাউন্ডিং-প্রমাণকে প্রতিদ্বন্দ্বী পূর্বানুমানমূলক মূল্যায়ন থেকে আলাদা করতে হিডেন স্টেটের অর্থোগোনাল বিভাজন।
- একীভূত উপস্থাপনাগুলোর অভিযোজনশীল পুনঃভারসাম্যায়ন: বিভ্রান্তিকর পূর্বানুমান দমন এবং উপেক্ষিত প্রমাণ পুনরুদ্ধার।
- সংশোধিত উপস্থাপনাগুলো ডিকোডিংয়ে পাঠানো।
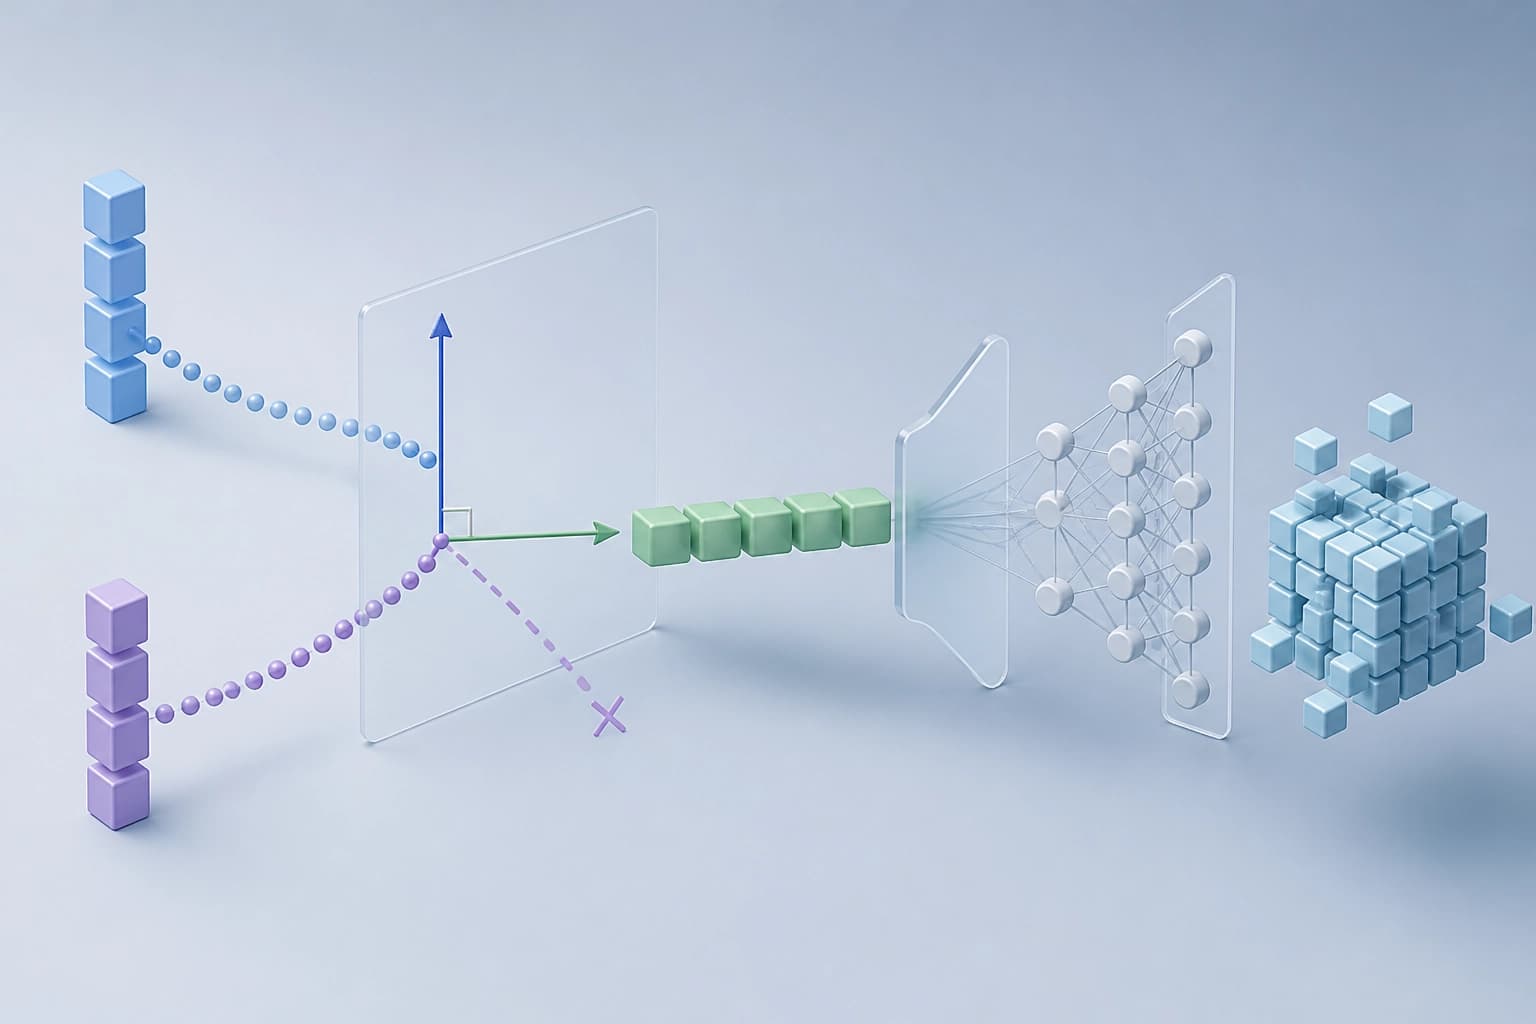
পদ্ধতিটি মডেলের ওজন পরিবর্তন করে না। এটি জেনারেশনের আগে উপস্থাপনাগুলো সংশোধন করে।
উপসংহার: OWP-এর জন্য প্রশিক্ষণ বা ওজন পরিবর্তনের দরকার নেই। এটি ডিকোডিংয়ের আগে হিডেন স্টেটে কাজ করে।
ফলাফল: বেঞ্চমার্কে উন্নতি ও স্থানান্তরযোগ্যতা
Qwen2.5-Omni-7B-তে OWP, CMM এবং AVHBench-এ ফলাফল যথাক্রমে ১২.৯ ও ৮.৬ পয়েন্ট বাড়ায়। OLLM-এর চারটি সাধারণ রিজনিং বেঞ্চমার্কে উন্নতি ০.৬৭–২.২৫ পয়েন্ট।
| মডেল | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +১২.৯ পয়েন্ট | +৮.৬ পয়েন্ট |
| VideoLLaMA2-AV | +৪.৬ পয়েন্ট | +৩.৯ পয়েন্ট |
VideoLLaMA2-AV-তেও পদ্ধতিটির স্থানান্তরযোগ্যতা দেখা গেছে: CMM এবং AVHBench-এ যথাক্রমে ৪.৬ ও ৩.৯ পয়েন্ট উন্নতি। লেখকেরা কার্যকারিতা এবং আর্কিটেকচারের মধ্যে স্থানান্তরযোগ্যতার কথা জানিয়েছেন। কোড সর্বসাধারণের জন্য উন্মুক্ত।
উপসংহার: উন্নতির পরিমাণ মডেল ও বেঞ্চমার্কের ওপর নির্ভর করে। ব্যবহারিক মানদণ্ড: প্রয়োগের আগে নিজের আর্কিটেকচার ও লক্ষ্যভিত্তিক কাজের সেটে OWP পরীক্ষা করা উচিত।
OWP বেছে নেওয়ার ব্যবহারিক মানদণ্ড
কয়েকটি শর্ত পূরণ হলে OWP উপযোগী। পদ্ধতিটি প্রশিক্ষণ ছাড়াই এবং মডেলের ওজন পরিবর্তন না করেই কাজ করে।
- প্রশিক্ষণ ছাড়া আন্তমোডাল হ্যালুসিনেশন সংশোধন করা প্রয়োজন।
- হিডেন স্টেট এবং পৃথক মোডালিটির উপস্থাপনাগুলো পাওয়া যায়।
- উত্তরের পোস্ট-প্রসেসিংয়ের বদলে ডিকোডিংয়ের আগে হস্তক্ষেপ দরকার।
- পদ্ধতিটি পুনরুৎপাদন করার সুযোগ আছে: কোড সর্বসাধারণের জন্য উন্মুক্ত।
OWP হলো প্রমাণ ও পূর্বানুমানের সংকেত পুনঃভারসাম্যায়নের একটি প্রশিক্ষণবিহীন পদ্ধতি। লেখকেরা আর্কিটেকচারের মধ্যে স্থানান্তরযোগ্যতার দাবি করেছেন। নির্দিষ্ট মডেলে পরীক্ষা করা এখনও অপরিহার্য।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান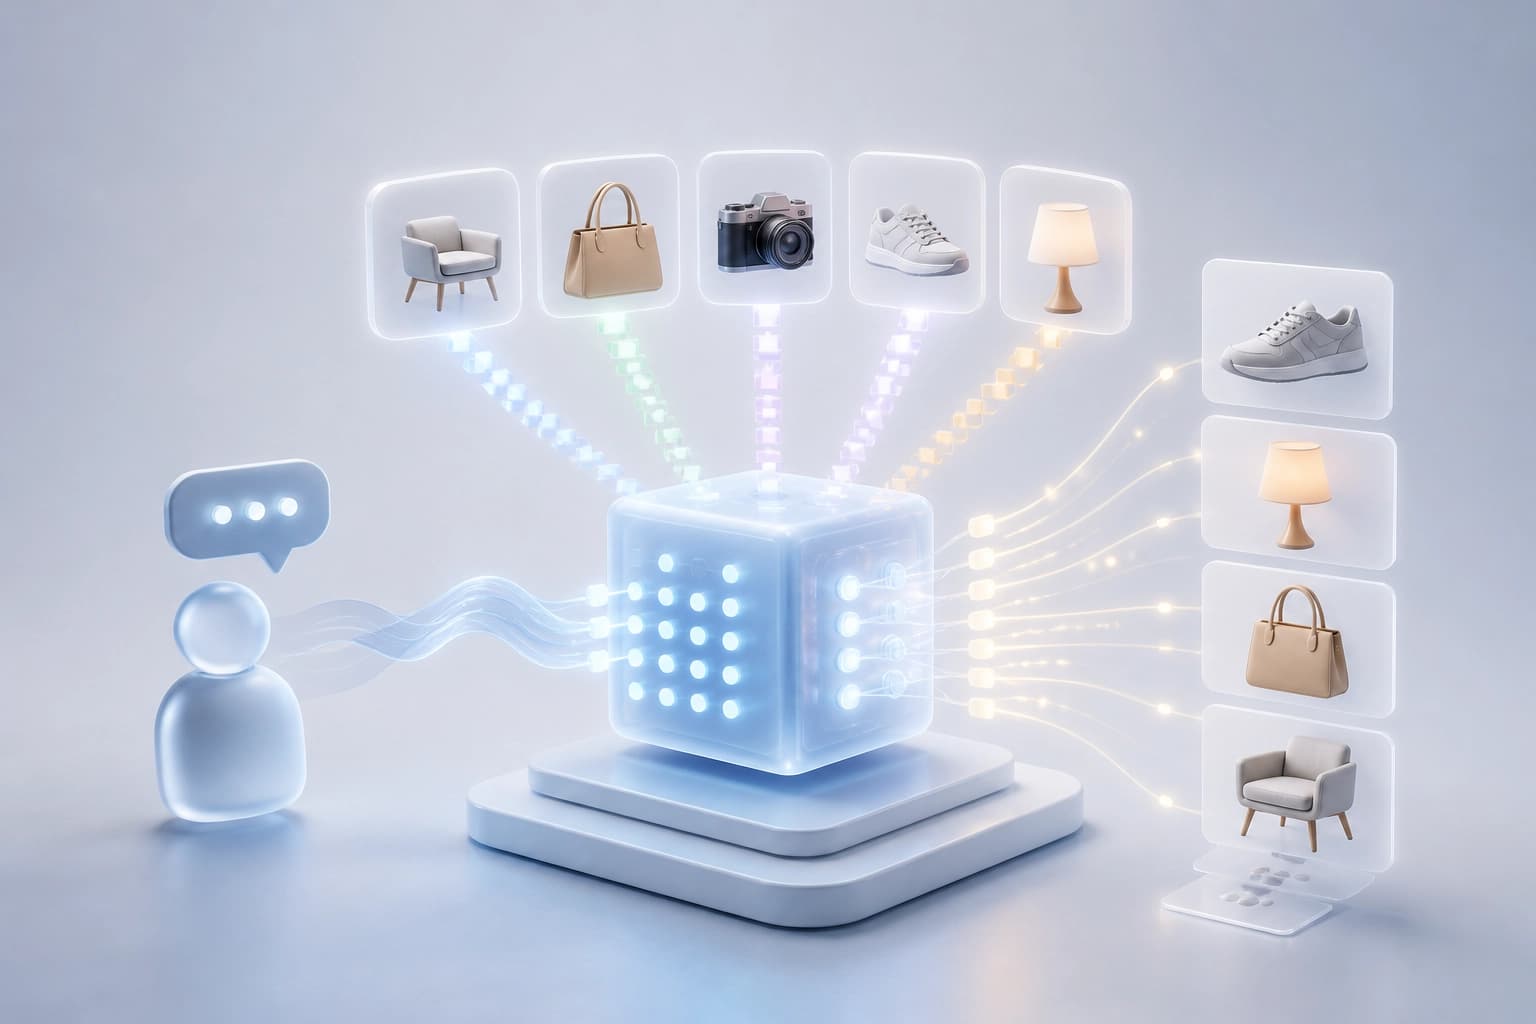
LightCRS: প্রতি ক্যাটাগরির জন্য আলাদা VLM ছাড়া কথোপকথনমূলক সুপারিশের কমপ্যাক্ট মাল্টিডোমেইন স্কিম
লেখকেরা এমন একটি ব্যবস্থা উপস্থাপন করেছেন, যেখানে পণ্যের মাল্টিমোডাল বৈশিষ্ট্যগুলো অফলাইনে স্থির এনকোডার দিয়ে গণনা করা হয়, আর সংলাপের সময় সেগুলো সব ডোমেইনের জন্য অভিন্ন ৫.৩ মিলিয়ন প্যারামিটারের একটি মডিউল প্রক্রিয়াকরণ করে, যাতে রয়েছে কোয়েরি-নির্ভর ক্রস-অ্যাটেনশন। ২৫টি ডোমেইনের একটি বেঞ্চমার্কে এই পদ্ধতি গড় র্যাঙ্কিং মেট্রিক উন্নত করে, ল্যাটেন্সি উল্লেখযোগ্যভাবে কমায় এবং দেখায় যে যৌথ প্রশিক্ষণ আলাদা একক-ডোমেইন মডেলের তুলনায় উন্নতি আনে।
16 নভেম্বর 2026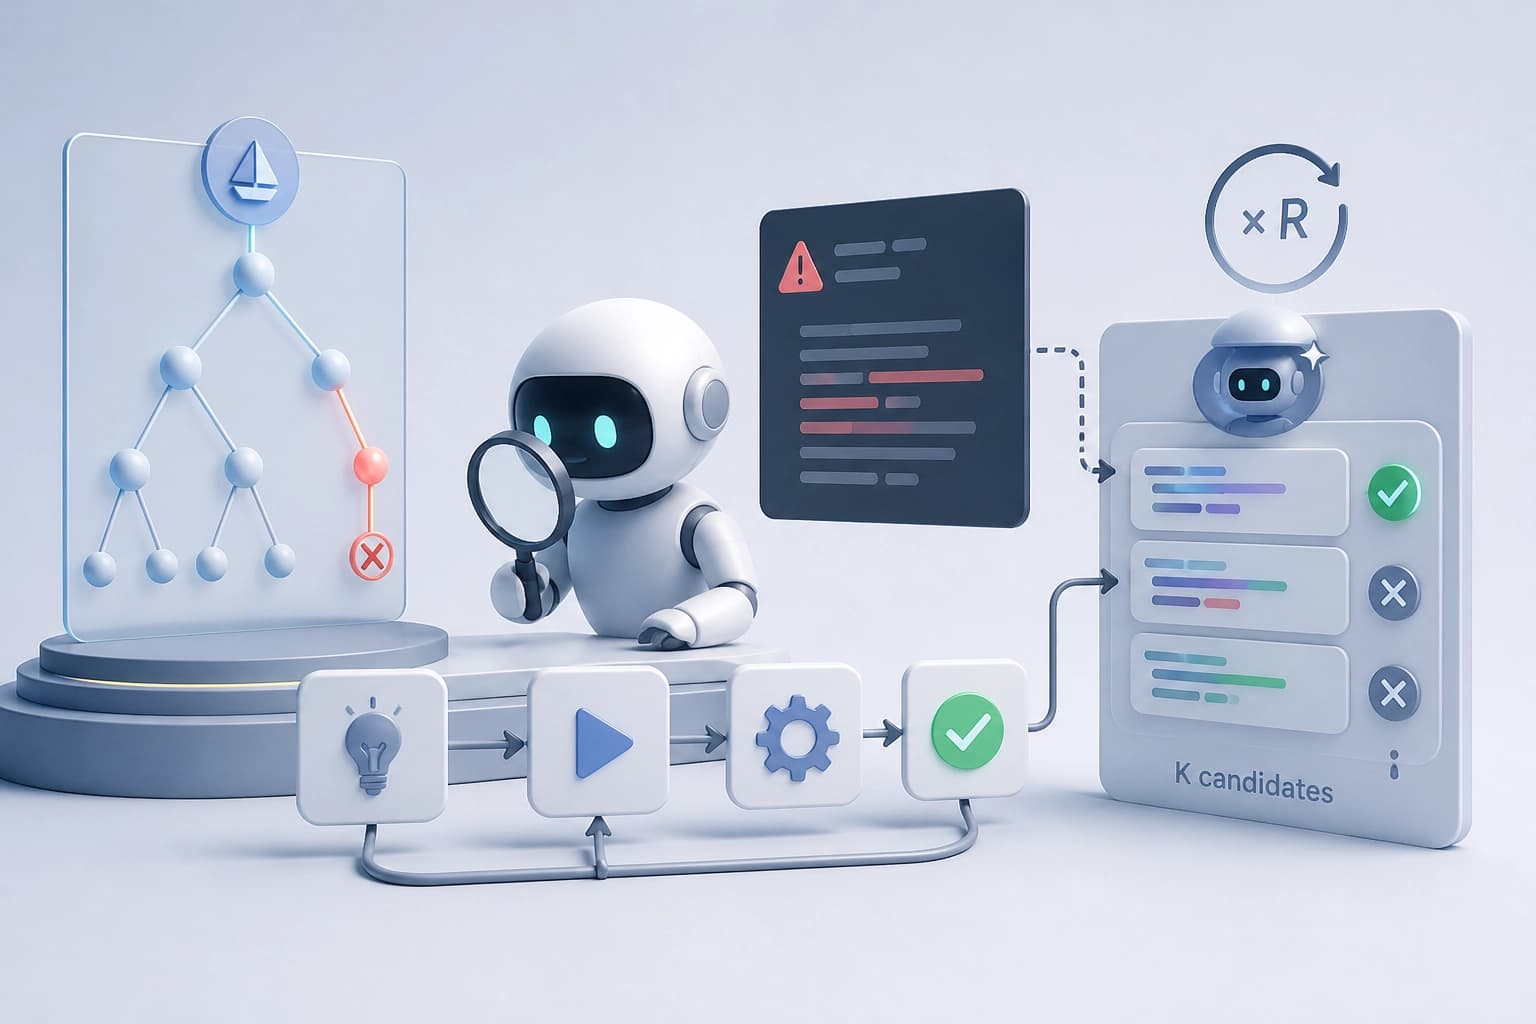
Lean 4-এ কম্পাইলার ডায়াগনস্টিকের সহায়তায় সীমিত ট্যাকটিক মেরামত
একটি ধাপে ধাপে কাজ করা মডিউল দেওয়া হয়েছে, যা প্রত্যাখ্যাত ট্যাকটিক বাতিল না করে Lean-এর ত্রুটি বিবেচনায় নিয়ে সংশোধক মডেলকে সেটি সর্বোচ্চ R বার সংশোধন করতে বলে; Kটি প্রার্থী থাকলে এতে সমাধান হওয়া সমস্যার হার বাড়ে। LeanDojo এবং Lean Workbook-এ পরীক্ষা থেকে দেখা যায়, এই উন্নতির বেশিরভাগই আসে অগভীর নির্বাহগত ব্যর্থতা থেকে, তবে এর বিনিময়ে অনুসন্ধানের সময় বেড়ে যায়।
16 নভেম্বর 2026
Genesis Steering পদ্ধতি: ফাইন-টিউনিংয়ে ব্যবহৃত ডেটার ওপর অ্যাক্টিভেশন নিয়ন্ত্রণ
এই পদ্ধতি ফাইন-টিউনিং ডেটায় থাকা বৈপরীত্যপূর্ণ উদাহরণ থেকে একটি নিয়ন্ত্রণ ভেক্টর বের করে; সেগুলো পাওয়া না গেলে membership inference-এর মাধ্যমে সম্ভাব্য প্রশিক্ষণ নমুনা বেছে নিয়ে একটি প্রক্সি সেট তৈরি করে। তাত্ত্বিক অংশে সিদ্ধান্তসীমার দিকে সর্বোত্তম স্থানচ্যুতি এবং প্রক্সি ডেটা থেকে অনুমানের বিবরণ দেওয়া হয়েছে; পরীক্ষায় দেখা গেছে, Tülu-3-8B-এর অভ্যন্তরীণ ডেটা বাহ্যিক সেটের তুলনায় বেশি স্পষ্ট প্রভাব ফেলে, অন্যদিকে Llama-3.1-8B-Instruct-এ MIA-প্রক্সির কার্যকারিতা দিকনির্দেশের স্থানচ্যুতিগুলোর পারস্পরিক অনুপাতের কারণে সীমিত।
16 নভেম্বর 2026