
OpenAI প্রতিশ্রুতি দিয়েছে: তাদের চিপ Jalapeño প্রতিযোগীদের সমাধানের চেয়ে দ্রুত এবং সাশ্রয়ী হবে
কোম্পানিটি দাবি করছে যে, Broadcom-এর সাথে যৌথভাবে তৈরি ইনফারেন্স প্রসেসরটি একাধিক AI মডেলের পরীক্ষায় শক্তি দক্ষতা এবং প্রতিক্রিয়ার গতিতে Nvidia-এর এক্সিলারেটরকে ছাড়িয়ে যায়। বছরের শেষ নাগাদ অল্প পরিমাণে চিপ স্থাপনের পরিকল্পনা থাকলেও, তারা Nvidia-এর সম্পূর্ণ বহর প্রতিস্থাপন করতে চায় না।
OpenAI জালাপেনো চিপে বাজি ধরেছে: দ্রুততর, আরও সাশ্রয়ী এবং প্রায় বিক্রিতে
বড় ভাষার মডেল স্থাপনের কথা এলে, ইঞ্জিনিয়ারদের সবসময় একটি সমঝোতার সন্ধান করতে হয়: হয় সিস্টেমটি খুব দ্রুত সাড়া দেয়, কিন্তু অনুরোধের চাপ সহ্য করতে কষ্ট হয়, অথবা এটি বিশাল লোড হজম করতে সক্ষম, কিন্তু লক্ষণীয় বিলম্বের মূল্যে। OpenAI নিশ্চিত যে তারা এমন একটি সমাধান খুঁজে পেয়েছে যা এই দ্বন্দ্ব দূর করে। কোম্পানির নিজস্ব চিপ, যার নাম রাখা হয়েছে Jalapeño, ডেভেলপারদের দাবি অনুযায়ী, একই সাথে কম বিলম্ব এবং উচ্চ থ্রুপুট প্রদর্শন করে। OpenAI-এর হার্ডওয়্যার বিভাগের ভাইস প্রেসিডেন্ট রিচার্ড হো-এর মতে, নতুন পণ্যটি "দুই জগতের সেরাটি" অফার করে।
Jalapeño একটি সার্বজনীন প্রসেসর নয়, বরং একটি কাস্টম ইন্টিগ্রেটেড সার্কিট (ASIC), যা Broadcom-এর সাথে অংশীদারিত্বে তৈরি। চিপটি একটি নির্দিষ্ট কাজের জন্য তৈরি — ইনফারেন্স, অর্থাৎ প্রশিক্ষিত মডেলগুলিকে সরাসরি চালানো যাতে তারা কাজ সম্পাদন করতে পারে এবং এজেন্ট হিসেবে পরিচালনা করতে পারে। জুন মাসে ঘোষিত, এখন এটি প্রথমবারের মতো অফিসিয়াল পরীক্ষার ফলাফল পেয়েছে, যাকে কোম্পানি বৈপ্লবিক বলতে দ্বিধা করছে না।
পারফরম্যান্স পরীক্ষায় কী দেখা গেছে
চিপের ক্ষমতা মূল্যায়নের জন্য OpenAI তাদের নিজস্ব বেঞ্চমার্ক প্ল্যাটফর্ম InferenceX ব্যবহার করেছে। তুলনার মানদণ্ড হিসেবে Nvidia GB200 এবং GB300 সুপারচিপগুলিতে সর্বোচ্চ রেকর্ড করা ফলাফল নেওয়া হয়েছিল। পরীক্ষাগুলি তিনটি জনপ্রিয় মডেলে পরিচালিত হয়েছিল: GPT-OSS 120B, DeepSeek R1 এবং Kimi K2.5 1T।
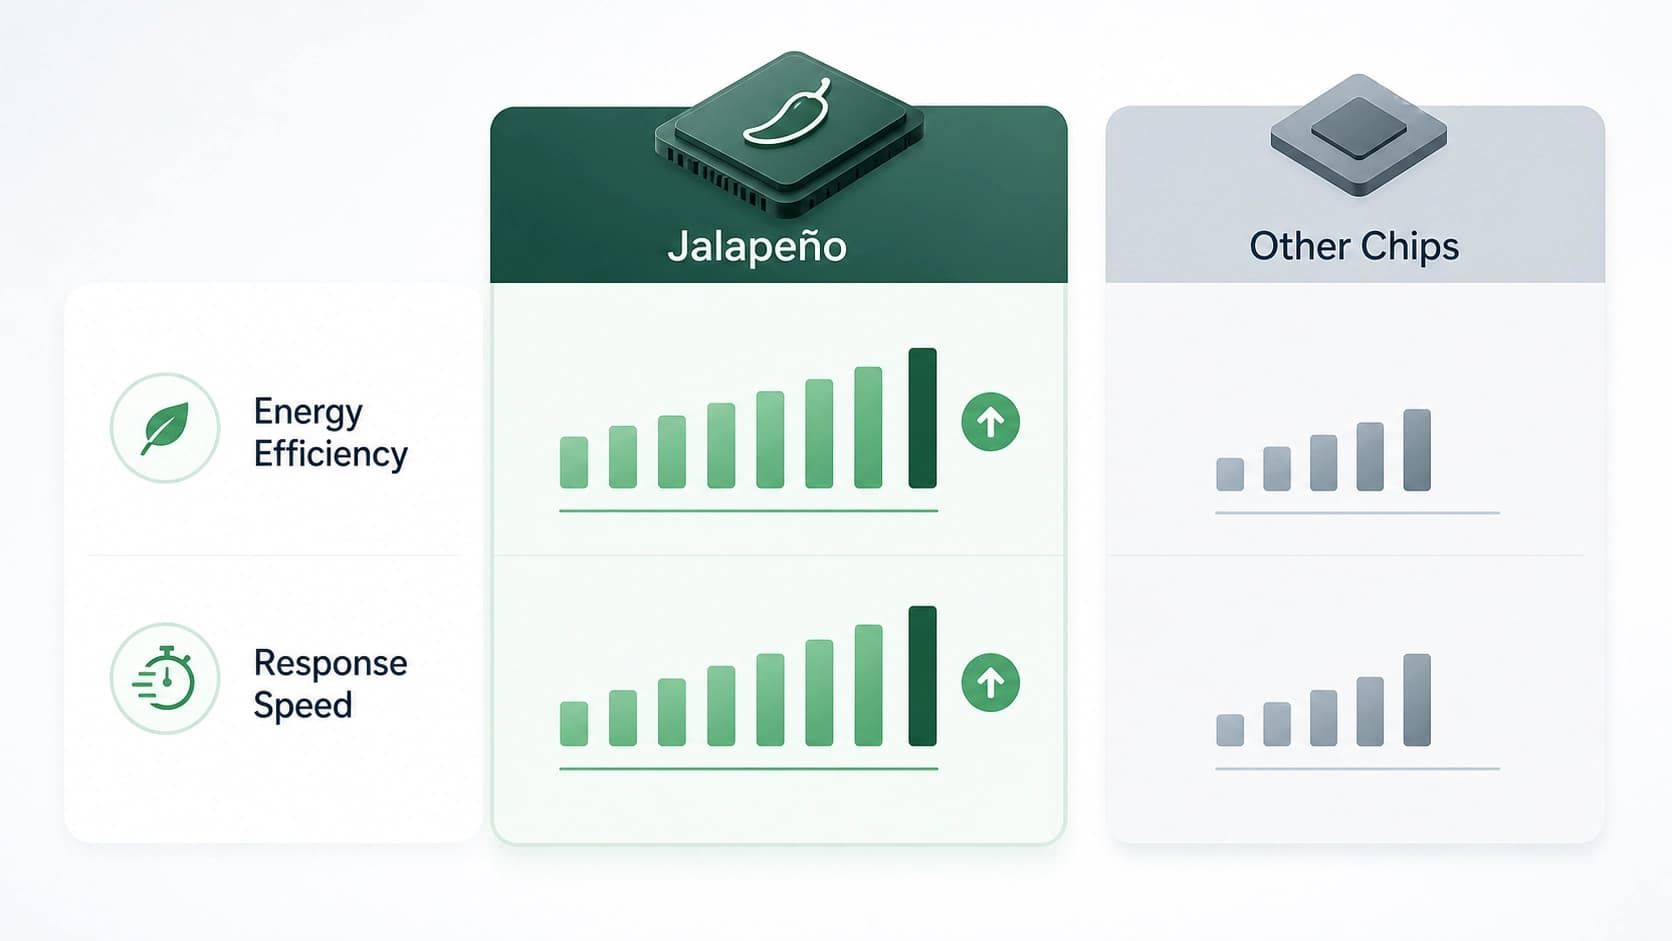
কোম্পানি দাবি করে যে ফলাফলগুলি впечатляющими ছিল। মডেলের উপর নির্ভর করে, Jalapeño প্রতিযোগী সিস্টেমের তুলনায় প্রতি ওয়াটে 1.5–1.9 গুণ বেশি গণনা প্রদর্শন করেছে। সহজ ভাষায়, এর অর্থ হল প্রতিটি ব্যয় করা কিলোওয়াট শক্তির জন্য নতুন চিপ উল্লেখযোগ্যভাবে বেশি দরকারী কাজ সম্পাদন করে। এটি এমন এক যুগে অত্যন্ত গুরুত্বপূর্ণ যখন ডেটা-সেন্টারগুলির বিদ্যুৎ বিল প্রধান ব্যয়ের একটি হয়ে উঠছে।
প্রতিক্রিয়ার গতিতে পার্থক্যটি আরও লক্ষণীয়। তিনটি পরীক্ষিত মডেলে এন্ড-টু-এন্ড লেটেন্সি Nvidia চিপগুলির রেফারেন্স সিস্টেমের তুলনায় 1.7–3.6 গুণ কম পাওয়া গেছে। বাস্তবে এটি সহকারীদের দ্রুততর প্রতিক্রিয়া, AI এজেন্টদের আরও প্রতিক্রিয়াশীল কর্মকাণ্ড এবং পিক লোডের সময়ও পরিষেবাগুলিতে স্থিতিশীল অ্যাক্সেসের মাধ্যমে প্রকাশ পায়। মডেল যত দ্রুত একটি অনুরোধ প্রক্রিয়া করে, ব্যবহারকারীকে তত কম সময় উত্তরের "টাইপিং" নির্দেশকের দিকে তাকিয়ে থাকতে হয়।
কৌশল: প্রতিস্থাপন নয়, পরিপূরক
এত উজ্জ্বল সূচক থাকা সত্ত্বেও, OpenAI Nvidia-এর সাথে সহযোগিতা ছেড়ে দিতে চায় না। রিচার্ড হো জোর দিয়ে বলেন যে কোম্পানির সামগ্রিক কম্পিউটিং কৌশল বিস্তৃত অংশীদারদের ব্যবহারের উপর ভিত্তি করে, এবং Nvidia একটি মূল অংশীদার হিসেবে রয়ে গেছে। Jalapeño বিদ্যমান চিপগুলির বহর প্রতিস্থাপন করবে না, বরং অবকাঠামো স্কেল করার একটি গুরুত্বপূর্ণ উপাদান হয়ে উঠবে।
চিপের প্রথম প্রজন্মটি চলতি বছরের শেষ নাগাদ "স্বল্প পরিমাণে" স্থাপনের পরিকল্পনা করা হয়েছে। পূর্ণ-স্কেল ক্ষমতা বৃদ্ধি 2027 সালে শুরু হবে। কোম্পানি ইচ্ছাকৃতভাবে পরের বছরে ব্যবহার করার পরিকল্পনা করা চিপের সঠিক সংখ্যা প্রকাশ করছে না। এদিকে, Jalapeño-এর দ্বিতীয় এবং তৃতীয় প্রজন্মের উপর কাজ ইতিমধ্যেই চলছে, যা এই দিকটির দীর্ঘমেয়াদী প্রকৃতি নির্দেশ করে — অনেক পরীক্ষা-নিরীক্ষার বিপরীতে যা কখনও ব্যবহারিক পর্যায়ে পৌঁছায় না।
এই প্রকল্পের সাফল্য বড় AI মডেল অপারেটরদের সীমিত সংখ্যক চিপ সরবরাহকারীর উপর নির্ভরতা উল্লেখযোগ্যভাবে কমাতে পারে। নিজস্ব ASIC গুলি OpenAI-এর নির্দিষ্ট অ্যালগরিদম এবং কাজের চাপের সাথে স্থাপত্যটিকে আরও সুনির্দিষ্টভাবে মানিয়ে নেওয়ার অনুমতি দেয়, সম্পদ সাশ্রয় করে এবং বাজারে নতুন পণ্য আনার গতি বাড়ায়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
RL সিমুলেটরের ব্যর্থতা নির্ণয়ে ক্যানোনিক্যাল বহুপদী ইনভেরিয়েন্ট: এগুলো আসলে কোথায় কাজে লাগে
এই কাজটি পরীক্ষা করে, প্রশিক্ষণযোগ্য গতিবিদ্যার মডেলগুলোতে পদার্থবিজ্ঞানের সূত্র অন্তর্ভুক্ত করা কতটা যুক্তিযুক্ত: ট্র্যাজেক্টরি থেকে আহরিত এবং গ্রোবনার ভিত্তির মাধ্যমে ক্যানোনিকাল রূপে আনা ইনভারিয়ান্টগুলো পূর্বাভাসে সামান্য উন্নতি আনে, তবে রোগনির্ণয়ে কার্যকর—এগুলো লঙ্ঘিত সীমাবদ্ধতাটি কোথায় ঘটেছে তা নির্দিষ্ট করতে এবং নির্দিষ্ট ভুল প্যারামিটার শনাক্ত করতে সাহায্য করে।
10 নভেম্বর 2026
AURA-Eval: কীভাবে যাচাই করবেন যে LLM এজেন্ট ঝুঁকি শনাক্ত করেছে এবং পরবর্তী পদক্ষেপ পরিবর্তন করেছে
এই ফ্রেমওয়ার্ক LLM এজেন্টদের আচরণকে চূড়ান্ত রায় দিয়ে নয়, বরং গুরুত্বপূর্ণ মুহূর্তে ঝুঁকির প্রতিক্রিয়া দিয়ে মূল্যায়ন করে: টুল কলের ধারা মাঝপথে থামিয়ে দেওয়া হয়, এরপর মডেলকে তার যুক্তি ও কাজ চালিয়ে যেতে হয়; আর LLM বিচারকদের একটি প্যানেল ঝুঁকি শনাক্তকরণ, পদক্ষেপের ধরন ও নিরাপত্তা বিশ্লেষণ করে। R-Judge-এর 157টি ট্র্যাজেক্টরি থেকে সংগৃহীত 1249টি কাজে, 20টি মডেলের নিরাপদ পথ না থাকলে অনিরাপদ পদক্ষেপ নেওয়ার প্রবণতা বেড়ে যায়; আর কাজ সম্পন্ন হওয়ার আগে তদারকি তুলে নিলে শুরুতে নিরাপদ থাকা ঘটনাগুলোর 52,3% অনিরাপদ হয়ে ওঠে।
10 নভেম্বর 2026
চের্ন–সাইমনস রিজার্ভারের স্মৃতি: সংযোগের স্বায়ত্তশাসিত গতিবিদ্যা এবং ঘনত্ব পরিবহন
এই নিবন্ধে আলোচনা করা হয়েছে, কীভাবে একটি রিজার্ভয়ার ইনপুট সিগন্যালের ইতিহাস একই সঙ্গে ঘনত্বের বণ্টন এবং জ্যামিতিক স্বাধীনতার মাত্রায় সংরক্ষণ করে। চারটি প্রক্রিয়ার তুলনা দেখায় যে কারেন্ট একটি স্বতন্ত্র সংযুক্তি উপাদান তৈরি করে, যা ঘনত্বের পরবর্তী প্রতিক্রিয়া পরিবর্তন করে; আর পরিমাপ করা সব বৈশিষ্ট্য বিবেচনায় নিলে ইমপালসের ক্রম ডিকোড করার ক্ষেত্রে সামান্য উন্নতি হয়।
10 নভেম্বর 2026