
মাথা ও ঘাড়ের টিউমারের প্রোটন পরিকল্পনার জন্য প্রমাণভিত্তিক ফিডব্যাক লুপসহ সমন্বিত মাল্টি-এজেন্ট AI সিস্টেম
কাজটিতে প্রশিক্ষিত PPO পলিসির সমন্বয় বর্ণনা করা হয়েছে, যা পরিকল্পনার একাধিক বিকল্প দেয়, এবং LLM এজেন্টদের, যারা ক্লিনিক্যাল মেট্রিক ও সীমাবদ্ধতা যাচাই করে কথোপকথনের মাধ্যমে স্পষ্টীকরণ করে; ২১ জন রোগীর তথ্যের ভিত্তিতে, ফাইন-টিউন করা Qwen3-14B নির্দেশনা আরও ভালোভাবে অনুসরণ করেছে এবং অগ্রাধিকারপ্রাপ্ত লক্ষ্যগুলোর পক্ষে সমঝোতাকে এগিয়ে নিতে সাহায্য করেছে। ব্যবহারিক উপসংহার হলো—প্রতিদ্বন্দ্বী সীমাবদ্ধতাগুলোর ওপর নিয়ন্ত্রণ বজায় রেখেই স্বয়ংক্রিয় DRL পরিকল্পনাকে পরিচালিত কথোপকথনের মাধ্যমে আরও সমৃদ্ধ করা যায়।
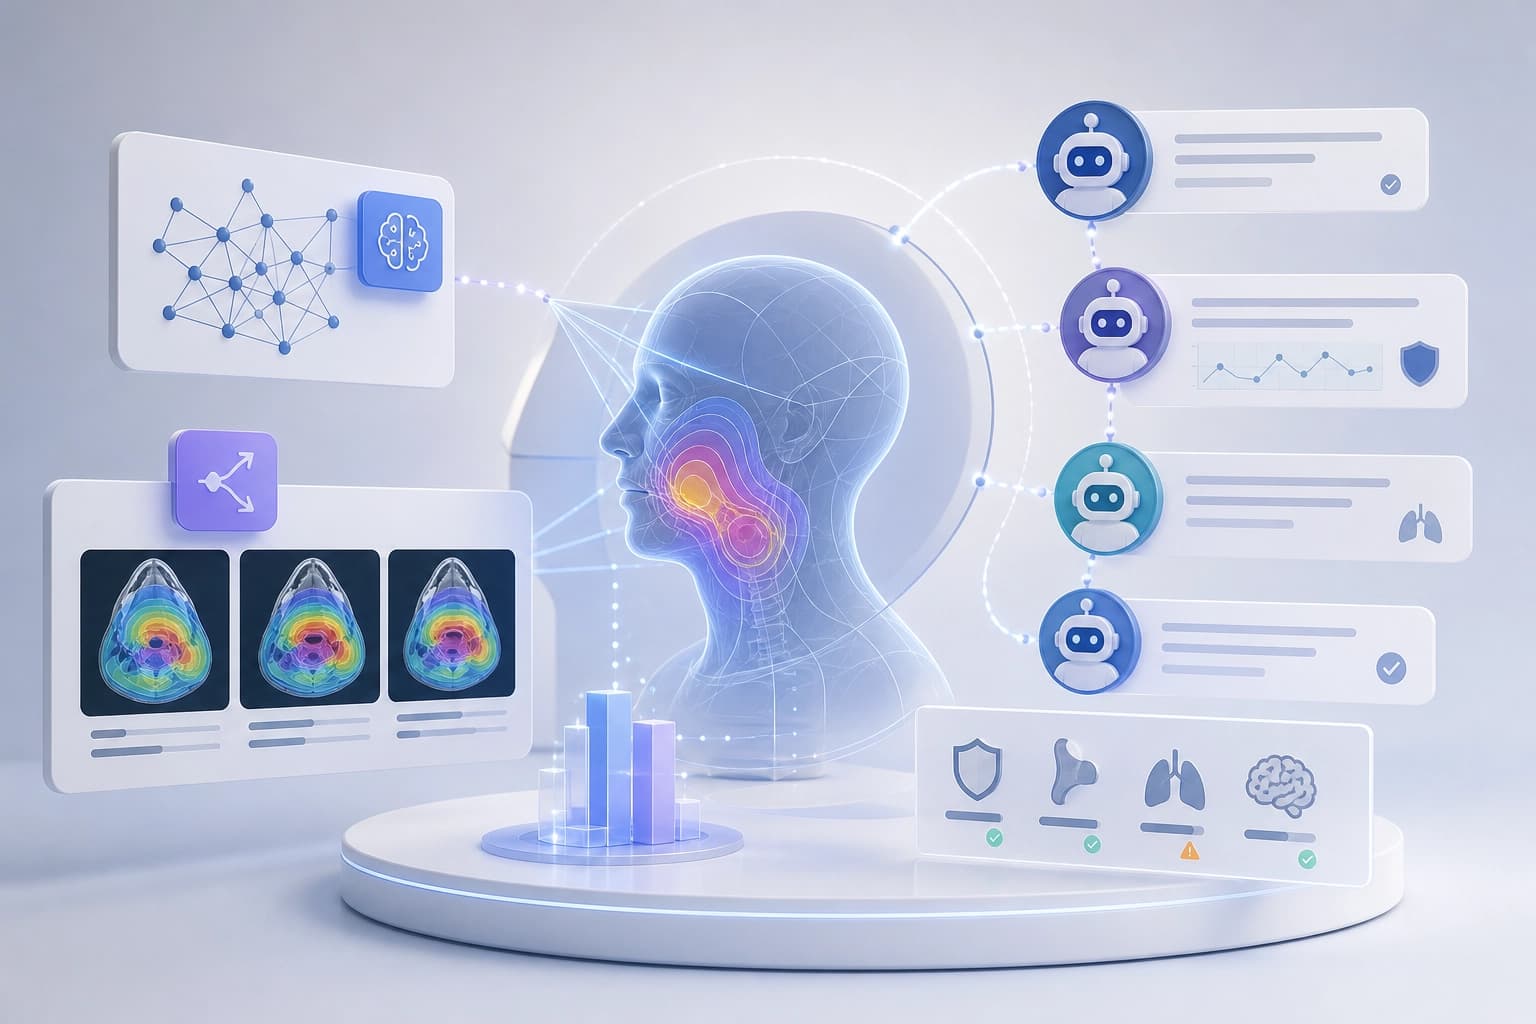
সমন্বিত স্থাপত্য: প্রজন্ম ও পরিমার্জন
Qingqing Wang, Liqiang Xiao এবং Chang Chang ২০২৬ সালের ২১ অক্টোবর arXiv-এ একটি প্রবন্ধ প্রকাশ করেন (arXiv:2610.29010)। এতে তাঁরা মাথা ও ঘাড়ের ক্যান্সারের জন্য PBS প্রোটন থেরাপির একটি ব্যবস্থা বর্ণনা করেছেন। ব্যবস্থাটি DRL-ভিত্তিক স্বয়ংক্রিয় পরিকল্পনা এবং LLM-এর সাহায্যে পরিকল্পনার সংলাপভিত্তিক পরিমার্জনকে একত্রিত করে।
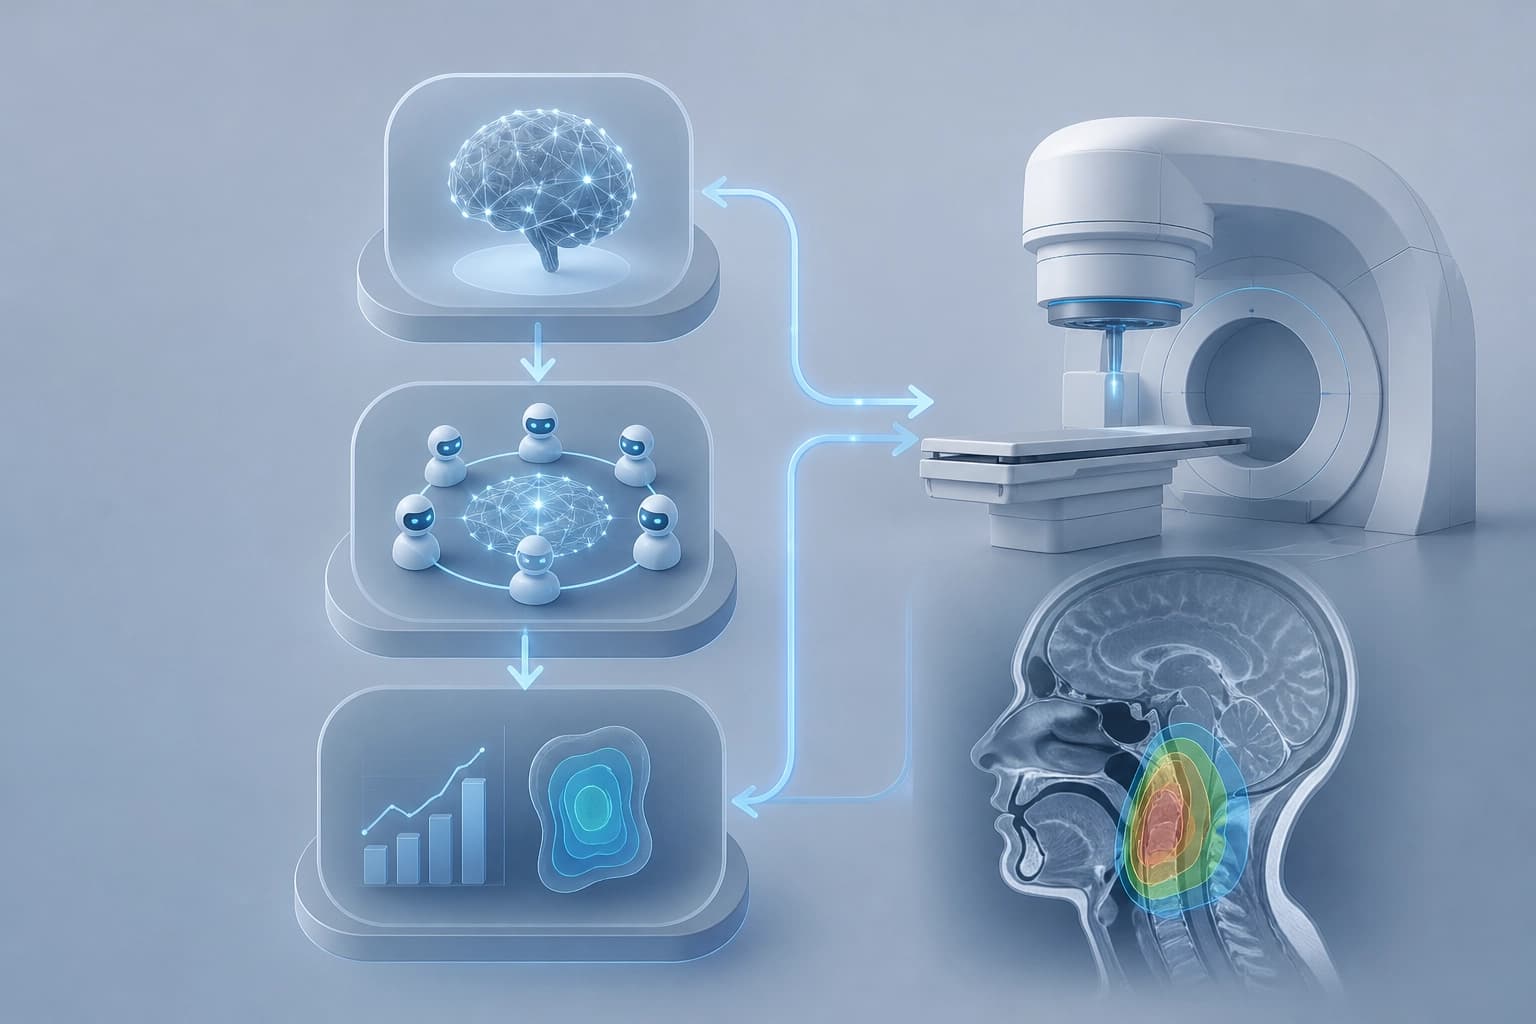
DRL-ভিত্তিক স্বয়ংক্রিয় ধাপটি একগুচ্ছ পরিকল্পনা তৈরি করে। ব্যবস্থাটি একটি পরিকল্পনাকে লক্ষ্য পরিকল্পনা হিসেবে বেছে নেয় এবং পরিমার্জনের সময় বাকিগুলোকে রেফারেন্স হিসেবে ব্যবহার করে। জটিল ক্ষেত্রের জন্য ব্যবস্থাটিতে স্বাভাবিক ভাষায় সংলাপের মাধ্যমে পরিকল্পনা পরিমার্জনের একটি বহু-এজেন্ট LLM স্থাপত্য রয়েছে। সারকথা: এই পদ্ধতিতে স্বয়ংক্রিয় প্রজন্মকে তথ্যনির্ভর সংলাপভিত্তিক পরিমার্জন থেকে আলাদা রাখা হয়েছে।
PPO-তে স্বয়ংক্রিয় পরিকল্পনা প্রজন্ম
স্বয়ংক্রিয় ধাপটি PPO policy network-এর ওপর নির্ভরশীল। লেখকেরা কোনো মানুষের অংশগ্রহণ ছাড়াই নেটওয়ার্কটিকে প্রশিক্ষণ দিয়েছেন; এটি প্রথমে একাধিক পরিকল্পনা তৈরি করে। মাথা ও ঘাড়ের ক্যান্সারে আক্রান্ত ২১ জন রোগীর তথ্য ব্যবহার করে প্রশিক্ষণ ও মূল্যায়ন করা হয়েছিল। প্রত্যেক রোগীর জন্য লেখকেরা ৫টি PPO পরিকল্পনা তৈরি করেছিলেন।
একাধিক পরিকল্পনার এই সমষ্টি লক্ষ্য পরিকল্পনা বেছে নেওয়ার উপকরণ এবং পরিমার্জনের জন্য রেফারেন্সভিত্তি জোগায়। মানদণ্ডটি হলো: স্বয়ংক্রিয় প্রজন্মে একটি নয়, একগুচ্ছ পরিকল্পনা তৈরি হওয়া উচিত। তাহলে পরিমার্জন প্রক্রিয়ার ভিত্তি থাকবে।
বহু-এজেন্ট পরিমার্জন প্রক্রিয়া
জটিল ক্ষেত্রের জন্য ব্যবস্থাটি একটি বহু-এজেন্ট LLM স্থাপত্য ব্যবহার করে। এটি স্বাভাবিক ভাষায় পারস্পরিক যোগাযোগের মাধ্যমে পরিকল্পনা পরিমার্জন করে। এই প্রক্রিয়ায় রয়েছে planning agent, chatbot এবং evaluation agent।
Planning agent তথ্যের ভিত্তিতে সংশোধনের প্রস্তাব দেয়। Chatbot সংলাপের জন্য একক ইন্টারফেস হিসেবে কাজ করে। Evaluation agent প্রমাণভিত্তিক কাঠামো তৈরি করে: এটি ক্লিনিক্যাল মেট্রিক সংগ্রহ করে এবং সীমাবদ্ধতার লঙ্ঘন শনাক্ত করে।
এই প্রক্রিয়ায় ক্লিনিক্যাল মেট্রিক ও সীমাবদ্ধতার মাধ্যমে পরিমার্জন যাচাই করা যায়। মানদণ্ডটি হলো: পরিমার্জন শুধু সংলাপের লেখার ওপর নির্ভর না করে পরিমাপযোগ্য ক্লিনিক্যাল সূচকের ওপর ভিত্তি করে হওয়া উচিত।
Planning agent-এর প্রশিক্ষণ
Planning agent Qwen3-14B-এর ওপর ভিত্তি করে কাজ করে। এটি আগে তৈরি করা পরিকল্পনার তথ্যের ভিত্তিতে সুপারিশের যুক্তি তুলে ধরে। নির্দিষ্ট কাজের জন্য অতিরিক্ত প্রশিক্ষণে লেখকেরা SFT এবং GRPO ব্যবহার করেছেন।
ভিত্তিমূলক LLM-এর তুলনায়, অতিরিক্ত প্রশিক্ষণপ্রাপ্ত Qwen3-14B উন্নত সক্ষমতা দেখিয়েছে। এটি নির্দেশনা আরও ভালোভাবে অনুসরণ করে, তথ্য সংগ্রহ করে এবং বিষয়ভিত্তিক যুক্তি করতে পারে।
| মানদণ্ড | ভিত্তিমূলক LLM | অতিরিক্ত প্রশিক্ষণপ্রাপ্ত Qwen3-14B |
|---|---|---|
| নির্দেশনা অনুসরণ | ভিত্তিমূলক সক্ষমতা | উন্নত সক্ষমতা |
| তথ্য সংগ্রহ | ভিত্তিমূলক সক্ষমতা | উন্নত সক্ষমতা |
| বিষয়ভিত্তিক যুক্তি | ভিত্তিমূলক সক্ষমতা | উন্নত সক্ষমতা |
ব্যবহারিক মানদণ্ড: planning agent-এর ক্ষেত্রে শুধু প্রজন্ম নয়, নির্দেশনা অনুসরণ, তথ্য সংগ্রহ এবং বিষয়ভিত্তিক যুক্তিও গুরুত্বপূর্ণ। SFT এবং GRPO-তে অতিরিক্ত প্রশিক্ষণ এই গুণগুলোকে আরও জোরদার করে।
মূল্যায়ন ও ক্লিনিক্যাল সমঝোতা
লেখকেরা নির্দেশনাসহ পরিমার্জনের জন্য ৫০টি পরিকল্পনা বেছে নিয়েছিলেন। ব্যবহারকারীর অগ্রাধিকার দেওয়া লক্ষ্যগুলো সংশোধনের মাধ্যমে আরও কার্যকরভাবে উন্নত হয়েছিল। একই সঙ্গে প্রতিদ্বন্দ্বী লক্ষ্যগুলোর অবনতি সীমিত ছিল। লেখকেরা জানিয়েছেন, রোগীভেদে পরিকল্পনা পরিমার্জনের সময় সংশোধনের ফলে আরও উপযুক্ত ক্লিনিক্যাল সমঝোতা অর্জন করা গেছে।
ব্যবহারিক মানদণ্ড: অগ্রাধিকারপ্রাপ্ত লক্ষ্যগুলোর উন্নতি এবং প্রতিদ্বন্দ্বী লক্ষ্যগুলোর সীমিত অবনতির ভিত্তিতে পরিমার্জন মূল্যায়ন করুন।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
অভিজ্ঞতাভিত্তিক পরীক্ষা-নিরীক্ষার বদলে গণনাভিত্তিক বাছাই: ব্যাটারির উপকরণ নিয়ে নতুন পদ্ধতি
এই উপাদানটি দেখায়, কীভাবে গণনামূলক ডেটাবেস, মেশিন লার্নিং এবং জেনারেটিভ মডেল সম্ভাবনাময় সংমিশ্রণের পরিসর সংকুচিত করে, আর স্বয়ংক্রিয় পরীক্ষাগারগুলো সেগুলোর যাচাই দ্রুত করে; তবে চূড়ান্ত ফল সংশ্লেষণ ও পরীক্ষার ওপর নির্ভর করে, যেখানে পূর্বাভাস বাস্তব পরিবাহিতা থেকে ভিন্ন হতে পারে।
20 নভেম্বর 2026
টাস্ক পুলের আকার বাড়ার সঙ্গে এজেন্ট বেঞ্চমার্কের বিবর্তন: প্রমাণ নির্বাচন ও ধারাবাহিক রেসের ভূমিকা
এই কাজটি ব্যাখ্যা করে, কাজের সংখ্যা বাড়ালে কেন এজেন্টিক বেঞ্চগুলোর বিবর্তন আরও খারাপ হতে পারে: এর কারণ তথ্যের পরিমাণ নয়, বরং প্রমাণের অনুপযুক্ত নির্বাচন। প্রস্তাবিত Successive Scale Racing পালাক্রমে বৈচিত্র্যময় কাজের সমন্বয় বেছে নেয় এবং কম খরচে প্রার্থীদের তুলনা করে; তিনটি বেঞ্চমার্কে পুলের আকার 40 থেকে 200-তে বাড়ানোর সময় এটি সফল রানগুলোর হার বাড়িয়েছে, যেখানে বেসলাইন পদ্ধতিগুলোর কার্যকারিতা কমেছে এবং যাচাইকরণ রান প্রায় 60% কমেছে।
19 নভেম্বর 2026
মডেলগুলোর পারস্পরিক প্ররোচনা: ঘোষিত অবস্থান সংলাপে তাদের আচরণের সঙ্গে মেলে না
জলবায়ু পরিবর্তনের কারণ নিয়ে নিয়ন্ত্রিত বিতর্কে GPT-6 Luna ও Gemini 2.5 Flash Lite-এর চারটি জুটি অবস্থানের কাছাকাছি আসা বা দূরে সরে যাওয়ার ভিন্ন গতিপ্রকৃতি দেখায়। প্ররোচিত করার সরাসরি নির্দেশ স্থায়ী প্রভাব ফেলে না, আর ঘোষিত অবস্থান ও তর্কের ধরন এক বিষয় নয়।
19 নভেম্বর 2026