
লুকানো MoE আর্কিটেকচার সূচক LLM-এর মিথ্যা উত্তর প্রকাশ করে
InnerExpert-এর নতুন পদ্ধতি MoE-মডেলগুলিতে রাউটিং এবং বিশেষজ্ঞদের মতবিরোধের বৈশিষ্ট্যগুলি ব্যবহার করে টোকেন-ভিত্তিকভাবে উদ্ভাবিত অংশগুলি চিহ্নিত করে। পদ্ধতিটি ম্যানুয়াল লেবেলিং ছাড়াই প্রশিক্ষিত হয় এবং পাঁচটি ডেটাসেটে একক পাসে উত্তর-স্তরে 0.91 পর্যন্ত এবং টোকেন-স্তরে 0.76 পর্যন্ত নির্ভুলতা দেখায়।
কেন LLM-এর মিথ্যা আত্মবিশ্বাস শুধু একটি বাগ নয়
আধুনিক ভাষার মডেলগুলো মসৃণ ও বিশ্বাসযোগ্যভাবে চিন্তা প্রকাশ করতে শিখেছে। কিন্তু এই বিশ্বাসযোগ্যতার আড়ালে প্রায়ই লুকিয়ে থাকে যা বিশেষজ্ঞরা হ্যালুসিনেশন বলে থাকেন: মডেলটি বিশ্বাসযোগ্য শোনায় এমন, কিন্তু সম্পূর্ণ কাল্পনিক কনটেন্ট তৈরি করে। ব্যবহারকারীর কাছে এটি একটি সমান, আত্মবিশ্বাসী লেখার মতো দেখায় — এবং ঠিক এই কারণেই সমস্যাটি বিপজ্জনক।
বেশিরভাগ পরিচিত হ্যালুসিনেশন ডিটেক্টর মোটামুটিভাবে কাজ করে। তারা পুরো উত্তরটি বা পৃথক বাক্যগুলো মূল্যায়ন করে, এমন কিছু জানিয়ে দেয় যেমন «এখানে, মনে হচ্ছে একটি ভুল আছে»। কিন্তু মডেলটি ঠিক কোন জায়গায় «একটি তথ্য উদ্ভাবন করেছে» তা বোঝার জন্য আরও সূক্ষ্ম পরীক্ষা প্রয়োজন — পৃথক টোকেনের স্তরে। শুধুমাত্র টোকেন-পরবর্তী ডিটেকশনই মিথ্যা অংশটিকে চিহ্নিত করতে এবং বাকি লেখা না ছুঁয়ে নির্দিষ্টভাবে জেনারেশনে হস্তক্ষেপ করতে দেয়।
MoE-মডেলগুলো ঘটনাক্রমে সূত্র দেয়
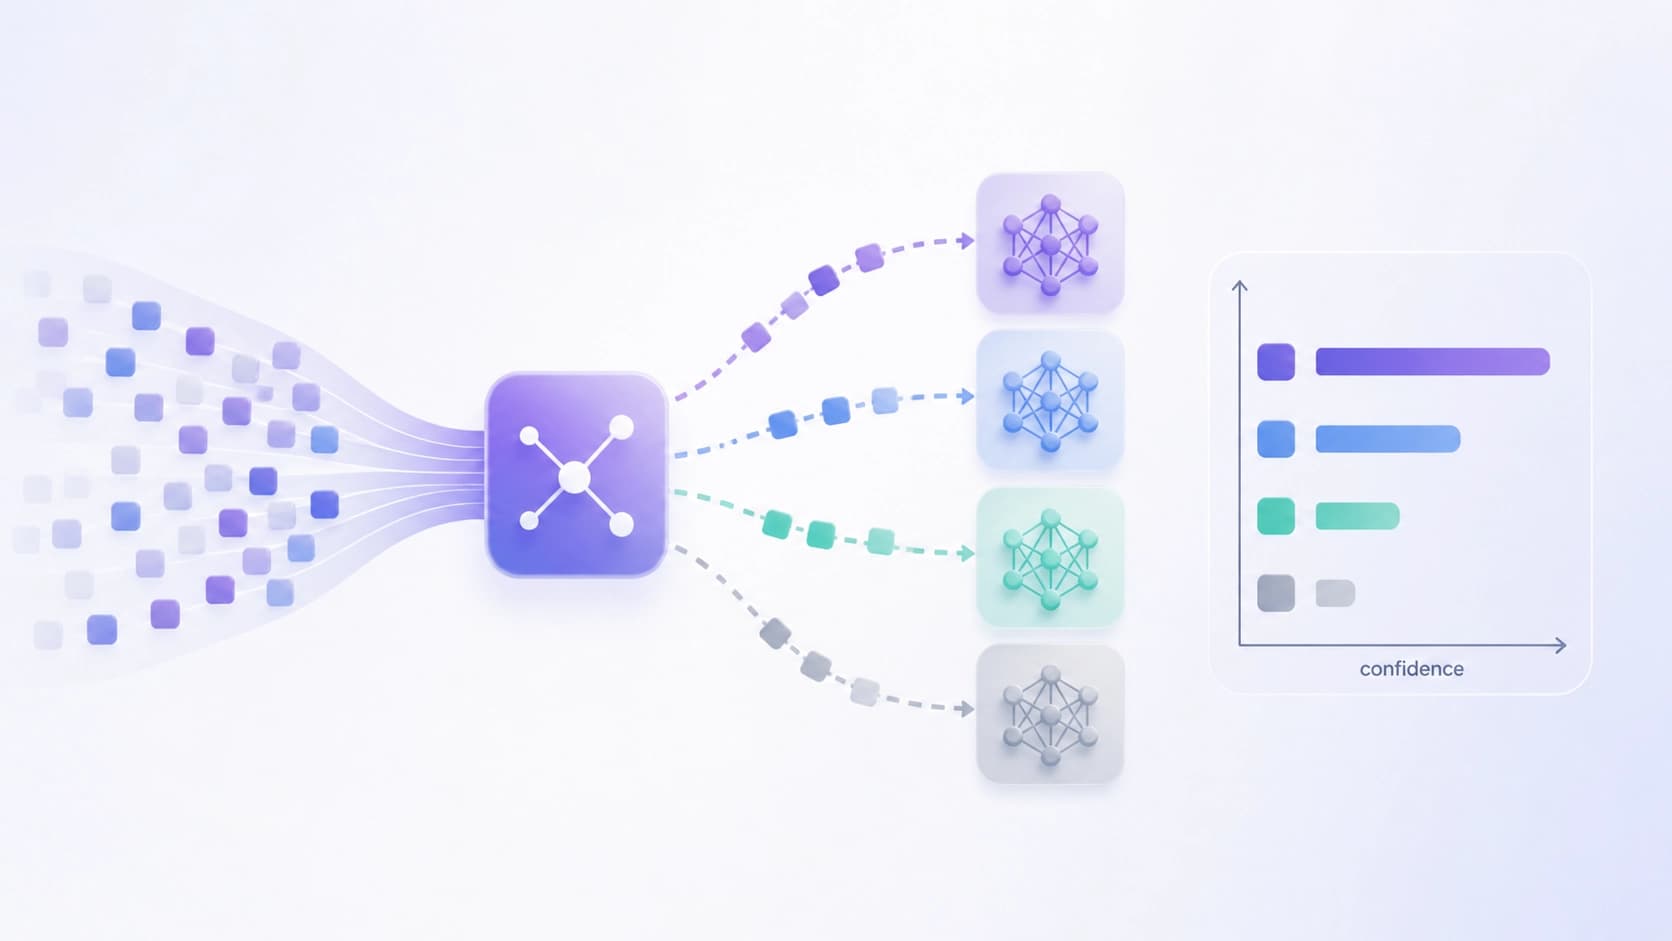
Mixture-of-Experts (MoE) ধরনের আর্কিটেকচারে একটি কৌতূহলোদ্দীপক নীতি কাজ করে: একটি ফরোয়ার্ড পাসে পুরো নেটওয়ার্ক নয়, শুধুমাত্র «বিশেষজ্ঞদের» একটি বিরল উপসেট সক্রিয় হয়। কাকে ডাকা হবে সেই নির্বাচন করে রাউটিং মেকানিজম। এবং ঠিক এই মুহূর্তেই অভ্যন্তরীণ সংকেত তৈরি হয়, যা ঘন আর্কিটেকচারে একেবারেই থাকে না:
- রাউটারের এনট্রপি — মডেলটি কোন বিশেষজ্ঞের কাছে যেতে হবে তা নিয়ে কতটা «নিশ্চিত নয়»;
- বিশেষজ্ঞদের মতভেদ — তাদের মধ্যবর্তী ফলাফলগুলো কতটা আলাদা;
- বিশেষজ্ঞ ব্যবহারের প্যাটার্ন — কোন বিশেষজ্ঞরা বেশি কাজে যুক্ত হন।
আগে এই সংকেতগুলো হ্যালুসিনেশন খোঁজার জন্য প্রায় ব্যবহার করা হতো না। গবেষক জোয়াও ফনসেকা, রদ্রিগো রদ্রিগেজ এবং পাওলো রোমানো arXiv:2608.17687 নিবন্ধে দেখিয়েছেন যে এটি ছিল ভুল: লুকানো সূচকগুলো সেই মুহূর্তগুলো চিহ্নিত করতে সক্ষম যখন মডেলটি কল্পনা করতে শুরু করে। কাজটি ১৮ আগস্ট ২০২৬ তারিখে arXiv-এ উপস্থাপিত হয়েছিল।
InnerExpert: ডিটেক্টর যা মডেলের ভেতরে দেখে
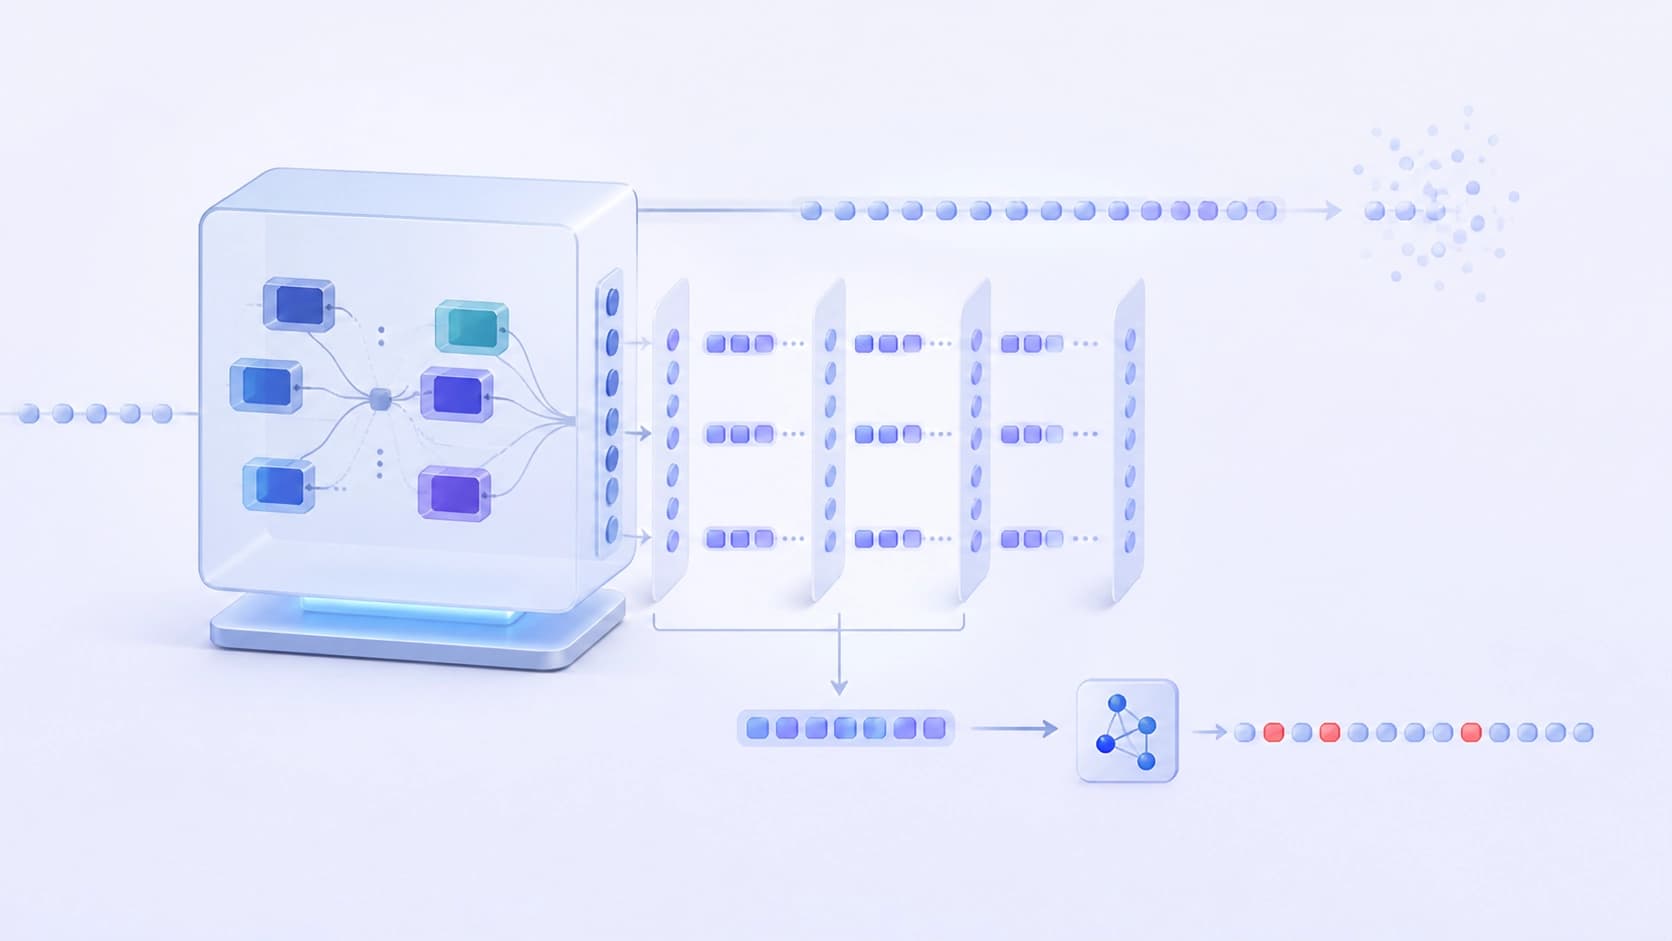
লেখকদের প্রস্তাবিত পদ্ধতি InnerExpert দুই ধরনের ডেটা একত্রিত করে: MoE-নির্দিষ্ট রাউটিং-স্তরের সংকেত এবং ট্রান্সফরমারের মানক অভ্যন্তরীণ উপস্থাপনা। এই সবকিছু প্রতিটি টোকেনের জন্য কমপ্যাক্ট ফিচার ভেক্টরে সংগ্রহ করা হয়। তারপর একটি হালকা ক্লাসিফায়ার এই ভেক্টরগুলো প্রক্রিয়া করে এবং নির্ধারণ করে টোকেনটি হ্যালুসিনেশন কিনা।
মূল বৈশিষ্ট্য — স্বয়ংক্রিয় প্রশিক্ষণ। ডিটেক্টর প্রশিক্ষণের জন্য লেবেল তৈরি করে LLM-as-a-judge পাইপলাইন, যখন একটি ভাষার মডেল অন্য মডেলের আউটপুট মূল্যায়ন করে। কোনো ম্যানুয়াল অ্যানোটেশন প্রয়োজন হয় না। এর অর্থ হল পাইপলাইনটি আবার চালিয়ে ডিটেক্টরকে দ্রুত নতুন জেনারেটিভ মডেলের সংস্করণের সাথে খাপ খাওয়ানো যায়।
পরীক্ষাগুলো কী দেখিয়েছে
পরীক্ষাগুলো পাঁচটি ডেটাসেট এবং দুটি ভিন্ন MoE-আর্কিটেকচার জুড়ে পরিচালিত হয়েছিল। পরীক্ষায় InnerExpert ধারাবাহিকভাবে বিদ্যমান ডিটেক্টরগুলোর চেয়ে ভালো পারফর্ম করেছে। সেরা ফলাফল পুরো উত্তরের স্তরে 0.91 AUROC এবং পৃথক টোকেনের স্তরে 0.76 AUROC অর্জন করেছে। তাছাড়া এর জন্য একটি মাত্র ফরোয়ার্ড পাস যথেষ্ট — অতিরিক্ত যাচাইকরণ মডেল বা বারবার জেনারেশন চালানোর প্রয়োজন নেই।
উচ্চ answer-level ফলাফল মোটামুটি ফিল্টারিংয়ের জন্য উপযোগী। কিন্তু সত্যিই মূল্যবান সূচক হলো token-level: এটি লেখার মিথ্যা অংশগুলো নির্দিষ্টভাবে খুঁজে বের করতে এবং, উদাহরণস্বরূপ, সেগুলো পুনর্লিখন বা ব্যবহারকারীকে হাইলাইট করতে দেয়। এটি আর «কোথাও একটি ভুল» নয়, বরং উত্তরের একটি নির্দিষ্ট স্থান।
কেন এটি গুরুত্বপূর্ণ
হ্যালুসিনেশন চিকিৎসা, আইন, অর্থ এবং অন্যান্য ভুল-সংবেদনশীল ক্ষেত্রে LLM গ্রহণের অন্যতম প্রধান বাধা হিসেবে রয়ে গেছে। মডেলের অভ্যন্তরীণ সংকেতগুলোতে উঁকি দেওয়ার এবং তার «সন্দেহ» আগে থেকেই দেখার ক্ষমতা — স্বচ্ছ জেনারেশনের দিকে আরেকটি ব্যবহারিক পদক্ষেপ। লুকানো সূচকগুলো সমস্যা থেকে সম্পূর্ণরূপে মুক্তি দেয় না, তবে একটি কার্যকরী হাতিয়ার দেয় যা ইতিমধ্যেই উপলব্ধ।
আলাদাভাবে আকর্ষণীয় যে, হ্যালুসিনেশন নির্ণয়ের জন্ম আর্কিটেকচারের নিজস্ব বৈশিষ্ট্য থেকে হয়েছে। MoE-মডেলগুলো গতি এবং দক্ষতার জন্য তৈরি করা হয়েছিল, এবং তাদের অভ্যন্তরীণ কাঠামো হঠাৎ করে মান নিয়ন্ত্রণের জন্য উপকারী প্রমাণিত হয়েছে। আরও গবেষণা নিশ্চিতভাবে আরও গভীরে যাবে — বিশেষজ্ঞদের ভেতরে এবং রাউটিং মেকানিজমের আরও সূক্ষ্ম সংকেতের দিকে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
OpenCollab: এজেন্টদের প্রোগ্রামযোগ্য সমন্বয়, নিয়ন্ত্রিত রানটাইম পরিবেশ এবং প্রোটোকল মেনে চলার মেট্রিক
ফ্রেমওয়ার্কটি এজেন্টদের পারস্পরিক ক্রিয়াকলাপের কাঠামো নির্ধারণ, পরীক্ষার জন্য একটি অভিন্ন পরিবেশ এবং ইভেন্টের বিস্তারিত ট্রেসিংকে একত্র করে; নতুন প্রবর্তিত Adherence মেট্রিকটি দেখায়, বাস্তব সম্পাদন ঘোষিত কাঠামোর সঙ্গে কতটা সামঞ্জস্যপূর্ণ। বেঞ্চমার্কে Duo কনফিগারেশন নতুন SOTA অর্জন করে, অন্যদিকে একক-এজেন্ট সংস্করণে টোকেন খরচ সবচেয়ে কম।
11 নভেম্বর 2026
Toollery: ফাইন-টিউনিং ছাড়াই কয়েক দশ হাজার বিকল্প থেকে LLM এজেন্টের জন্য টুল নির্বাচন
Toollery দক্ষতা ও টুলের বিবরণের ওপর ভিত্তি করে একটি সার্চ ইনডেক্স তৈরি করে এবং অনুরোধের সময় মডেলকে কেবল সীমিতসংখ্যক সম্ভাব্য প্রার্থী দেয়। কয়েক দশ হাজার ফাংশন পর্যন্ত বিস্তৃত লাইব্রেরিতে চালানো পরীক্ষায় দেখা গেছে, নির্দিষ্ট top-K বজায় রেখেও এই পদ্ধতি বাছাইয়ের মান ধরে রাখতে পারে, যদিও চূড়ান্ত ফল নির্ভর করে ব্যবহারের ধরন এবং প্রোভাইডারের ক্যাশিংয়ের ওপর।
11 নভেম্বর 2026
ড্যাশবোর্ড বিশ্লেষণে GUI এজেন্টদের ধাপে ধাপে ডায়াগনস্টিকস: DashAct বেঞ্চমার্ক
DashAct উপস্থাপন করা হলো—মানুষের দ্বারা যাচাই করা ৩৪৮টি ট্র্যাজেক্টরির একটি বেঞ্চমার্ক, যা ইন্টারঅ্যাকটিভ প্যানেলে GUI এজেন্টদের কাজকে তিনটি ধাপ ও চারটি ভিজ্যুয়াল পরিস্থিতিতে বিশ্লেষণ করে। ফলাফলগুলোতে অ্যাকশন পূর্বাভাস এবং ভিজ্যুয়াল লক্ষ্য শনাক্তকরণে ধারাবাহিক সমস্যা, পাশাপাশি প্রাসঙ্গিক ও স্থানিক সহায়তার ওপর এজেন্টদের প্রতিক্রিয়ার নির্ভরতা দেখা যায়।
11 নভেম্বর 2026