
গণিতে মাল্টিমোডাল মাল্টি-এজেন্ট LLM: সমাধানের ধাপ এবং বিকৃতির বিরুদ্ধে দৃঢ়তা কীভাবে যাচাই করবেন
MAMath-Bench উপস্থাপন করা হয়েছে—১১টি গণিতের বিভাগে ১০০৩টি সমস্যা নিয়ে তৈরি একটি বেঞ্চমার্ক, যাতে পাঠ্য, গ্রাফিক ও অডিও উপকরণ রয়েছে; চূড়ান্ত উত্তরের পাশাপাশি এটি মধ্যবর্তী ধাপ এবং যুক্তির ধারায় প্রতিদ্বন্দ্বিতামূলক পরিবর্তনের প্রতি সিস্টেমের প্রতিক্রিয়াও নথিভুক্ত করে। ফলাফল দেখায়, একাধিক LLM-এর সহযোগিতা যে নির্ভুলতা বাড়াবেই তার নিশ্চয়তা নেই, বরং যুক্তির ব্যাখ্যায় অপ্রয়োজনীয়তা বাড়াতে পারে; আর সূক্ষ্ম কাঠামোগত বিঘ্ন এখনও দুর্বলতার একটি বড় উৎস।
বেঞ্চমার্কটি কী মূল্যায়ন করে
MAMath-Bench হলো একাধিক এজেন্টবিশিষ্ট সিস্টেমের বহুমাত্রিক গাণিতিক যুক্তি মূল্যায়নের একটি বেঞ্চমার্ক। এতে ১১টি গাণিতিক শ্রেণির ১,০০৩টি কাজ রয়েছে। কাজগুলোতে একাধিক কঠিনতার স্তর এবং তিনটি মোডালিটি অন্তর্ভুক্ত: টেক্সট, ছবি ও অডিও।
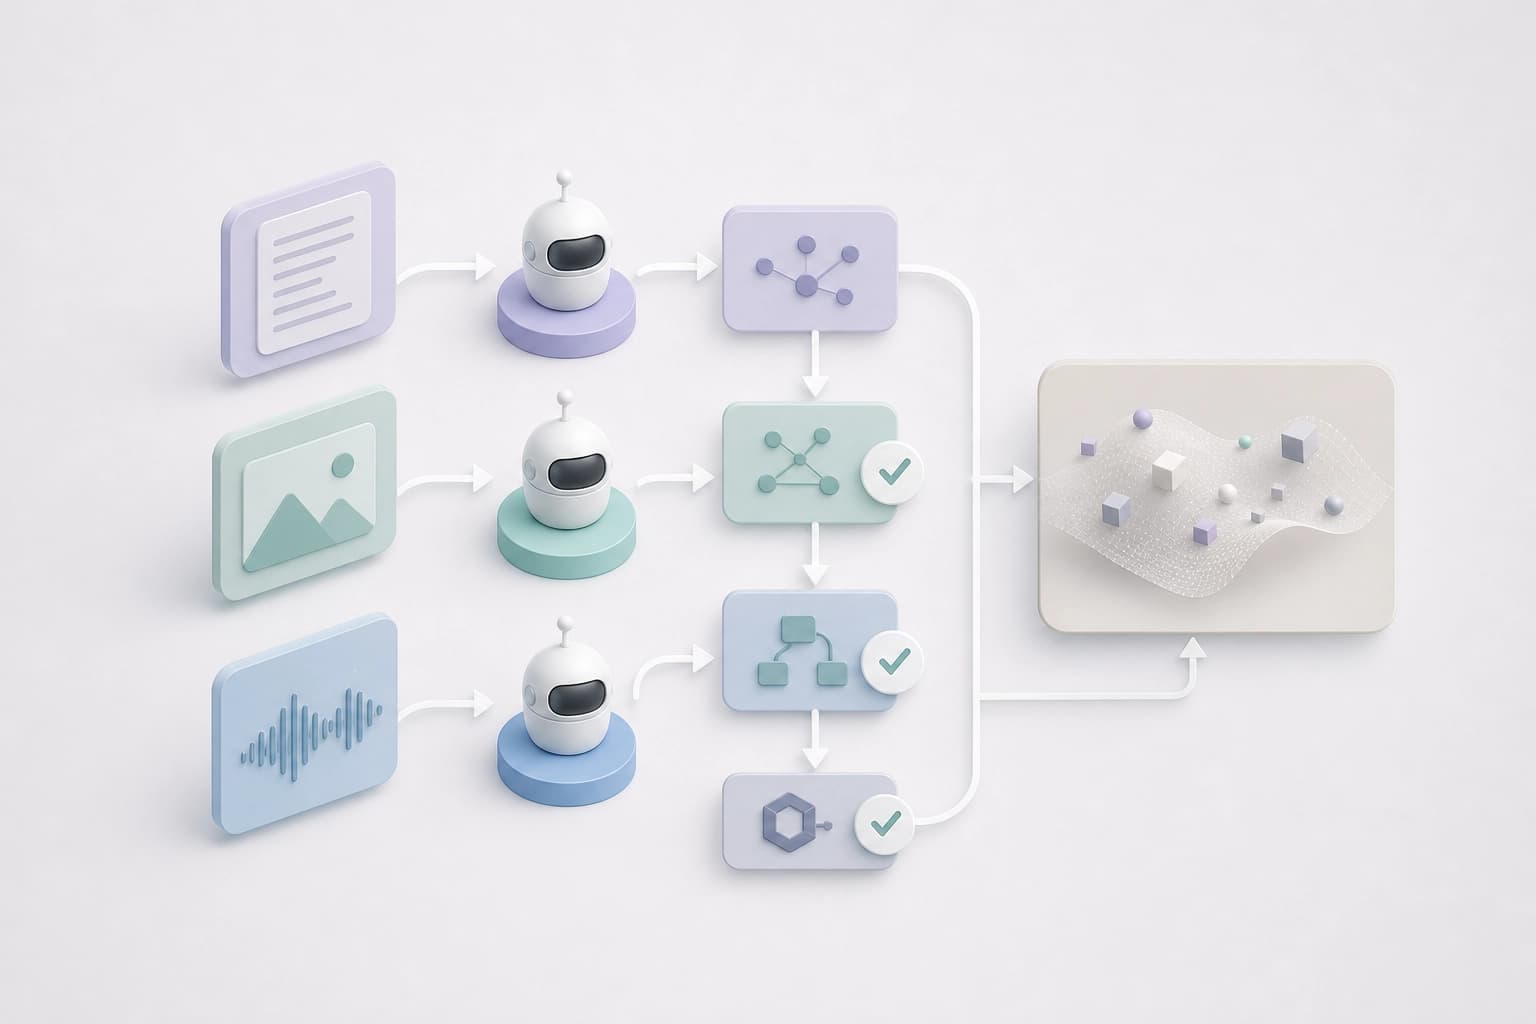
বেঞ্চমার্কটিতে মাইলফলকের বিস্তারিত টীকা রয়েছে। মূল্যায়ন করা হয় তিনটি মাত্রায়:
- কাজটি সঠিকভাবে সমাধান করা হয়েছে কি না;
- যুক্তি প্রক্রিয়ার নির্ভরযোগ্যতা;
- যুক্তির ধারায় প্রতিপক্ষমূলক বিঘ্নের বিরুদ্ধে স্থিতিস্থাপকতা।
ব্যবহারিক মানদণ্ড: এমন মূল্যায়ন বেছে নিন, যা উত্তরের সঠিকতা, প্রক্রিয়ার নির্ভরযোগ্যতা এবং বিঘ্নের বিরুদ্ধে স্থিতিস্থাপকতাকে আলাদা করে। এ ধরনের যাচাইয়ের জন্য শুধু চূড়ান্ত উত্তর যথেষ্ট নয়।
সমাধানের ধাপ যাচাই
মাইলফলকের টীকাগুলো মধ্যবর্তী ধাপ যাচাইয়ের ভিত্তি দেয়। যুক্তি প্রক্রিয়ার নির্ভরযোগ্যতার মূল্যায়ন চূড়ান্ত উত্তরের সঠিকতা থেকে আলাদা। এর ফলে শুধু ফলাফলের ভিত্তিতে নয়, সিস্টেমগুলোর তুলনা করা যায়।
সমাধানের ধাপে যা যাচাই করবেন:
- টীকায় চিহ্নিত মাইলফলকগুলো আছে কি না;
- মধ্যবর্তী ধাপগুলো সেই মাইলফলকের সঙ্গে মেলে কি না;
- যুক্তি প্রক্রিয়ার নির্ভরযোগ্যতাকে স্বতন্ত্র একটি মাত্রা হিসেবে বিবেচনা করা।
যাচাইয়ের মানদণ্ড: সমাধানটি ঠিক কোথায় মাইলফলক থেকে বিচ্যুত হয়েছে তা নথিভুক্ত করুন। শুধু চূড়ান্ত উত্তর দেখে সমাধানের ধাপের গুণমান বোঝা যায় না।
বহু-এজেন্ট ব্যবস্থা: নির্ভুলতা, পরিধি ও পুনরাবৃত্তি
মূল্যায়নে একাধিক এজেন্টের সহযোগিতার তিনটি পৃথক প্রভাব দেখা যায়। শক্তিশালী একক LLM-এর তুলনায় চূড়ান্ত উত্তরের নির্ভুলতা সবসময় বাড়ে না। মধ্যবর্তী যুক্তির পরিধি উল্লেখযোগ্যভাবে উন্নত হতে পারে। পরিধি বাড়ার সঙ্গে যুক্তির পুনরাবৃত্তিও বাড়তে পারে।
| কী তুলনা করবেন | মূল্যায়নে কী দেখা যায় | ব্যবহারিক সিদ্ধান্ত |
|---|---|---|
| চূড়ান্ত উত্তরের নির্ভুলতা | একাধিক এজেন্টের সহযোগিতায় শক্তিশালী একক LLM-এর তুলনায় নির্ভুলতা সবসময় বাড়ে না | বহু-এজেন্ট ব্যবস্থাকে সঠিক উত্তরের নিশ্চয়তা হিসেবে ধরবেন না |
| মধ্যবর্তী যুক্তির পরিধি | সহযোগিতায় পরিধি উল্লেখযোগ্যভাবে বাড়তে পারে | পরিধির উন্নতিকে অন্যান্য মাত্রার সঙ্গে মিলিয়ে দেখুন |
| যুক্তির পুনরাবৃত্তি | পরিধি বাড়ার সঙ্গে পুনরাবৃত্তিও বাড়তে পারে | পরিধি মূল্যায়নের সময় পুনরাবৃত্তি বৃদ্ধিও বিবেচনায় নিন |
নির্বাচনের মানদণ্ড: বহু-এজেন্ট ব্যবস্থাকে নির্ভুলতার নিশ্চয়তা হিসেবে ধরবেন না। চূড়ান্ত উত্তর, পরিধি ও পুনরাবৃত্তির ভিত্তিতে একে শক্তিশালী একক LLM-এর সঙ্গে তুলনা করুন।
প্রতিপক্ষমূলক বিকৃতির বিরুদ্ধে স্থিতিস্থাপকতা
মূল্যায়নে যুক্তির ধারায় প্রতিপক্ষমূলক বিঘ্নের বিরুদ্ধে স্থিতিস্থাপকতাও অন্তর্ভুক্ত। আধুনিক সিস্টেমগুলো যুক্তির প্রতিপক্ষমূলক ত্রুটির কাছে এখনও ঝুঁকিপূর্ণ, বিশেষত সূক্ষ্ম কাঠামোগত বিঘ্নের সঙ্গে সম্পর্কিত ত্রুটির ক্ষেত্রে।
যা যাচাই করবেন:
- যুক্তির ধারায় প্রতিপক্ষমূলক বিঘ্নে সিস্টেমের প্রতিক্রিয়া;
- সূক্ষ্ম কাঠামোগত বিঘ্নের কারণে যুক্তির ত্রুটি;
- শুধু চূড়ান্ত উত্তর নয়, প্রক্রিয়ার নির্ভরযোগ্যতাও বজায় থাকে কি না।
স্থিতিস্থাপকতার মানদণ্ড: যুক্তির ধারায় প্রতিপক্ষমূলক বিঘ্ন দিয়ে সিস্টেমটি পরীক্ষা করুন। উত্তরের সঠিকতার পাশাপাশি এগুলোর বিরুদ্ধে স্থিতিস্থাপকতাও মূল্যায়নের অন্তর্ভুক্ত।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ত্রুটি খুঁজে বের করা ও সংশোধন যাচাইয়ের জন্য Cloudflare OpenAI-কে কাজে লাগিয়েছে
এই লেখায় আলোচনা করা হয়েছে, কীভাবে Daybreak দুর্বলতাগুলো শনাক্ত করতে এবং যাচাইয়ের জন্য প্যাচ প্রস্তুত করতে সাহায্য করে, আর কীভাবে ডেভেলপাররা কাজের গতি বাড়াতে ও কোডের মান উন্নত করতে Codex ব্যবহার করেন।
18 নভেম্বর 2026
যাচাইযোগ্য কাজ ও দীর্ঘ ট্র্যাজেক্টরিতে ফাইন-টিউনিং: Navalia কীভাবে সহযোগী LLM এজেন্টদের আরও শক্তিশালী করে
এই কাজটিতে একটি ফ্রেমওয়ার্ক বর্ণনা করা হয়েছে, যা কর্পোরেট আর্থিক প্রতিবেদনকে ভিত্তি করে অনুসরণযোগ্য প্রমাণসহ গণনামূলক ধাপসমূহ তৈরি করে, সেগুলোকে স্বাধীনভাবে যাচাই করে এবং পরে SFT ও RL-এর জন্য প্রয়োগ করে। Qwen3.6-35B-A3B-কে ভিত্তি করে এই পাইপলাইনটি পাঁচটি বেঞ্চমার্কে উন্নতি এনেছে এবং লেখকদের তথ্য অনুযায়ী, প্রমাণ সংযুক্ত করা, টুল ব্যবহার এবং দীর্ঘ কাজ সম্পাদনের সক্ষমতা বাড়িয়েছে—যার মধ্যে অফিসের পরিস্থিতিও রয়েছে।
18 নভেম্বর 2026
ফিজিক্যাল এআই: ধারণার সীমানা, টুলকিট এবং কঠিন দিকগুলো
৩৮৮ পৃষ্ঠার এই মনোগ্রাফে ফিজিক্যাল AI-এর সংজ্ঞা, সংশ্লিষ্ট ক্ষেত্রগুলো থেকে এর পার্থক্য এবং প্রধান পদ্ধতিগুলো—উপলব্ধি ও সিমুলেশন থেকে শুরু করে নিয়ন্ত্রণ ও সমন্বিত বহু-এজেন্ট সিস্টেম পর্যন্ত—একটি অভিন্ন কাঠামোয় তুলে ধরা হয়েছে। এটি থেকে গবেষণার বিষয়গুলোর একটি মানচিত্র এবং বিশেষায়িত সমাধান থেকে ব্যাপকভাবে সাধারণীকরণযোগ্য সিস্টেমে উত্তরণের পথে বাধা হয়ে থাকা সীমাবদ্ধতাগুলো পাওয়া যায়।
17 নভেম্বর 2026