
সংক্ষেপে: আসলে কী নিয়ে কথা
২০২৬ সালের আগস্টে arXiv-তে প্রায় নিত্যদিনের মতো একটি শিরোনামের কাজ প্রকাশিত হয় — «Software Defined Dataflow System for Large-scale AI Acceleration»। এর পেছনে রয়েছে Maia 200 অ্যাক্সিলারেটরের বর্ণনা, এবং এটি "প্রতি ওয়াটে আরও বেশি ফ্লপস"-এর আরেকটি পুনরাবৃত্তি নয়। এখানে মূল ধারণাটি স্থাপত্য-সংক্রান্ত: লেখকেরা আইআই-চিপ আসলে কীভাবে গঠিত, তা নিয়ে গুরুত্বের কেন্দ্রবিন্দু বদলে দেওয়ার প্রস্তাব দিয়েছেন।
উপাদানটি ২০২৬ সালের ২৫ আগস্ট cs.AR বিভাগে জমা দেওয়া হয়েছে, প্রেরক — টরস্টেন হেফলার, লেখকতালিকায় মোট ১৭ জন (শেরি সু এবং আরও ষোলোজন গবেষক)। কাজটি একসঙ্গে কয়েকটি বিভাগে চিহ্নিত: হার্ডওয়্যার স্থাপত্য, কৃত্রিম বুদ্ধিমত্তা, বিতরণকৃত ও সমান্তরাল কম্পিউটিং, নতুন প্রযুক্তি এবং মেশিন লার্নিং। অর্থাৎ এটি কোনো "হার্ডওয়্যার"-সংক্রান্ত টীকা নয়, বরং এমন একটি ধারণার প্রস্তাব, যা পুরো স্ট্যাককে স্পর্শ করে।
কমান্ডের বদলে ডেটা: মোড় ঘোরার মূল কথা
ক্লাসিক অ্যাক্সিলারেটর কমান্ডের প্রবাহকে ঘিরে গঠিত। আছে কোর, আছে শিডিউলার, আছে ক্যাশের স্তরবিন্যাস — এবং এই পুরো কাঠামো নির্দেশাবলি সম্পাদনের সেবা করে। এই মডেলে মেমোরি সেবকদের ভূমিকা পালন করে: সময়মতো ডেটা জোগাও, বাকিটা আমরা দেখছি।
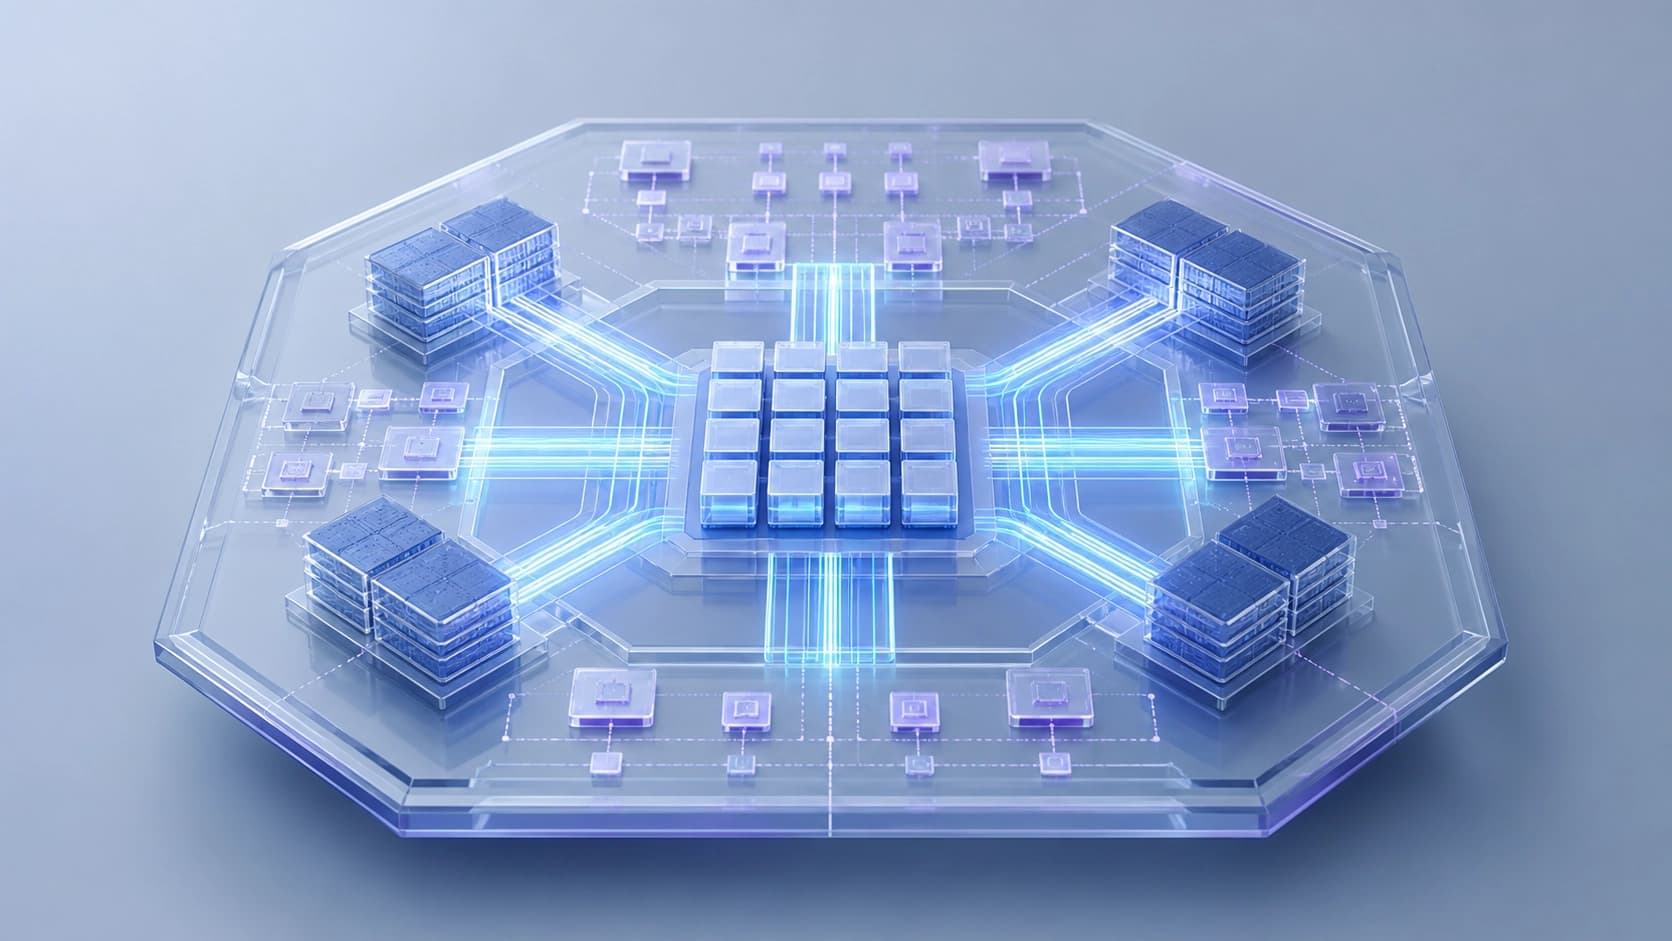
Maia 200-এ যুক্তিটা উল্টে যায়। লেখকেরা চিপটিকে একটি নতুন শ্রেণিতে ফেলেন — Software Defined Locally Accessed Dataflow Architectures, সংক্ষেপে SDLA। এখানে মূল শব্দটি «software defined»: dataflow-ইঞ্জিনগুলো কেবল সিলিকনে বিদ্যমান থাকে না, সেগুলোকে স্পষ্টভাবে প্রোগ্রাম করা হয়। প্রোগ্রামার বর্ণনা করেন, বিশেষায়িত মেমোরি ব্লক ও ডেটা স্থানান্তরের ইঞ্জিনগুলোকে ঠিক কীভাবে সুরক্ষিতভাবে পরিচালনা করতে হবে। নিয়ন্ত্রণ স্পষ্ট হয়ে ওঠে, পাইপলাইনের পার্শ্বপ্রতিক্রিয়া নয়।
এখান থেকেই ফোকাসের সরে যাওয়া: thread-centric নয়, বরং data-movement-centric। "প্রতি টিকটে কত নির্দেশ" — এই প্রশ্নটি জায়গা ছেড়ে দেয় "কত দ্রুত এবং ক্ষতি ছাড়া ডেটা সেখানে পৌঁছায়, যেখানে তা গণনা করা হবে" — এই প্রশ্নকে। আধুনিক ওয়ার্কলোডের জন্য এ দুটি মৌলিকভাবে ভিন্ন সমস্যাপ্রণয়ন।
সংখ্যাগুলো
সারসংক্ষেপ থেকে শুকনো বৈশিষ্ট্যগুলো এরকম দেখায়:
- 10 145 Tflop/s FP4 ফরম্যাটে;
- 5072 Tflop/s FP8-এ;
- মেমোরি ব্যান্ডউইথ HBM — 7 TB/s;
- থার্মাল প্যাকেজ — 750 W।
এই সংখ্যাগুলো কী বোঝায় — আর কী বোঝায় না
FP4-এ 10 145 Tflop/s-কে চেনা কিছুর সঙ্গে সঙ্গে তুলনা করার প্রলোভন প্রবল, কিন্তু সঠিকভাবে তুলনা করার মতো কিছু নেই: লেখকেরা নির্দিষ্ট মডেলে পরিমাপ প্রকাশ করেননি, আর ভিন্ন নির্ভুলতার ফরম্যাট ও ভিন্ন পরিমাপ-পদ্ধতি অসঙ্গত সংখ্যা দেয়। আলাদাভাবে মনে রাখা দরকার, খুব কম নির্ভুলতা (FP4) সবসময় মানের সঙ্গে আপস, এবং সংখ্যায় লাভ মানে কার্যকর কাজে লাভ নয়।
এখানে আরও আকর্ষণীয় হলো 7 TB/s। ঠিক এই বৈশিষ্ট্যটিই নিবন্ধের মূল ধারণার সঙ্গে মিলে যায়: যদি স্থাপত্য ডেটা স্থানান্তরকে ঘিরে গঠিত হয়, তবে মেমোরি ব্যান্ডউইথ গৌণ প্যারামিটার নয়, বরং ভারবাহী কাঠামো। আর 750 W — মনে করিয়ে দেয়, আলোচনা র্যাক নিয়ে, ডেস্কটপ কার্ড নিয়ে নয়।
SDLA এবং নতুন শ্রেণিবিন্যাস
এই ধরনের চিপ প্রচলিত চিপ থেকে কীভাবে আলাদা, তা ব্যাখ্যা করতে লেখকেরা ডেটা নিয়ন্ত্রণের একটি শ্রেণিবিন্যাস গড়ে তোলেন। এর দিশা হলো পুরনো ফ্লিন শ্রেণিবিন্যাস, যা মেশিনকে কমান্ড ও ডেটা প্রবাহের সংখ্যা অনুযায়ী ভাগ করত। সেটি ছিল সেই যুগের সুবিধাজনক ভাষা, যখন সংকীর্ণ স্থান ছিল সম্পাদনে।
এখন, লেখকদের মতে, অন্য ভাষা দরকার — সিস্টেম কীভাবে ডেটা পরিচালনা করে, তা নিয়ে। শ্রেণিবিন্যাসটি "কত" নিয়ে নয়, বরং "কীভাবে সংগঠিত" নিয়ে। আর এই কাঠামোয় SDLA আলাদা ঘর দখল করে: এমন স্থাপত্য, যেখানে মেমোরি ও ডেটা স্থানান্তর প্রথম শ্রেণির নাগরিক, পটভূমি নয়।
এই ধরনের শ্রেণিবিন্যাসের ব্যবহারিক অর্থ স্কিমের প্রতি ভালোবাসা নয়। এটি ইঞ্জিনিয়ারদের একটি শব্দভান্ডার দেয়: নির্দিষ্ট হার্ডওয়্যার কোন শ্রেণির এবং কোন কাজের জন্য উপযুক্ত, তা নিয়ে অর্থপূর্ণভাবে বিতর্ক করা যায়, সবকিছুকে একটি সংখ্যায় মাপার বদলে।
ইনফারেন্সের জন্য এটি কেন গুরুত্বপূর্ণ
ইনফারেন্স মূলত এটাই — চিপের মধ্য দিয়ে বিশাল পরিমাণ ওজন ও অ্যাক্টিভেশন ন্যূনতম বিলম্বে প্রবাহিত করা। মডেল যত বড়, তত বেশি সবকিছু আটকে যায় মেমোরি ও ব্লকগুলোর মধ্যে সংযোগে, পাটিগণিত নয়। এখানে দক্ষতা নির্ধারিত হয় সিস্টেম কত ভালোভাবে ডেটা সরাতে পারে তা দিয়ে।
লেখকেরা দাবি করেন, Maia 200 খরচ ও শক্তিতে লক্ষণীয় সাশ্রয় দেয়, ঠিক ইনফারেন্স ওয়ার্কলোডে ব্যাপক সমান্তরালতা সমর্থন করে। যদি এটি বাস্তব কাজে প্রমাণিত হয়, কেবল সিন্থেটিকে নয়, তবে বিষয়টি অন্য ভারসাম্যের: "দ্রুততম চিপ" নয়, বরং "এমন চিপ, যা একই পরিমাণ অনুরোধে সস্তায় চালানো যায়"। ডেটা সেন্টারের জন্য, যেখানে হিসাব মেগাওয়াটে, এটি ঠিক সেই যুক্তি, যা প্রাধান্য পায়।
যা পর্দার আড়ালে রয়ে গেছে
সতর্কতা কিছু শর্ত আরোপ করে। কাজটি একটি প্রিপ্রিন্ট: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, PDF, পরীক্ষামূলক HTML সংস্করণ ও TeX সোর্স উপলব্ধ। পিয়ার-রিভিউ, স্বাধীন পরিমাপ এবং ফলাফলের পুনরুৎপাদন — সামনে। শক্তি ও অর্থ সাশ্রয়ের প্রতিশ্রুতি লেখকদের বক্তব্য হিসেবে পড়া উচিত, তৃতীয় পক্ষের পরিমাপিত সত্য হিসেবে নয়।
দ্বিতীয় প্রশ্ন — রূপান্তরের মূল্য। প্রোগ্রামযোগ্য dataflow ভিন্ন চিন্তা দাবি করে: ডেভেলপারকে স্পষ্টভাবে ডেটার পথ বর্ণনা করতে হবে, আর কম্পাইলার ও ফ্রেমওয়ার্ককে তা ব্যবহার করতে শিখতে হবে। যতক্ষণ বাস্তুতন্ত্র না ধরবে, হার্ডওয়্যারের সুবিধা সবার কাছে এবং সঙ্গে সঙ্গে দৃশ্যমান হবে না। যেকোনো স্থাপত্য-সংক্রান্ত মোড় ঘোরার ক্ষেত্রেই এমন হয়েছে: প্রথমে ধারণা, তারপর সরঞ্জাম, তারপর ব্যাপক গ্রহণ।
তবু এই গল্পে মূল বিষয়টি নির্দিষ্ট টেরাফ্লপস নয়। আরও গুরুত্বপূর্ণ হলো প্রণয়নটি নিজেই: আইআই-গণনার সংকীর্ণ স্থান সরে গেছে সেখানে, যেখানে ডেটা ভ্রমণ করে, সেখানে নয়, যেখানে কমান্ড সম্পাদিত হয়। যদি এই ধারণা সঠিক হয়, পরবর্তী প্রজন্মের চিপগুলো ভিন্নভাবে নকশা করা হবে — এবং সম্ভবত এই কাজ থেকেই শুরু হবে নতুন গণনা।


