
LSem2Vec-এর নতুন পদ্ধতি: কীভাবে দুটি ধাপে এবং ব্যয়বহুল প্রশিক্ষণ ছাড়াই কোড ভেক্টর পাবেন
গবেষকরা সোর্স কোড এমবেড করার একটি সহজ পদ্ধতি প্রস্তাব করেছেন, যা বড় ভাষার মডেল এবং টেক্সট এমবেডিং মডেলকে একত্রিত করে। LSem2Vec পদ্ধতিতে কাজের জন্য ফাইন-টিউনিংয়ের প্রয়োজন হয় না এবং পরীক্ষার ফলাফল অনুযায়ী, এটি পাঁচটি আধুনিক আনসুপারভাইজড পদ্ধতিকে ছাড়িয়ে যায়।
কোড এমবেডিং কী
সোর্স কোডের ভেক্টর উপস্থাপনা অনেক ব্যবহারিক কাজের জন্য প্রয়োজন: একই রকম টুকরো খোঁজা থেকে শুরু করে ফাংশনগুলিকে অর্থ অনুসারে স্বয়ংক্রিয়ভাবে গ্রুপ করা পর্যন্ত। প্রোগ্রামটি সংখ্যার একটি সেটে রূপান্তরিত হয়, যার সাথে মেশিন লার্নিং অ্যালগরিদম কাজ করতে পারে। ভেক্টরের গুণমান নির্ভর করে মডেলটি কোডের সেমান্টিক্স কতটা ভালোভাবে বোঝে, শুধু তার সিনট্যাক্স নয়।
জটিলতা কোথায়
ক্লাসিক্যাল পদ্ধতিগুলো সাধারণত প্রতিটি কাজের জন্য আলাদা প্রশিক্ষণের প্রয়োজন হয়, অথবা অন্তত ডোমেইন ডেটাতে ফাইন-টিউনিং। এটি ব্যয়বহুল এবং সবসময় ন্যায্য নয়। বড় ভাষা মডেলের (LLM) উপর ভিত্তি করে পদ্ধতিগুলো বেশি সার্বজনীন দেখায়, কিন্তু তাদেরও একটি ত্রুটি আছে: মডেলের উত্তরে প্রায়ই অপ্রয়োজনীয় বা ভুল তথ্য থাকে এবং এই 'আবর্জনা' ভেক্টরে ঢুকে পড়ে।
LSem2Vec-এর ধারণা
গবেষণাপত্রের লেখকরা একটি দ্বি-পর্যায়ের পদ্ধতির প্রস্তাব করেছেন যার নাম LSem2Vec — LLM-extracted code Semantics to Vector embedding। আরেকটি ভারী মডেল প্রশিক্ষণের চেষ্টা করার পরিবর্তে তারা ইতিমধ্যে তৈরি উপাদানগুলোকে যুক্ত করেছেন: LLM কোড থেকে তার অর্থ বের করে, এবং সেন্টেন্স এমবেডিং মডেল সেই বর্ণনাকে ভেক্টরে রূপান্তরিত করে। নির্দিষ্ট কাজের জন্য ফাইন-টিউনিংয়ের প্রয়োজন নেই।
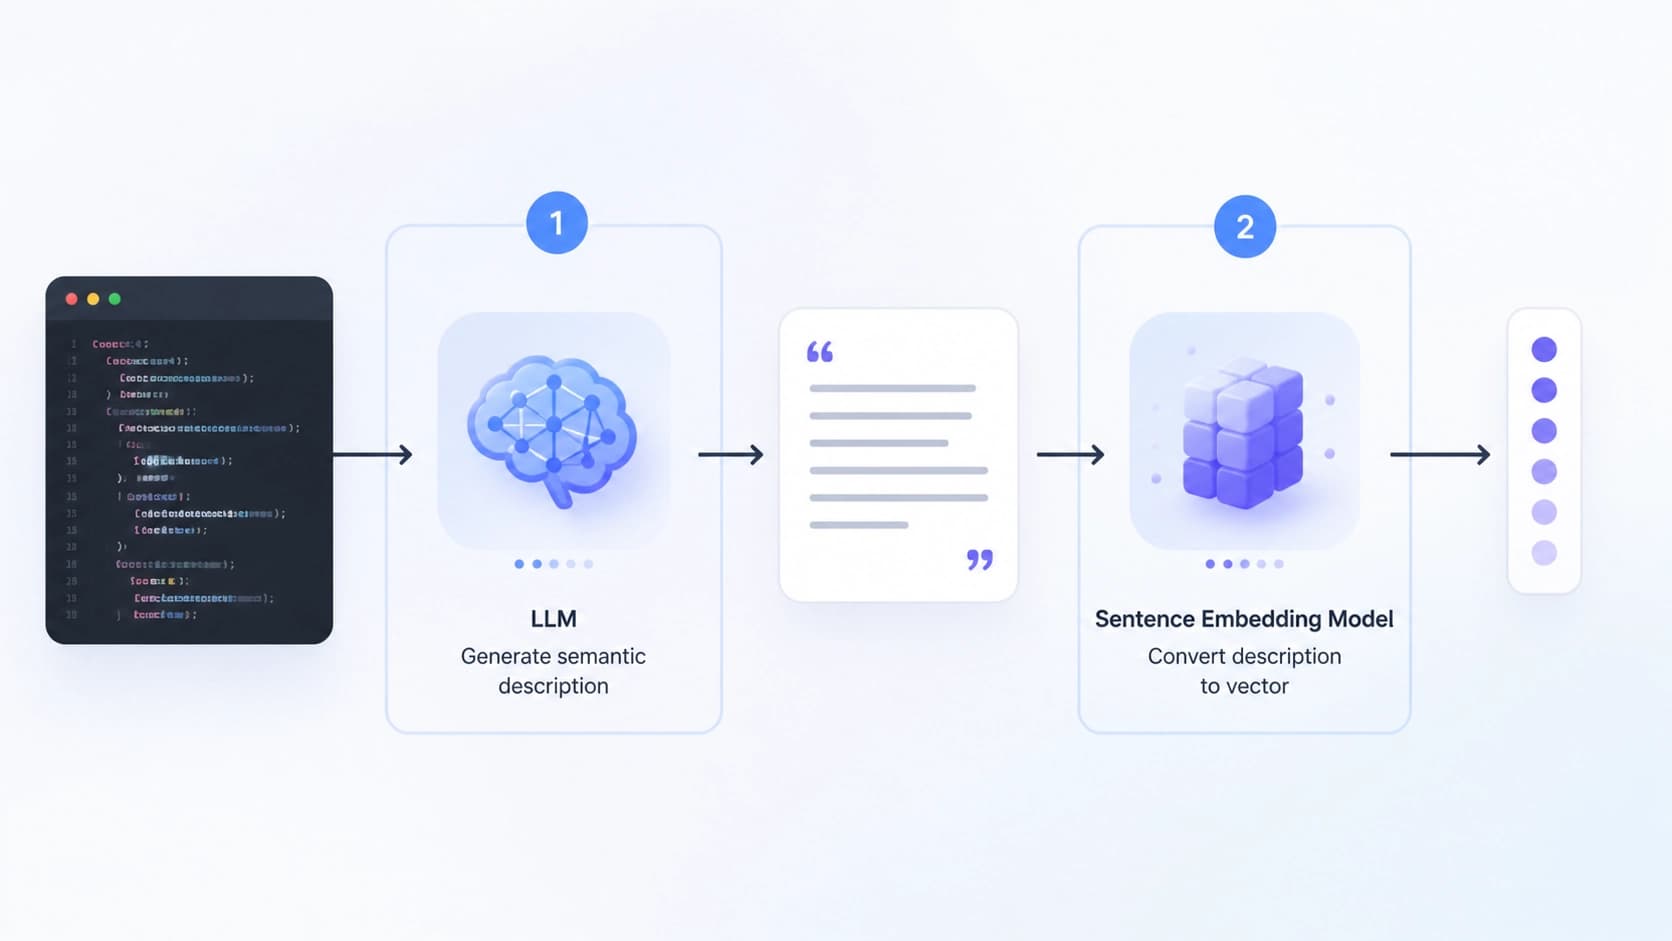
আসুন প্রক্রিয়াটি ধাপে ধাপে বুঝি। প্রথম পর্যায়ে, LLM কোড পায় এবং বলতে হয় যে এটি আসলে কী করে। এটি সোর্স কোডের যান্ত্রিক পুনরুক্তি নয়, বরং মূল অংশ বের করা: মডেলটি গৌণ বিবরণ বাদ দেয়, যাতে বর্ণনায় শুধুমাত্র অর্থের জন্য গুরুত্বপূর্ণ বিষয়গুলো থাকে। একই সাথে, এই পদ্ধতি বড় মডেলগুলির সম্ভাব্য 'কল্পনাও' কেটে দেয় — ভুল তথ্য, যা সাধারণত কোড সরাসরি এনকোড করার চেষ্টা করলে দেখা যায়।
দ্বিতীয় পর্যায়টি মেশিন লার্নিংয়ের মানদণ্ডে তুচ্ছ: LLM থেকে প্রাপ্ত বর্ণনাটি সেন্টেন্স এমবেডিং মডেলে দেওয়া হয়। এই ধরনের মডেল ইতিমধ্যে প্রাকৃতিক ভাষাকে অর্থপূর্ণ ভেক্টরে রূপান্তর করতে প্রশিক্ষিত, তাই প্রোগ্রামিং ভাষার সিনট্যাক্সের সাথে মানিয়ে নেওয়ার প্রয়োজন নেই।
কেন এটি কাজ করে
LSem2Vec-এর শক্তি দায়িত্বের স্পষ্ট বিভাজনে। একটি মডেল লজিক বোঝার জন্য দায়ী, অন্যটি টেক্সটকে ভেক্টরে রূপান্তরের জন্য। প্রতিটি নিজ নিজ কাজ সর্বোত্তমভাবে সমাধান করে, এবং একসাথে তারা একটি ভেক্টর দেয় যা কোডের আনুষ্ঠানিক বৈশিষ্ট্যের উপর নয়, সেমান্টিক্সের উপর ভিত্তি করে। প্রশিক্ষণ পর্যায়ের অনুপস্থিতি পদ্ধতিটিকে সস্তা এবং পুনরুত্পাদন করা সহজ করে তোলে।
কীভাবে পরীক্ষা করা হয়েছিল এবং কী ফলাফল পাওয়া গেছে
পরীক্ষাগুলি বিভিন্ন প্রোগ্রামিং ভাষায় তৈরি তিনটি ডেটাসেটে পরিচালিত হয়েছিল। লেখকরা উদ্দেশ্যমূলকভাবে LLM এবং এমবেডিং মডেল উভয়ই পরিবর্তন করেছেন যাতে নিশ্চিত হন: ফলাফল নির্দিষ্ট টুলের জোড়ার উপর নির্ভর করে না।
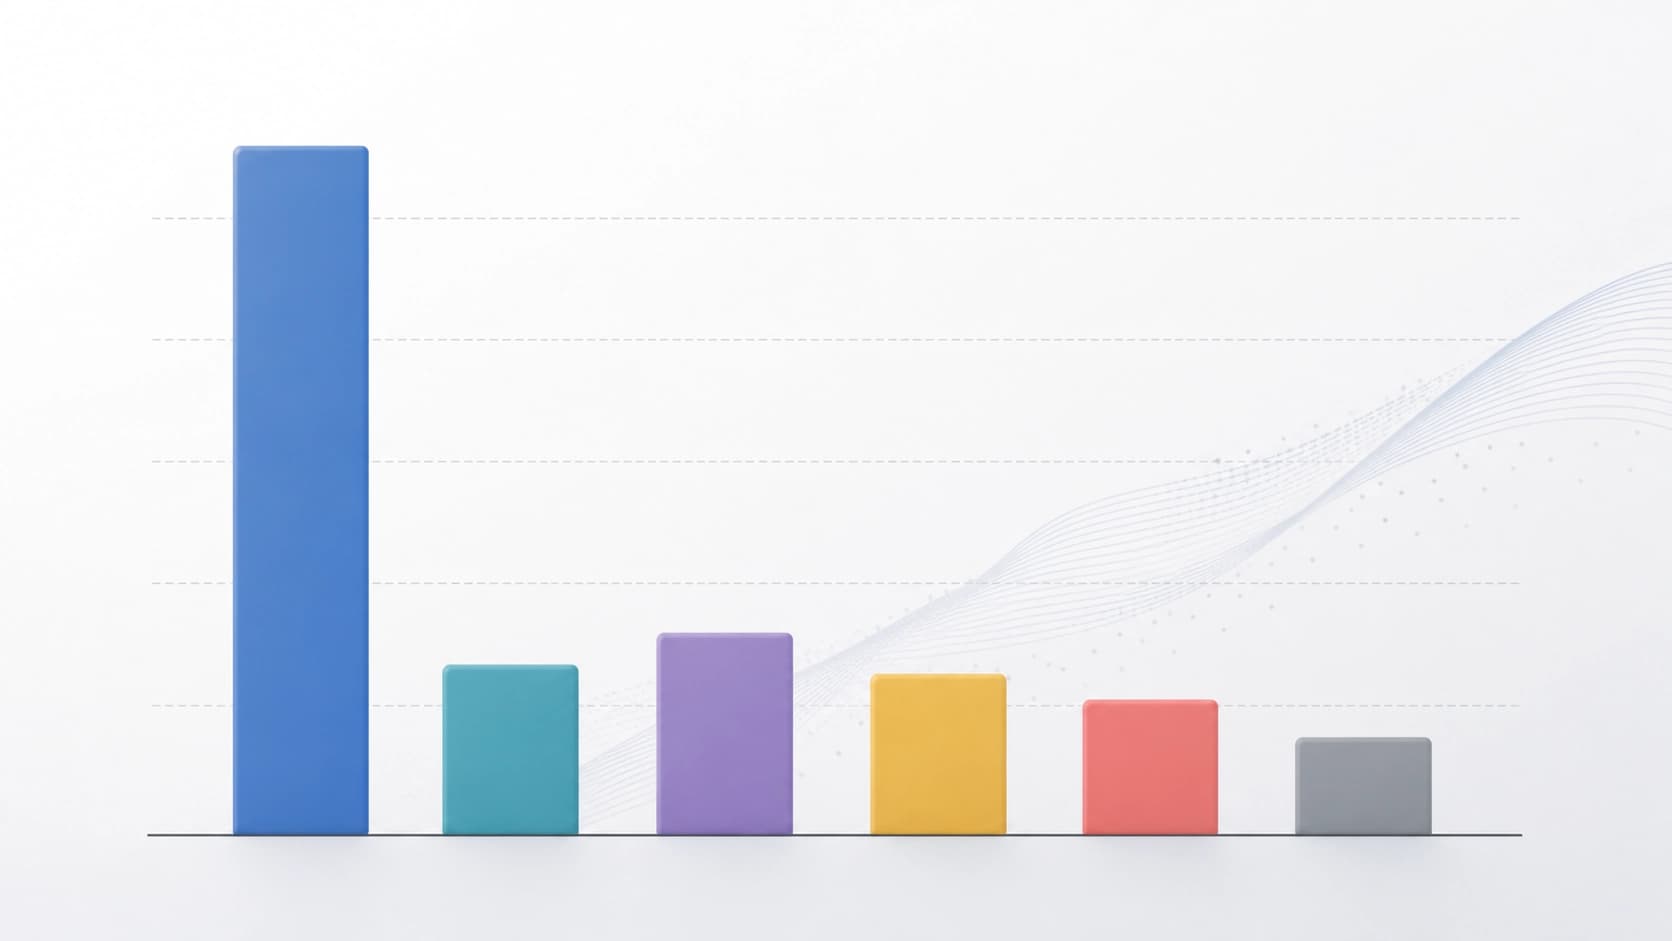
সব কনফিগারেশনে, LSem2Vec পাঁচটি আধুনিক আনসুপারভাইজড পদ্ধতির চেয়ে ভালো ফলাফল দেখিয়েছে, যেগুলো সাধারণত নির্দিষ্ট অবস্থার জন্য তৈরি এবং টিউনিং প্রয়োজন।
কাজের অবস্থা
নিবন্ধটি সেপ্টেম্বর ২০২৪-এ arXiv-এ প্রকাশিত হয়েছিল, সর্বশেষ উপলব্ধ সংস্করণটি আগস্ট ২০২৬-এর v5। লেখকদের মতে, কাজটি Frontiers of Computer Science জার্নাল দ্বারা গৃহীত হয়েছে। অর্থাৎ, পদ্ধতিটির এখন শুধু প্রিপ্রিন্ট পেজ নয়, একটি পিয়ার-রিভিউড প্রকাশনাও আছে। মূলটি DOI: 10.1007/s11704-026-61288-0-তে পাওয়া যাবে।
উপসংহার
LSem2Vec-এর মূল শিক্ষা হল যে জটিল সমস্যাগুলোর জন্য সবসময় জটিল সমাধানের প্রয়োজন হয় না। অর্থ বের করার জন্য LLM এবং ভেক্টর তৈরি করার জন্য সেন্টেন্স এমবেডিং মডেল ক্রমানুসারে প্রয়োগ করাই যথেষ্ট। এটি দ্রুত, বিশেষ ফাইন-টিউনিং ছাড়াই এবং প্রতিযোগিতামূলক ফলাফল দেয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
প্রার্থী যাচাই করতে সেগুলো তৈরি করার চেয়ে বেশি খরচ হয়: LLM-এর দুর্বলতা অনুসন্ধানের বিরুদ্ধে ডিকয়গুলি
এই কাজে এজেন্টভিত্তিক ত্রুটি অনুসন্ধানের ব্যয়ের অসমতা বিশ্লেষণ করা হয়েছে: সংস্করণ তৈরি করা সস্তা, কিন্তু পৌঁছনযোগ্যতা বিশ্লেষণ, কার্যকরকরণ এবং PoC-এর মাধ্যমে সেগুলো নিশ্চিত করতে মূল বাজেটের প্রয়োজন হয়। তাই যাচাইকরণকে প্রতিরক্ষার স্বতন্ত্র লক্ষ্য করা যেতে পারে। প্রস্তাবিত RedHerring—রিপোজিটরি অনুযায়ী মানিয়ে নেওয়া, সিল করা সার্টিফিকেটসহ প্রলোভন—সমান ব্যয়ে OSS-Fuzz-এর ৩৩টি প্রকল্পে শনাক্ত হওয়া প্রকৃত দুর্বলতার সংখ্যা ৩৮.৭–৬০.৪% কমিয়েছে; এজেন্টকে সতর্ক করার পরও এই হ্রাস ৩৭.২% ছিল।
9 নভেম্বর 2026
ফাইন-টিউনিং ছাড়াই উৎসের SQL উপস্থাপনার মাধ্যমে LLM-এর হ্যালুসিনেশন যাচাই করা
এই গবেষণায় যাচাই করা হয়েছে, হ্যালুসিনেশন শনাক্তকরণে তত্ত্বাবধান ছাড়াই উৎসের সঙ্গে সংযোগ স্থাপনের জন্য LLM কি একটি মৌলিক প্রতীকী দক্ষতা—উৎস নথি থেকে SQL ডেটাবেস তৈরি—ব্যবহার করতে পারে। RAGTruth ও DiaHalu-তে এই নিউরো-সিম্বলিক পাইপলাইনটি সরাসরি পূর্বাভাসের চেয়ে বেশি নির্ভুল এবং অত্যাধুনিক পদ্ধতিগুলোর সঙ্গে তুলনীয়, অথচ বিষয়ভিত্তিক সূক্ষ্ম-টিউনিংয়ের প্রয়োজন হয় না।
9 নভেম্বর 2026
MathAdv: মেশিন-উৎপন্ন প্রমাণের চূড়ান্ত নির্ভুলতার আড়ালে কী লুকিয়ে আছে
গণিতের ১৩টি বিশ্ববিদ্যালয় ও স্নাতকোত্তর শাখার কাজ নিয়ে তৈরি এই ডায়াগনস্টিক সেটটি Lean 4-এ মেশিন প্রুফ সিস্টেমকে শুধু চূড়ান্ত ফলাফলের ভিত্তিতে নয়, বিষয়জ্ঞান, অনানুষ্ঠানিক যুক্তির গুণমান এবং শর্তাবলি নতুনভাবে উপস্থাপন করা হলে তা সামাল দেওয়ার সক্ষমতার ভিত্তিতেও মূল্যায়ন করে। উপাদানভিত্তিক বিশ্লেষণে দেখা যায়, কোনো সমস্যাকে আনুষ্ঠানিক রূপে রূপান্তর করা এখনও প্রধান বাধা; আর সাফল্য গণিতের শাখা ও সমস্যা উপস্থাপনের পদ্ধতির ওপর অনেকটাই নির্ভর করে।
9 নভেম্বর 2026