
ইনপুটে বৈচিত্র্য, যুক্তিতে নয়: LLM-এর জন্য টেস্ট-টাইম অগমেন্টেশন পদ্ধতির তুলনা
এই গবেষণায় সমান সংখ্যক কলের ভিত্তিতে LLM ইনফারেন্সে বৈচিত্র্যের উৎস—প্রম্পটের পুনর্বাক্যায়ন, বানানের পরিবর্তন এবং ছবির রূপান্তর—তুলনা করা হয়েছে। ছয়টি বেঞ্চমার্কে অর্থ অক্ষুণ্ণ রাখলে নির্ভুলতার উন্নতি সবচেয়ে বেশি হয়েছে, অন্যদিকে অক্ষর-স্তরের নয়েজ এবং একই সঙ্গে দুই মোডালিটিতে পরিবর্তন তুলনামূলকভাবে কম কার্যকর ছিল।
বৈচিত্র্যের দুটি উৎস: ইনপুট ও যুক্তি
Test-Time Augmentation (TTA) ইনপুট ডেটার রূপান্তরিত সংস্করণগুলোর পূর্বাভাস একত্র করে। প্রশ্নের পুনর্বাক্যায়ন, বানান পরিবর্তন বা সহায়ক ছবির রূপান্তরের মাধ্যমে বৈচিত্র্য তৈরি হয়। Self-consistency ভিন্নভাবে কাজ করে: এটি শুধু যুক্তির পথ পরিবর্তন করে এবং অপরিবর্তিত ইনপুট পুনরায় ব্যবহার করে।
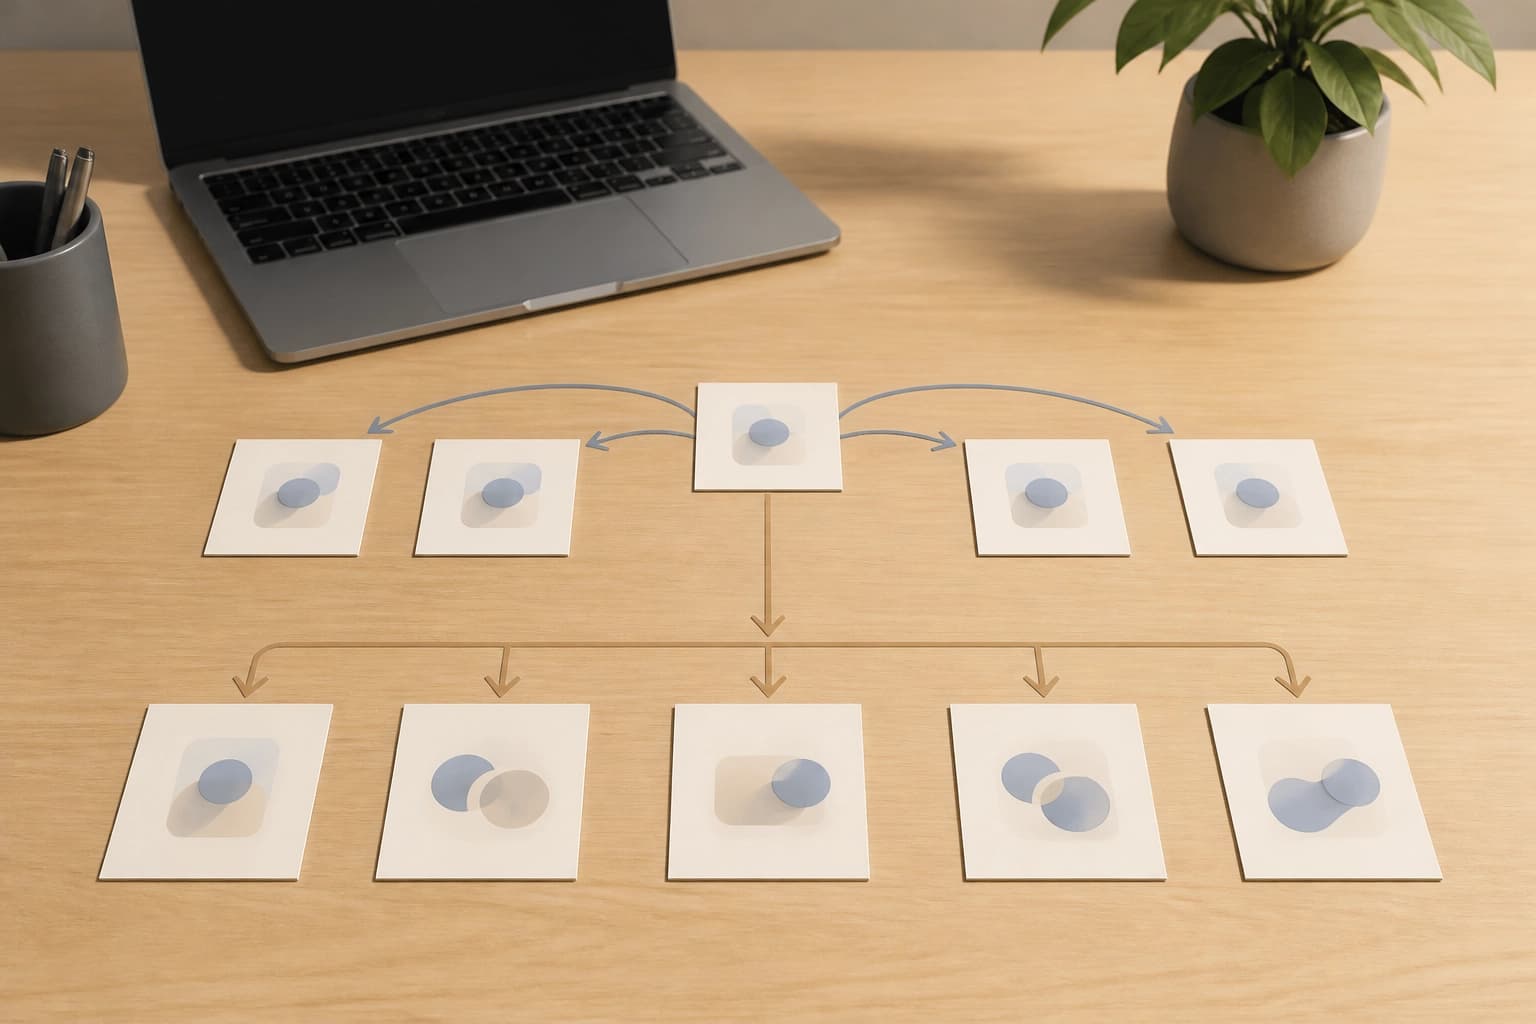
| পদ্ধতি | বৈচিত্র্যের উৎস |
|---|---|
| TTA | ইনপুট ডেটার রূপান্তরিত সংস্করণ |
| Self-consistency | অপরিবর্তিত ইনপুটে যুক্তির পথ |
TTA ইনপুটের পরিবর্তনের প্রতি স্থিতিশীলতা যাচাই করে। Self-consistency একটি ইনপুটে যুক্তির স্থিতিশীলতা যাচাই করে। কোন উৎসের বৈচিত্র্য কাজটির জন্য প্রয়োজন, তার ওপর পদ্ধতি নির্বাচন নির্ভর করে।
ইনফারেন্স কলের সংখ্যা সমান হলে কেন সিদ্ধান্ত বদলে যায়
লেখকেরা ছয়টি বেঞ্চমার্কে বিভিন্ন পদ্ধতির তুলনা করেছেন। ইনফারেন্স কলের সংখ্যা সমান ছিল। এই শর্তটি বৈচিত্র্যের উৎসের প্রভাবকে অতিরিক্ত গণনার প্রভাব থেকে আলাদা করে।
- ছয়টি বেঞ্চমার্ক;
- কলের সংখ্যা সমান;
- পরিমাণের নয়, উৎসের তুলনা।
লেখকেরা জানান: বৈচিত্র্যের উৎস তার পরিমাণের চেয়ে বেশি গুরুত্বপূর্ণ। নির্বাচনসংক্রান্ত সিদ্ধান্ত: সমান সংখ্যক কলের ভিত্তিতে পদ্ধতিগুলোর তুলনা করা উচিত। নইলে নির্ভুলতার উন্নতির কৃতিত্ব উৎসকে দেওয়া হতে পারে, অতিরিক্ত কলকে নয়।
পুনর্বাক্যায়ন: উন্নতি ও আগেভাগে শীর্ষে পৌঁছানো
অর্থ অক্ষুণ্ণ রেখে ইনপুট পুনর্বাক্যায়নে নির্ভুলতা সবচেয়ে বেশি বেড়েছে। একটি কলের তুলনায় উন্নতি হয়েছে +1.80 শতাংশ পয়েন্ট। সবচেয়ে কম সংখ্যক নমুনাতেই সর্বোচ্চ নির্ভুলতা অর্জিত হয়েছে।
Claude Haiku-এর মতো মাঝারি-স্তরের মডেলগুলোর ক্ষেত্রে, যুক্তির পথ পরিবর্তনের চেয়ে প্রশ্নের শব্দচয়ন পরিবর্তন করা ইনফারেন্স কলকে আরও কার্যকরভাবে কাজে লাগিয়েছে।
ব্যবহারিক সিদ্ধান্ত: রূপান্তরে অর্থ অক্ষুণ্ণ থাকলে, TTA-র জন্য পুনর্বাক্যায়নই প্রথম বিবেচ্য। এতে নির্ভুলতা বাড়ে এবং দ্রুতই সর্বোচ্চ পর্যায়ে পৌঁছায়।
অক্ষরভিত্তিক নয়েজ: প্রচুর অমিল, সামান্য উপকার
অক্ষরভিত্তিক নয়েজ উত্তরগুলোর মধ্যে বেশি অমিল তৈরি করেছে: 37.8% বনাম 27.4%। নির্ভুলতার উন্নতি ছিল কম। উত্তরের মধ্যে বেশি বিচ্যুতি থাকলেই যে সেগুলো একত্র করে উপকার হবে, তা নয়।
অর্থ নষ্ট করার পর যে অমিল তৈরি হয়, তা ভুল। এ ধরনের অমিল একত্রীকরণের জন্য কোনো কার্যকর সংকেত দেয় না।
ব্যবহারিক সিদ্ধান্ত: শুধু অমিলের হার নয়, নির্ভুলতাও মূল্যায়ন করুন। অক্ষরভিত্তিক নয়েজ অর্থ অক্ষুণ্ণ রাখা রূপান্তরের বিকল্প নয়।
দ্বৈত বিঘ্ন: যখন সমন্বয় খারাপ ফল দেয়
একই সঙ্গে দুটি মোডালিটিতে বিঘ্ন ঘটালে ফল একবার কলের বেসলাইন স্তরের চেয়ে নিচে নেমেছে। রূপান্তরের সমন্বয় করলেই যে উন্নতি হবে, তার নিশ্চয়তা নেই।
- একই সঙ্গে দুটি মোডালিটিতে বিঘ্ন ঘটানো;
- ফল একবার কলের বেসলাইন স্তরের চেয়ে নিচে;
- সমন্বয়টি আলাদাভাবে যাচাই করা।
ব্যবহারিক সিদ্ধান্ত: আলাদাভাবে তুলনা করার পরেই মোডালিটিগুলো একত্র করুন। নইলে TTA একবার কলের ফলের চেয়েও খারাপ হতে পারে।
পদ্ধতি নির্বাচনের ব্যবহারিক নির্দেশনা
নির্বাচনের মানদণ্ড নির্ভর করে বৈচিত্র্যের উৎস, অর্থ অক্ষুণ্ণ রাখা এবং কলের সংখ্যা সমান রাখার ওপর।
| কাজ | পদ্ধতি |
|---|---|
| শব্দচয়নের প্রতি স্থিতিশীলতা যাচাই | পুনর্বাক্যায়নসহ TTA |
| একই ইনপুটে যুক্তির স্থিতিশীলতা যাচাই | self-consistency |
| বানানের প্রতি সংবেদনশীলতা মূল্যায়ন | অক্ষরভিত্তিক নয়েজসহ TTA |
| মোডালিটি একত্র করা | শুধু আলাদাভাবে তুলনা করার পর |
ব্যবহারিক মানদণ্ড: কাজ অনুযায়ী বৈচিত্র্যের উৎস বেছে নিন। TTA থেকে নির্ভুলতা বাড়ানোর ক্ষেত্রে, পুনর্বাক্যায়নেই সবচেয়ে বেশি পরিমাপযোগ্য প্রভাব দেখা গেছে। একই ইনপুটে যুক্তি যাচাইয়ের জন্য self-consistency-ই উপযুক্ত।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
STAR: এন্ড-টু-এন্ড ইনসিডেন্ট ব্যবস্থাপনার জন্য সময়গত প্রেক্ষাপট ও সার্ভিস গ্রাফের অভিযোজিত স্বাভাবিকীকরণ
STAR ফ্রেমওয়ার্কটি মেট্রিক, লগ ও ট্রেস থেকে উপস্থাপনা শেখায়, যেখানে বহুমাত্রিক সময়গত গতিশীলতা এবং পরিষেবাগুলোর মধ্যে নির্ভরতার কাঠামো বিবেচনায় নিয়ে শেখনযোগ্য নরমালাইজেশন প্রয়োগ করা হয়। দুটি বাস্তব ডেটাসেটে, এই পদ্ধতি আধুনিক বেসলাইন পদ্ধতিগুলোর তুলনায় অ্যানোমালি শনাক্তকরণ, ব্যর্থতার অগ্রাধিকার নির্ধারণ এবং মূল কারণ অনুসন্ধানের মান ধারাবাহিকভাবে উন্নত করে।
10 নভেম্বর 2026
চের্ন–সাইমনস রিজার্ভারের স্মৃতি: সংযোগের স্বায়ত্তশাসিত গতিবিদ্যা এবং ঘনত্ব পরিবহন
এই নিবন্ধে আলোচনা করা হয়েছে, কীভাবে একটি রিজার্ভয়ার ইনপুট সিগন্যালের ইতিহাস একই সঙ্গে ঘনত্বের বণ্টন এবং জ্যামিতিক স্বাধীনতার মাত্রায় সংরক্ষণ করে। চারটি প্রক্রিয়ার তুলনা দেখায় যে কারেন্ট একটি স্বতন্ত্র সংযুক্তি উপাদান তৈরি করে, যা ঘনত্বের পরবর্তী প্রতিক্রিয়া পরিবর্তন করে; আর পরিমাপ করা সব বৈশিষ্ট্য বিবেচনায় নিলে ইমপালসের ক্রম ডিকোড করার ক্ষেত্রে সামান্য উন্নতি হয়।
10 নভেম্বর 2026
প্রার্থী যাচাই করতে সেগুলো তৈরি করার চেয়ে বেশি খরচ হয়: LLM-এর দুর্বলতা অনুসন্ধানের বিরুদ্ধে ডিকয়গুলি
এই কাজে এজেন্টভিত্তিক ত্রুটি অনুসন্ধানের ব্যয়ের অসমতা বিশ্লেষণ করা হয়েছে: সংস্করণ তৈরি করা সস্তা, কিন্তু পৌঁছনযোগ্যতা বিশ্লেষণ, কার্যকরকরণ এবং PoC-এর মাধ্যমে সেগুলো নিশ্চিত করতে মূল বাজেটের প্রয়োজন হয়। তাই যাচাইকরণকে প্রতিরক্ষার স্বতন্ত্র লক্ষ্য করা যেতে পারে। প্রস্তাবিত RedHerring—রিপোজিটরি অনুযায়ী মানিয়ে নেওয়া, সিল করা সার্টিফিকেটসহ প্রলোভন—সমান ব্যয়ে OSS-Fuzz-এর ৩৩টি প্রকল্পে শনাক্ত হওয়া প্রকৃত দুর্বলতার সংখ্যা ৩৮.৭–৬০.৪% কমিয়েছে; এজেন্টকে সতর্ক করার পরও এই হ্রাস ৩৭.২% ছিল।
9 নভেম্বর 2026