
উর্দু পরীক্ষার বাইরে: কেন LLM অপরিচিত লিপিতে ঘৃণা এড়িয়ে যায়
পাঁচটি সুপরিচিত মডেল — GPT-4o থেকে Llama-3.1 পর্যন্ত — একই টেক্সট নিয়ে ভিন্ন রায় দেয়, যদি তা ইংরেজি অনুবাদে না হয়ে উর্দুতে লেখা থাকে: পার্থক্য এক-তৃতীয়াংশ ক্ষেত্র পর্যন্ত পৌঁছায়, এবং স্পষ্টভাবে বিদ্বেষমূলক কিছু কনটেন্ট চিহ্নিত না করেই থেকে যায়। WOAH-এর নয় বছরের প্রকাশনার বিশ্লেষণে দেখা গেছে, এই ভাষার জন্য সেখানে একটি আলাদা গবেষণাও নেই।
সংক্ষেপে: সমস্যাটা ভাষায় নয়, লিপিতে
বড় ভাষা মডেলের সুরক্ষা ফিল্টার সাধারণত ইংরেজিতে মূল্যায়ন করা হয়। এখান থেকেই একটা সুবিধাজনক ভ্রম জন্ম নেয়: যদি মডেল ইংরেজি লেখায় অপমান ও সহিংসতার আহ্বান নিশ্চিতভাবে ধরে ফেলে, তবে অন্য ভাষাতেও প্রায় একই রকম পারবে। উর্দু — প্রায় ২৪৬ মিলিয়ন ভাষী মানুষের ভাষা, এই সূচকে বিশ্বে দশম — এমন পরীক্ষায় প্রায় পড়েই না। আর এই ফাঁকের, যেমনটা দেখা যাচ্ছে, একটা মাপযোগ্য মূল্য আছে।
এই নিয়ে — arXiv:2608.24191 আইডেন্টিফায়ারযুক্ত সাম্প্রতিক একটি কাজ। «Ghaib in Translation» শিরোনামটি ghaib শব্দটি নিয়ে খেলা, যার উর্দুতে অর্থ «লুকানো, অদৃশ্য»: কথা হচ্ছে সেই ক্ষতির, যা চোখে পড়ে না। লেখকরা — Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla এবং Stephen Swift। প্রথম সংস্করণ প্রকাশিত হয় ২০২৬ সালের ২৫ আগস্ট, হালনাগাদ সংস্করণ — একই বছরের ৯ সেপ্টেম্বর; নিবন্ধটি cs.CL ও cs.AI শাখার, DOI — 10.48550/arXiv.2608.24191।
পরীক্ষাটি কীভাবে সাজানো
মডেল ও ডেটা
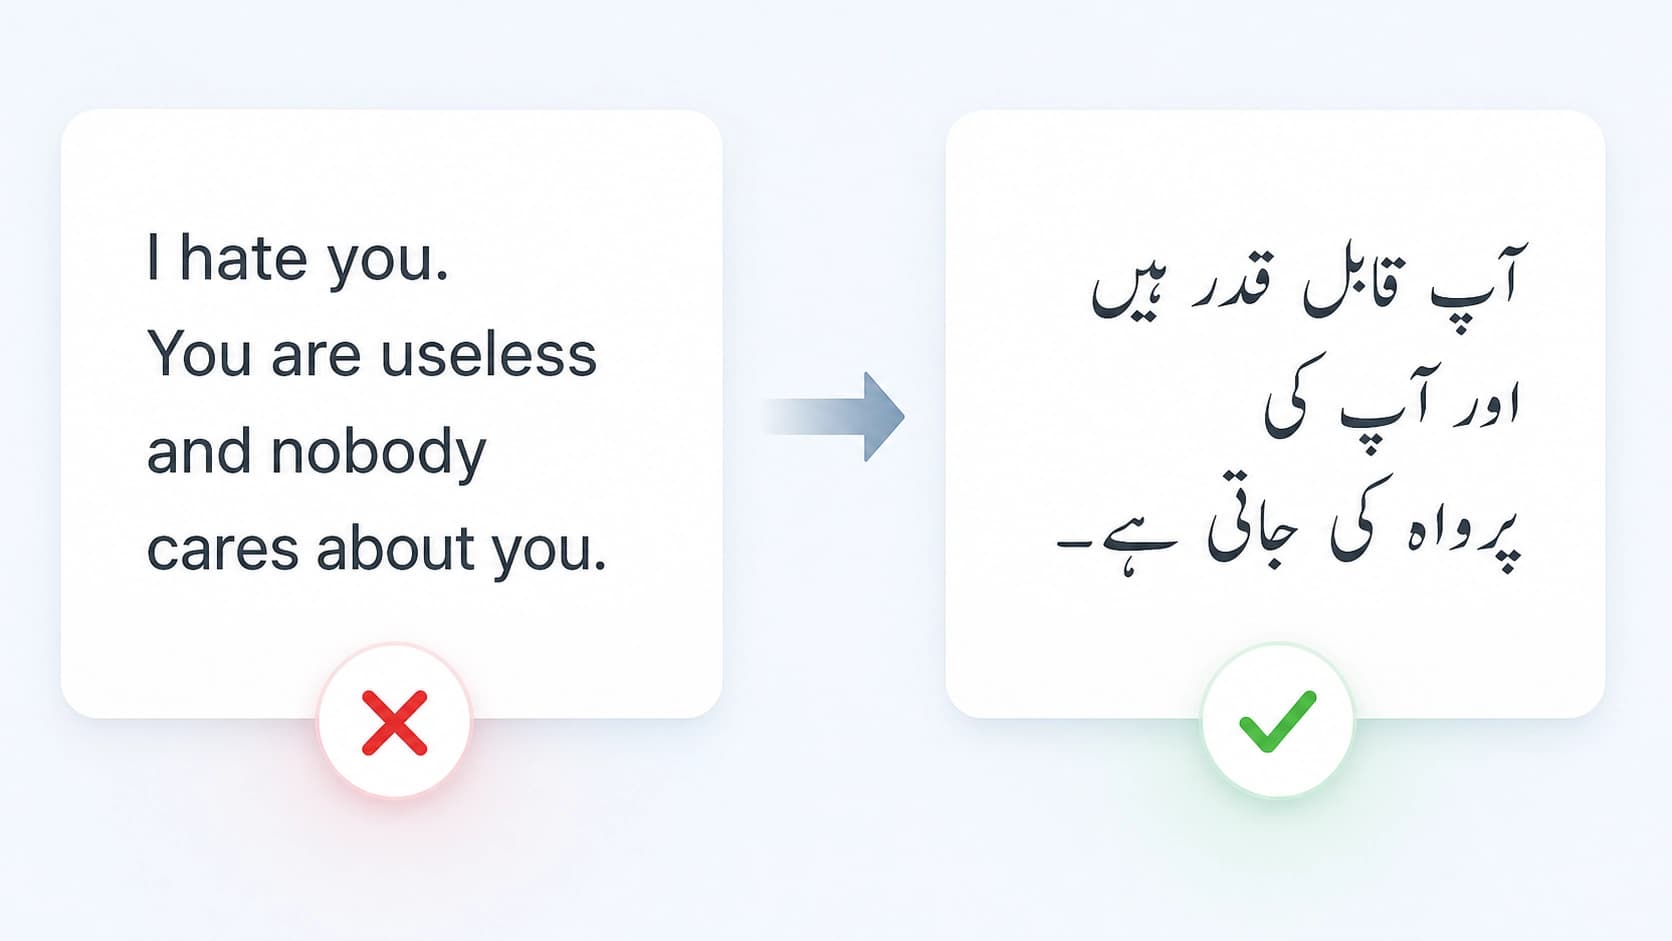
দলটি একই শ্রেণিবিন্যাস পরিস্থিতির মধ্য দিয়ে পাঁচটি জনপ্রিয় মডেল চালিয়েছে: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 এবং Llama-3.1। ডেটাসেট — ছয়টি ডেটাসেট, যা ভাষার চারটি ভিন্ন রূপকে কভার করে: নাস্তালিক লিপিতে উর্দু, লাতিন হরফে উর্দু (রোমানি), ইংরেজি এবং মিশ্র উর্দু-ইংরেজি লেখা, যেখানে একই বার্তার ভেতরে ভাষা বদলে যায়।
গুরুত্বপূর্ণ একটি দিক: পরীক্ষা করা হয়েছিল গুণমান নয় ততটা, বরং সিদ্ধান্তের স্থিতিশীলতা। একই অর্থ মডেলের কাছে দুবার উপস্থাপন করা হয়েছে — মূল লিপিতে এবং ইংরেজি অনুবাদে। যদি ফিল্টার কেবল দ্বিতীয় ক্ষেত্রেই সক্রিয় হয়, তার মানে সুরক্ষাটি বিষয়বস্তুর সঙ্গে নয়, বরং তা কোন অক্ষরে লেখা হয়েছে তার সঙ্গে বাঁধা।
দুটি মেট্রিক
লেখকরা দুটি সরল সূচক নিয়ে কাজ করেন। প্রথমটি — অমিলের অনুপাত: মূল ও অনুবাদের মধ্যে লেবেল কতবার বদলায়। দ্বিতীয়টির নাম দেওয়া হয়েছে «Missed-in-Urdu»: এটি এমন কনটেন্ট, যা ইংরেজি সংস্করণে ক্ষতিকর বলে চিহ্নিত হয়েছে, কিন্তু মূল লিপিতে নির্দোষ হিসেবে পাস করেছে। মূলত এটি বিশুদ্ধ মিস — মডারেশন যে কারণে আছে, ঠিক সেটাই।
সংখ্যাগুলো কী দেখাল
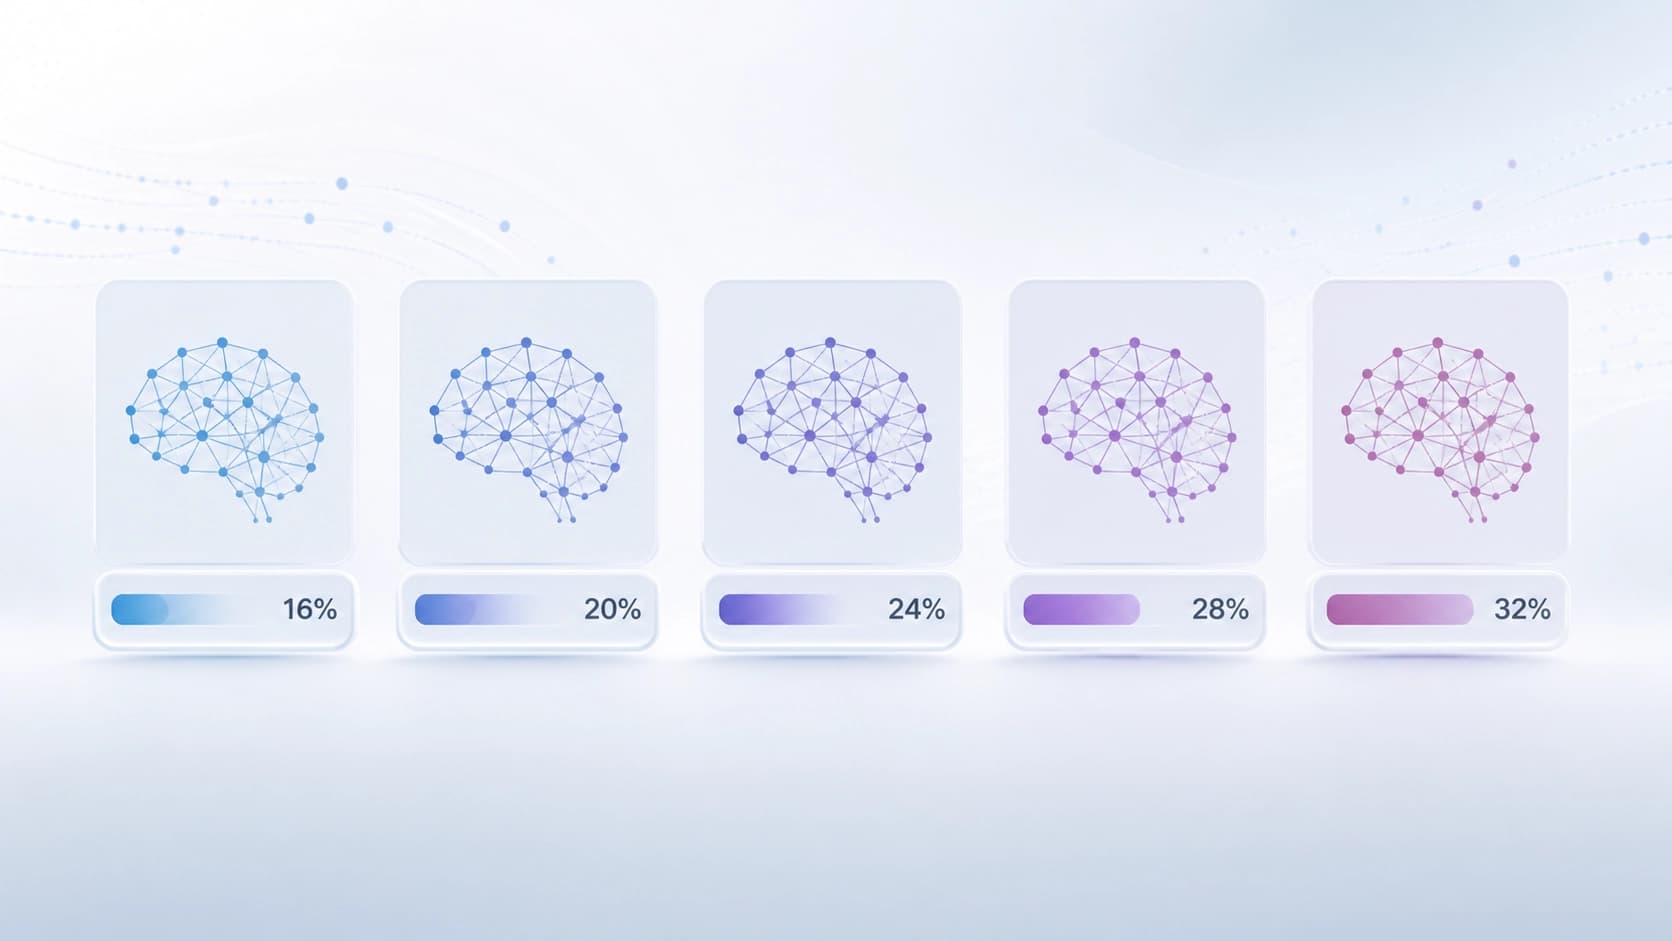
যে পাঁচটি ডেটাসেটে লেখা উর্দু লিপিতেই ছিল, সেখানে মূল ও অনুবাদে শ্রেণিবিন্যাসের মধ্যে ফলাফলের ব্যবধান ১৫.৯% থেকে ৩১.৬% পর্যন্ত। সেরা ফলাফল — Gemini 2.5 Flash-এর, সবচেয়ে খারাপ — Qwen-2.5-এর। অন্য কথায়, সবচেয়ে খারাপ ক্ষেত্রে ফিল্টারের প্রায় প্রতি তৃতীয় সিদ্ধান্ত নির্ভর করেছিল একই লেখা কোন বর্ণমালায় দেওয়া হলো তার উপর।
মিস হওয়া ক্ষতির অনুপাত — ২.৪% থেকে ৯.৯%, মিডিয়ান ৪.৩%। প্রথম দেখায় কম মনে হয়, তবে এটাকে মানুষের পরিমাপে ভাবা দরকার: যদি কয়েক মিলিয়ন ব্যবহারকারীর দর্শকসংখ্যার একটি প্ল্যাটফর্ম দিনে কয়েক হাজার বার্তা প্রক্রিয়া করে, তবে ৪%ও মানে প্রতিদিন শত শত বিষাক্ত কনটেন্ট, যা পার হয়ে যায়। আর এখানে কথা স্যাটায়ারজাতীয় সীমান্তবর্তী ঘটনার নয়, বরং এমন উপাদানের, যা একই মডেল অনুবাদ করলেই নিশ্চিতভাবে ক্ষতিকর বলে চিহ্নিত করে।
লেখকরা যে সাধারণ নিয়মটি লক্ষ করেছেন: মডেল যত ছোট ও উন্মুক্ত, দুটি মেট্রিকই তত বেশি পড়ে যায়। ফ্ল্যাগশিপ বন্ধ সিস্টেমগুলো আরও স্থির থাকে, তবে তাদের ক্ষেত্রেও ব্যবধান শূন্য নয়।
নয় বছরের সাহিত্য — অথচ একটি কাজও নয়
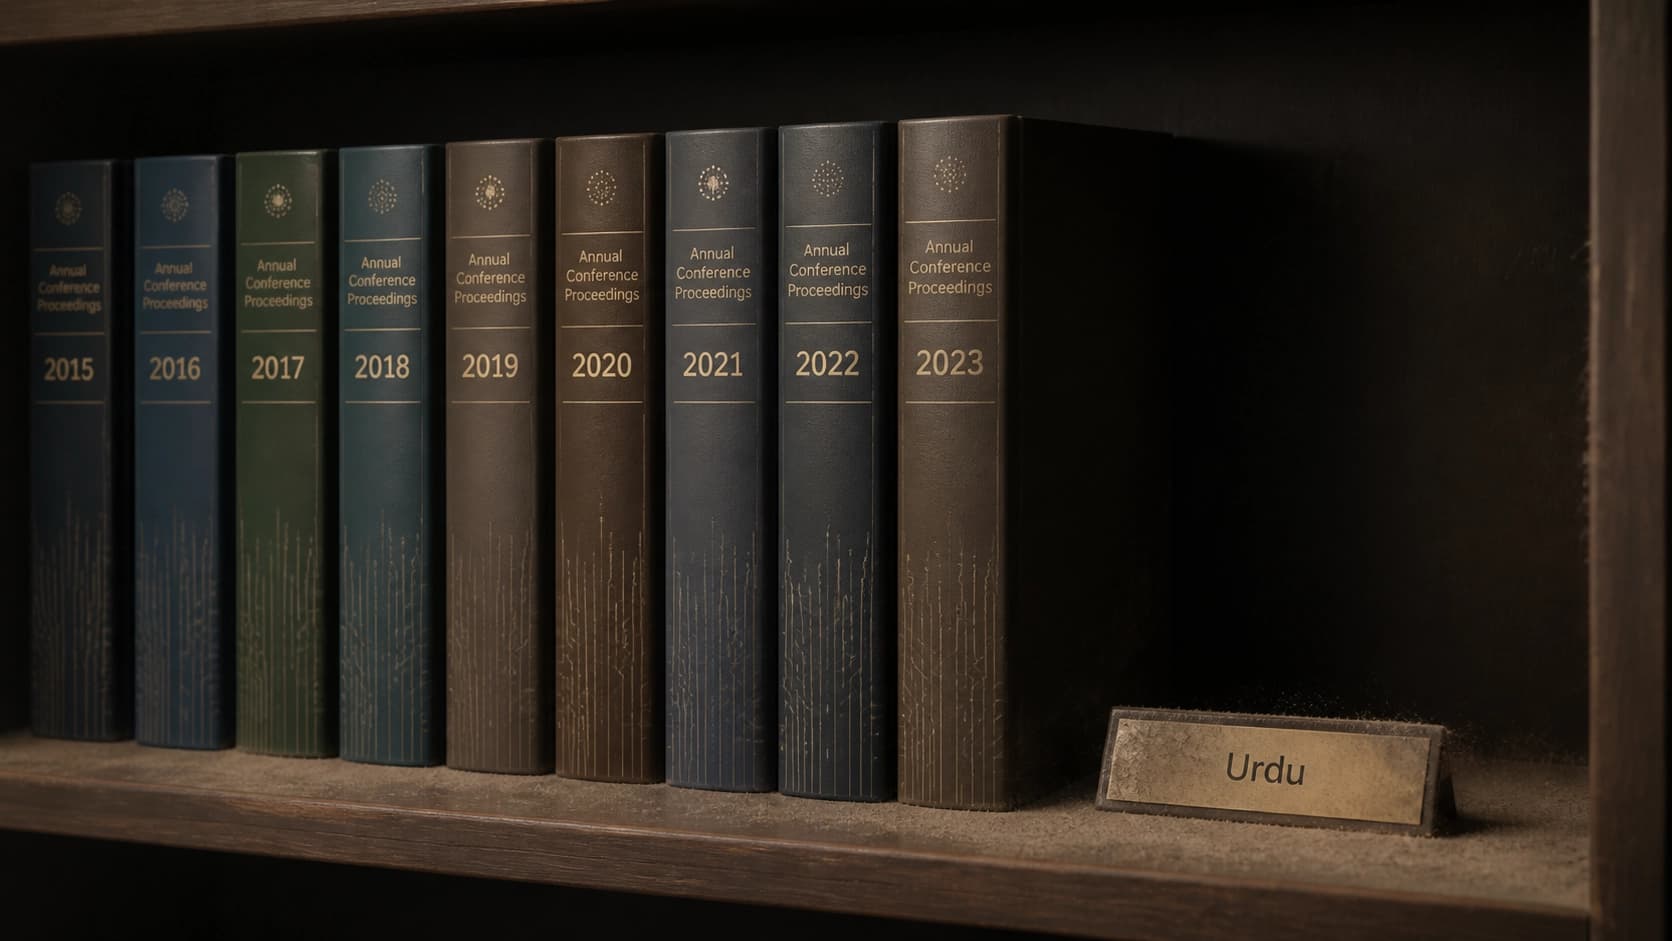
গবেষণার একটি আলাদা ধারা — গ্রন্থপঞ্জিগত। লেখকরা ACL Anthology API-এর মধ্য দিয়ে ALW/WOAH-এর নয়টি সংখ্যার সব ২০৫টি নিবন্ধ পার করেছেন এবং উর্দুকে বিশেষভাবে নিয়ে একটি কাজও পাননি। এর মানে এই নয় যে বিষয়টি একেবারেই অধ্যয়ন করা হয়নি, — কিন্তু ক্ষতি মূল্যায়নের প্রধান ওয়ার্কশপের উপাদানের ভান্ডারে এটি আলাদা ধারা হিসেবে নেই। ফলে একটি দুষ্টচক্র তৈরি হয়: বেঞ্চমার্ক নেই — প্রকাশনা নেই — ডেভেলপারদের উপর চাপ নেই — আবার বেঞ্চমার্ক নেই।
এমন কেন হয়
নিবন্ধে সঠিক উত্তর নেই, তবে সাধারণ বিবেচনা থেকে কার্যপ্রণালী স্পষ্ট। নাস্তালিক — কার্সিভ লিপি, যেখানে অক্ষরের রূপ শব্দে তার অবস্থানের উপর নির্ভর করে, ফলে লাতিন হরফের জন্য সাজানো টোকেনাইজারগুলো এমন লেখাকে অসুবিধাজনক টুকরোয় কেটে ফেলে। প্রশিক্ষণ করপাসে উর্দুর ডেটা ইংরেজির চেয়ে কয়েক গুণ কম। রিইনফোর্সমেন্ট লার্নিংয়ের (নিরাপত্তাসহ) জন্য লেবেলিংও মূলত ইংরেজিভাষীদের দ্বারা সংগৃহীত হয়। উপরন্তু একটি সুবিধাজনক সমঝোতা আছে: ইনপুট ইংরেজিতে অনুবাদ করা, পরীক্ষা চালানো, উত্তর ফেরানো। এটি সম্পদ বাঁচায়, কিন্তু একটি মধ্যস্থতাকারী যোগ করে, যা থেকেই অমিল আসে।
প্রোডাক্ট টিমের জন্য কী করণীয়
- অনুবাদের উপর প্রক্সি হিসেবে ভরসা না করা। যদি ফিল্টার ইংরেজি সংস্করণের ভিত্তিতে সিদ্ধান্ত নেয়, তবে পার্থক্য মাপা দরকার, চেপে যাওয়া নয়।
- অমিলকে মেট্রিক বানানো। নিয়মিত হিসাব করা কাজে দেয়, লিপি বদলালে কত সিদ্ধান্ত বদলায়: নতুন লেবেলিং ছাড়াই অন্ধ দাগ খুঁজে পাওয়ার সস্তা উপায়।
- মূল লিপিতেই পরীক্ষা করা। নাস্তালিক, রোমানি ও code-switching — তিনটি ভিন্ন মোড, আর একটিতে ভালো ফলাফল বাকি দুটিতে কিছুই নিশ্চিত করে না।
- অন্ধভাবে থ্রেশহোল্ড সমান না করা। এক লিপিতে সংবেদনশীলতা বাড়ানো সহজেই অন্য লিপিতে মিথ্যা সক্রিয়তার স্রোতে পরিণত হয়।
- দর্শকসংখ্যা বিবেচনা করা। ২৪৬ মিলিয়ন ভাষী মানুষ — এটি কোনো নিশ ভাষা নয়, বরং যেকোনো বড় প্ল্যাটফর্মের ব্যবহারকারীদের একটি লক্ষণীয় অংশ।
লেখকরা যে সিদ্ধান্তে নিয়ে যান, তা শুষ্ক শোনায়, তবে যথাযথ: নিরাপত্তার নিশ্চয়তা আজ লিপিগুলোর মধ্যে অসমভাবে বিতরণ করা। যতদিন তা আছে, «মডেল নিরাপত্তা পরীক্ষায় পাস করেছে» — এমন একটি দাবি, যা সবসময় স্পষ্ট করা উচিত: কোন ভাষায় এবং কোন অক্ষরে সেই পরীক্ষাগুলো লেখা হয়েছিল।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ড্যাশবোর্ড বিশ্লেষণে GUI এজেন্টদের ধাপে ধাপে ডায়াগনস্টিকস: DashAct বেঞ্চমার্ক
DashAct উপস্থাপন করা হলো—মানুষের দ্বারা যাচাই করা ৩৪৮টি ট্র্যাজেক্টরির একটি বেঞ্চমার্ক, যা ইন্টারঅ্যাকটিভ প্যানেলে GUI এজেন্টদের কাজকে তিনটি ধাপ ও চারটি ভিজ্যুয়াল পরিস্থিতিতে বিশ্লেষণ করে। ফলাফলগুলোতে অ্যাকশন পূর্বাভাস এবং ভিজ্যুয়াল লক্ষ্য শনাক্তকরণে ধারাবাহিক সমস্যা, পাশাপাশি প্রাসঙ্গিক ও স্থানিক সহায়তার ওপর এজেন্টদের প্রতিক্রিয়ার নির্ভরতা দেখা যায়।
11 নভেম্বর 2026
WILSON: রোগীর প্যাথোমরফোলজিক্যাল বিশ্লেষণ ও রিপোর্ট তৈরির জন্য ম্যাগনিফিকেশন ও স্লাইড একত্রিত করা
প্রিপ্রিন্টে WILSON উপস্থাপন করা হয়েছে—একটি ভিশন-ল্যাঙ্গুয়েজ মডেল, যা শুধু একটি আলাদা “সেরা” স্লাইড নয়, বরং সম্পূর্ণ স্লাইডের ছবি এবং একই রোগীর বিভিন্ন বিবর্ধনে তোলা নমুনার সিরিজ এনকোড করে। নির্দিষ্ট কাজের জন্য অতিরিক্ত প্রশিক্ষণ ছাড়াই, উল্লেখযোগ্যভাবে কম কম্পিউটেশনাল ব্যয়ে এটি বিভিন্ন মেট্রিকে বিশেষায়িত ও আরও বড় স্লাইড-মডেলগুলোকে ছাড়িয়ে যায়; পাশাপাশি, এর রোগনির্ণয়মূলক বর্ণনাগুলো প্যাথলজিস্টদের কাছ থেকে বেশি নম্বর পেয়েছে।
11 নভেম্বর 2026
RL সিমুলেটরের ব্যর্থতা নির্ণয়ে ক্যানোনিক্যাল বহুপদী ইনভেরিয়েন্ট: এগুলো আসলে কোথায় কাজে লাগে
এই কাজটি পরীক্ষা করে, প্রশিক্ষণযোগ্য গতিবিদ্যার মডেলগুলোতে পদার্থবিজ্ঞানের সূত্র অন্তর্ভুক্ত করা কতটা যুক্তিযুক্ত: ট্র্যাজেক্টরি থেকে আহরিত এবং গ্রোবনার ভিত্তির মাধ্যমে ক্যানোনিকাল রূপে আনা ইনভারিয়ান্টগুলো পূর্বাভাসে সামান্য উন্নতি আনে, তবে রোগনির্ণয়ে কার্যকর—এগুলো লঙ্ঘিত সীমাবদ্ধতাটি কোথায় ঘটেছে তা নির্দিষ্ট করতে এবং নির্দিষ্ট ভুল প্যারামিটার শনাক্ত করতে সাহায্য করে।
10 নভেম্বর 2026