পণ্য মহাকাশের একটি বিন্দুতে সীমাবদ্ধ নয়
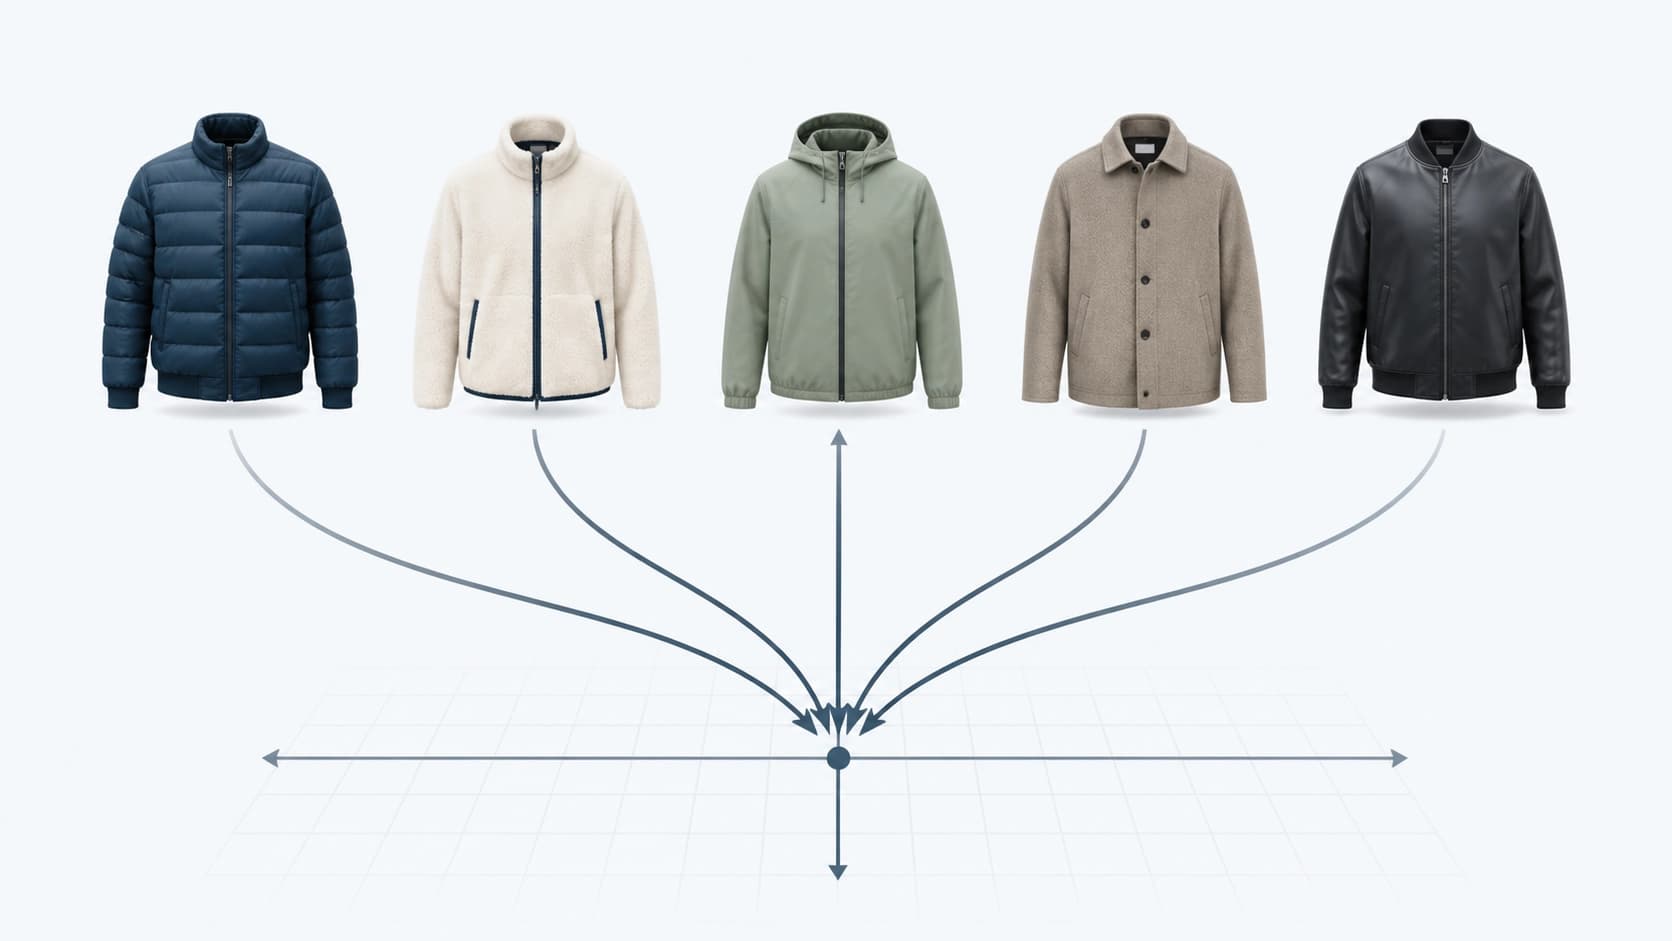
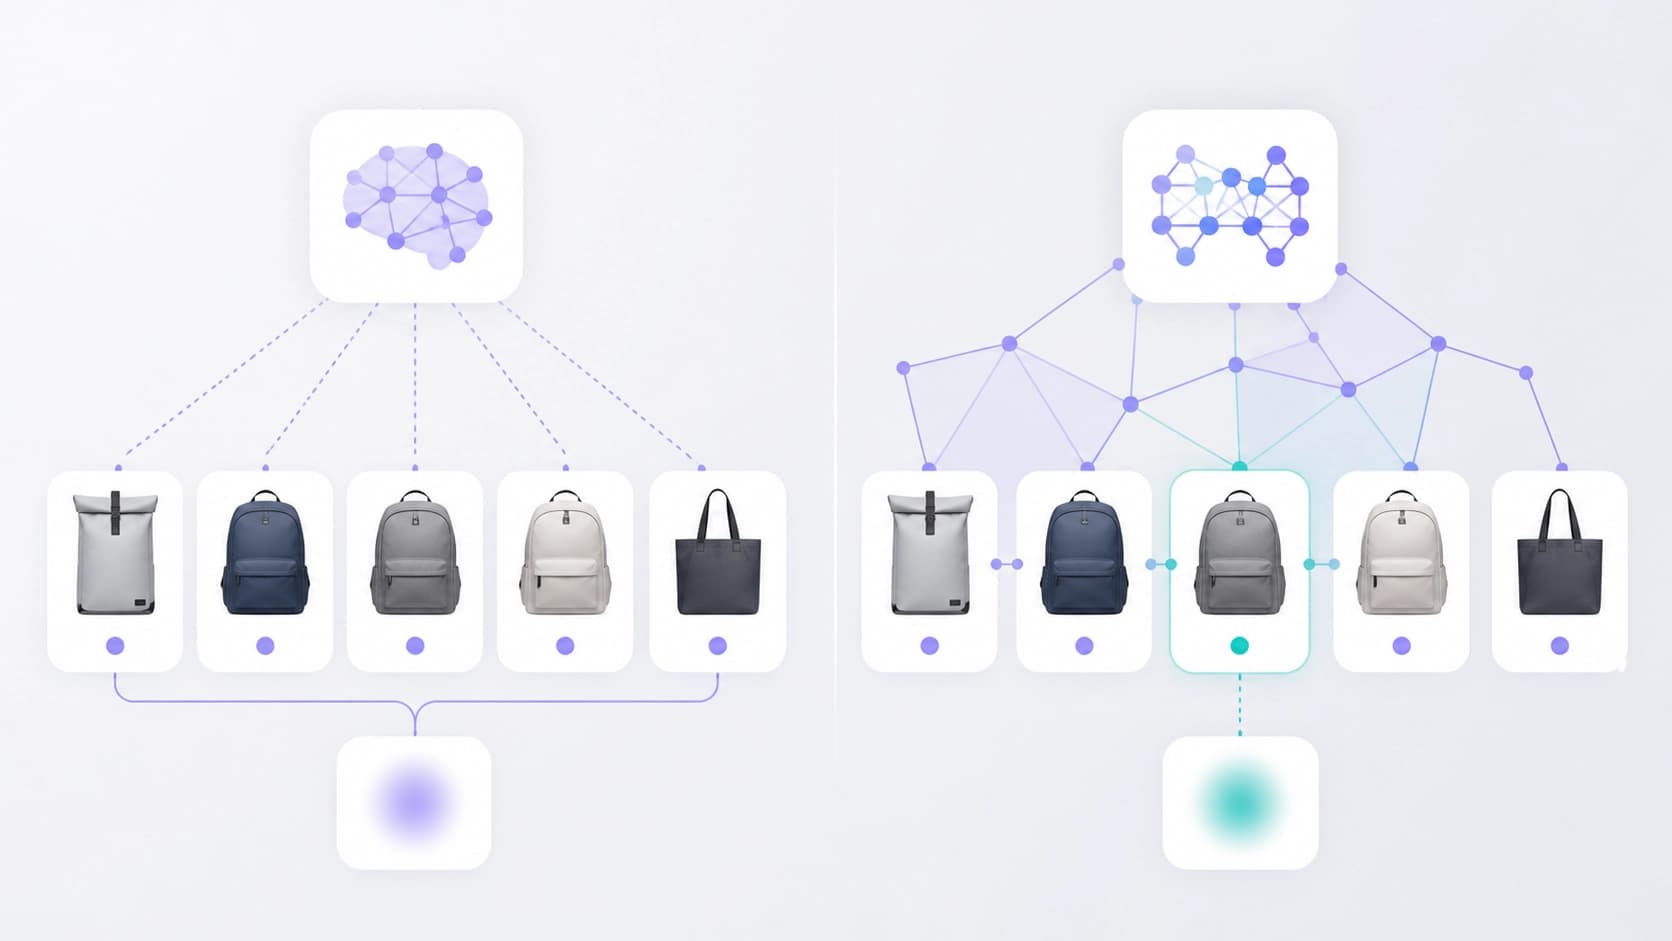
মাল্টিমোডাল বড় ভাষা মডেলগুলো পণ্যের কার্ড বেশ ভালোভাবেই "বুঝতে" শিখেছে: তারা ছবি, নাম ও বিবরণকে একটি একক অর্থগত ক্ষেত্রে যুক্ত করে। কিন্তু এই পদ্ধতির একটি লুকানো খরচ আছে। পণ্যের তথ্য একটি একক গ্লোবাল এমবেডিংয়ে সংকুচিত হয় — একটি গড় ভেক্টর, যেখানে সূক্ষ্ম বিবরণ হারিয়ে যায়। মডেল যত বেশি একসাথে সবকিছু ধরতে চেষ্টা করে, চূড়ান্ত ভেক্টরে তত কম নির্দিষ্টতা অবশিষ্ট থাকে।
এই সংক্ষিপ্ততার মূল্য দেখা যায় এমন কাজে যেখানে ছোট ছোট বিষয়গুলোই গুরুত্বপূর্ণ। ভিন্ন উপাদানের দুটি জ্যাকেট, প্রায় একই গ্লেজের দুটি মগ, ভিন্ন কানেক্টরের দুটি কেবল — দেখতে তারা প্রায় যমজ, আর এমবেডিং ক্ষেত্রে প্রায় একই বিন্দুতে পড়ে। অথচ ব্যবহারকারী "কিছুটা মিল" খুঁজছেন না, বরং নির্দিষ্ট উপাদান, সামঞ্জস্য বা বৈশিষ্ট্য খুঁজছেন। ঠিক এমন কোয়েরিতেই গড় করা বাধা হয়ে দাঁড়ায়: মডেল অ্যাট্রিবিউটগুলো আলাদা করতে পারে না, ফলে র্যাঙ্কিংও আনুমানিক হয়ে যায়।
arXiv:2608.24467 প্রবন্ধটি (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, আগস্ট ২০২৬) সরাসরি রোগনির্ণয় করে: গ্লোবাল এমবেডিংগুলো পণ্যকে সম্পূর্ণভাবে অন্তর্নিহিতভাবে এনকোড করে, আর এটি সূক্ষ্ম-দানাদার অ্যাট্রিবিউট ধরার ক্ষমতাকে সীমিত করে। সহজভাবে "ভেক্টরটা আরেকটু বড় করি" দিয়ে কি এটি সারানো যায়? কাজটির যুক্তি অনুযায়ী — না, সমস্যাটি মাত্রায় নয়, উপস্থাপনের পদ্ধতিতে।
সমতল এমবেডিং তালিকার বদলে হাইপারগ্রাফ
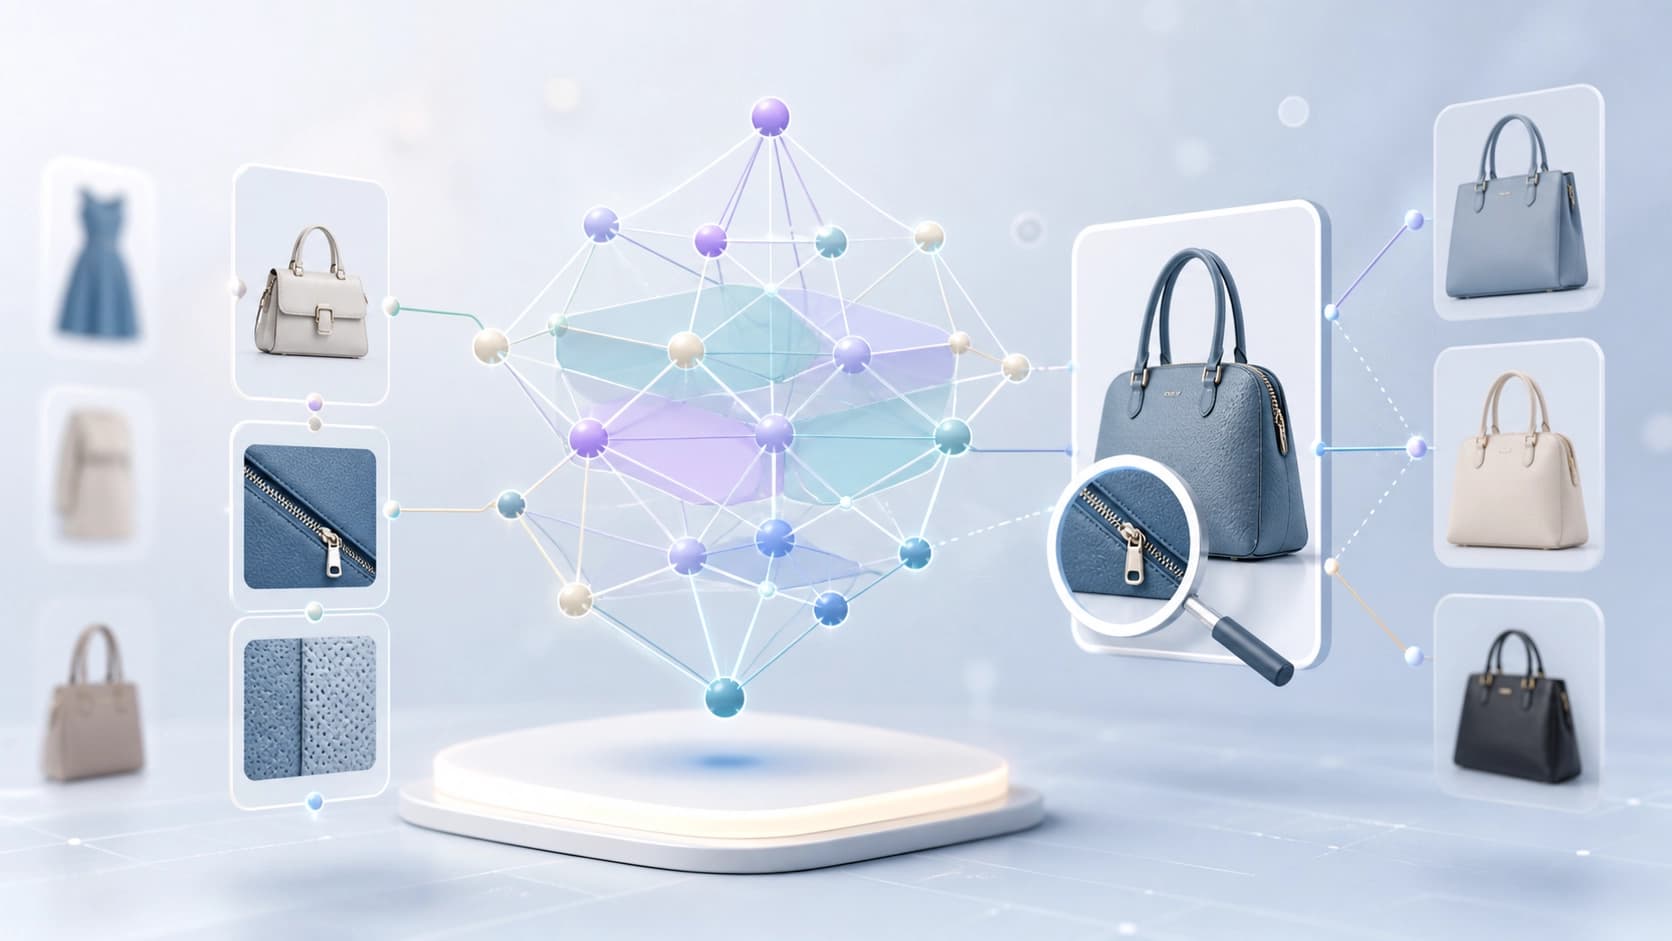
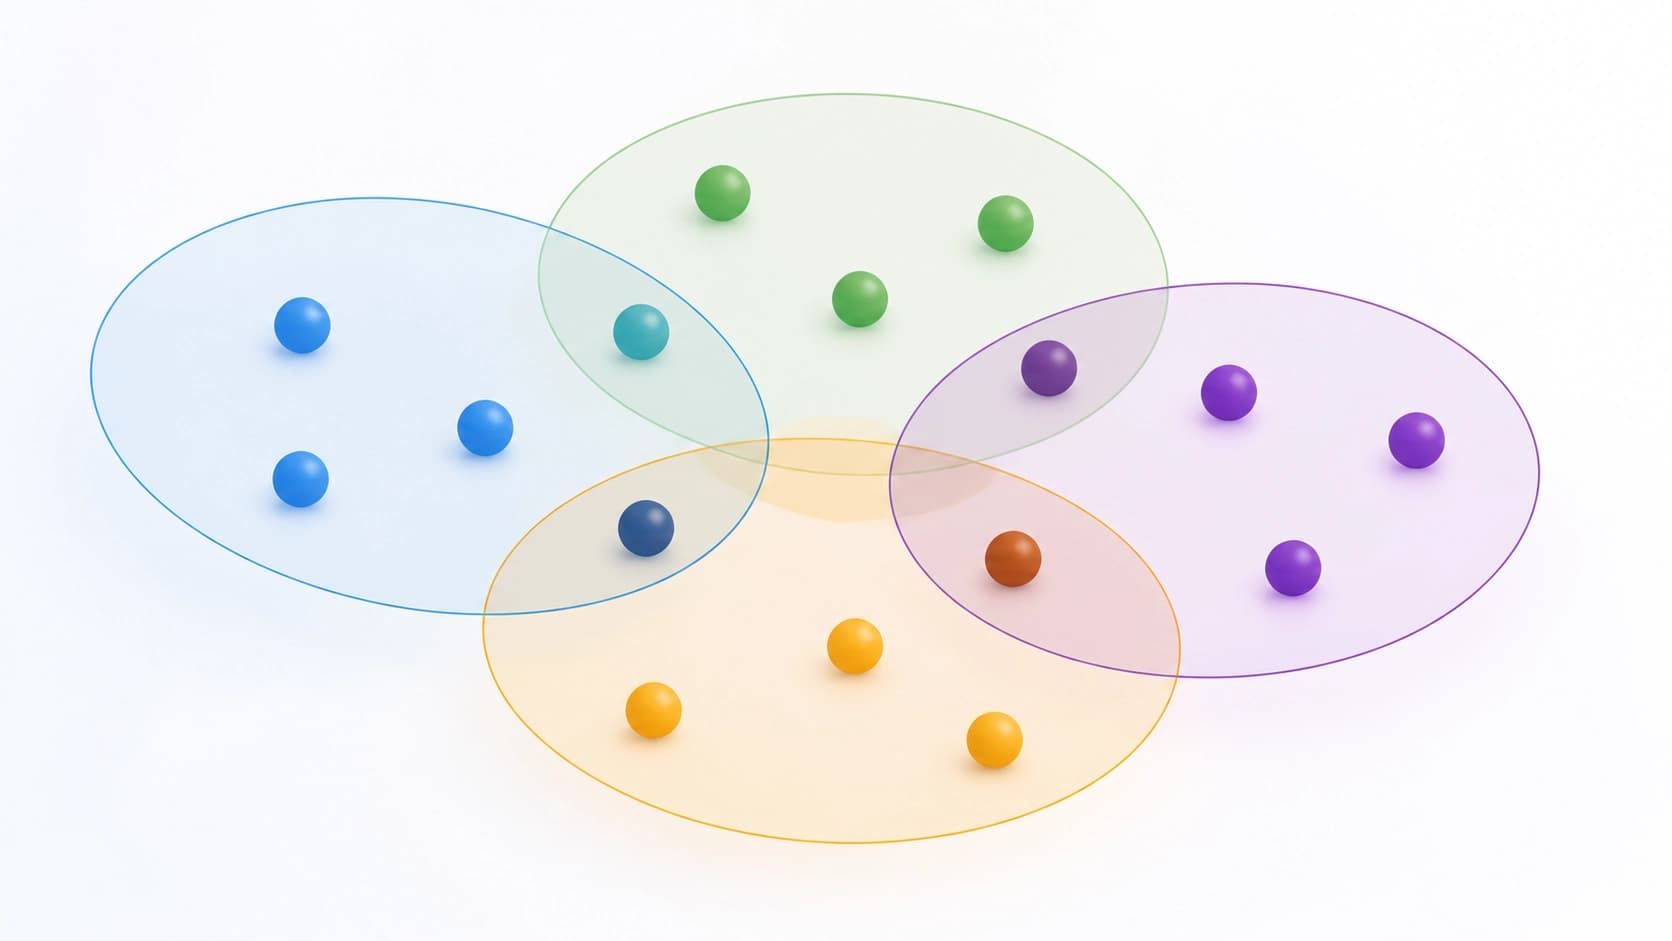
লেখকরা HMGCLIP প্রস্তাব করেন — একটি মাল্টিমোডাল এমবেডিং ফ্রেমওয়ার্ক, যার ভিত্তি একটি হেটেরোজেনিয়াস হাইপারগ্রাফ। প্রচলিত গ্রাফের সাথে পার্থক্যটি মৌলিক। সাধারণ এজ দুটি বস্তুকে যুক্ত করে; হাইপারএজ একসাথে একটি গোটা দলকে সংযুক্ত করে — উদাহরণস্বরূপ, একটি সাধারণ অ্যাট্রিবিউটে একত্রিত একই ক্যাটাগরির সব পণ্য। এমন গঠন জোড়ায় ভাগ করা যায় না এমন সম্পর্ক বর্ণনা করতে দেয়: "এই সাতটি আইটেম একই উপাদানের সিরিজ", "এই চারটি পরস্পর বিনিময়যোগ্য সমতুল্য"।
এরপর হাইপারগ্রাফের টপোলজি দুই দিকে কাজ করে। প্রথমত, এটি থেকে কাঠামোগতভাবে সচেতন জটিল নেগেটিভ বের করা হয় — সেই মিলযুক্ত কিন্তু ভুল উদাহরণগুলো, যেগুলোর উপর মডেল পার্থক্য করতে শেখে। এটি গুরুত্বপূর্ণ বিষয়: জটিল নেগেটিভগুলো কর্পাস থেকে এলোমেলোভাবে বাছা হয় না, সংযোগের কাঠামোই সেগুলো ইঙ্গিত করে। দ্বিতীয়ত, হাইপারগ্রাফের মাধ্যমে বহু-দানাদার সেমান্টিক্স সমন্বয় করা হয় — সম্পর্কের স্তরে এবং হাইপারএজের স্তরে উভয়ই। সহজ কথায়, মডেল কেবল আলাদা পণ্যগুলোই নয়, গোটা অর্থগত দলগুলোও পরস্পরের সাথে সারিবদ্ধ করে।
দুই-দানাদার ইনফারেন্স পদ্ধতির প্রয়োজন কী
আলাদা একটি বিষয় — dual-granularity inference। আউটপুটে সিস্টেম গতিশীলভাবে অ্যাট্রিবিউটিভ প্রমাণগুলো এমনভাবে একত্র করে যাতে সূক্ষ্ম-দানাদার ও স্থূল-দানাদার উভয় কাজেই সমান আত্মবিশ্বাসের সাথে কাজ করতে পারে। ব্যবহারিক তাৎপর্য হলো, একটি কোয়েরির দরকার সাধারণ স্তর ("স্নিকার্স দেখাও"), আরেকটির দরকার চরম সংকীর্ণ স্তর ("মেমব্রেন ও নির্দিষ্ট ধরনের সোলযুক্ত স্নিকার্স")। কেবল সূক্ষ্ম বিবরণে নিবদ্ধ মডেল প্রস্থে হারায়; কেবল সাধারণে নিবদ্ধ মডেল নির্ভুলতায় হারায়। এখানে ধরে নেওয়া হয়েছে, কোন স্তরে দেখতে হবে তা সিস্টেম নিজেই ঠিক করে।
ডেটাসেট ও যাচাই
লেখকরা কেবল আর্কিটেকচারেই সীমাবদ্ধ থাকেননি: তারা একটি বিস্তৃত সূক্ষ্ম-দানাদার ই-কমার্স ডেটাসেট প্রকাশ করেছেন, যাতে কাজটির জন্য ভবিষ্যতের তুলনার একটি পুনরুৎপাদনযোগ্য বেঞ্চমার্ক থাকে। সম্ভবত এটি কাজটির কম মূল্যবান অংশ নয় — প্রকাশ্য ডেটাসেট ছাড়া সূক্ষ্ম-দানাদার পার্থক্য নিয়ে তর্ক করা অর্থহীন, প্রত্যেকে নিজের ডেটাতেই মাপে।
পরীক্ষাগুলো নতুন ডেটাসেটে এবং প্রকাশ্য MAVE বেঞ্চমার্কে চালানো হয়েছে। ফলাফল দ্ব্যর্থহীনভাবে দাবি করা হয়েছে: পদ্ধতিটি শক্তিশালী মাল্টিমোডাল এনকোডার, মাল্টিমোডাল LLM এবং ই-কমার্সের বেসলাইন সমাধানগুলোকে ছাড়িয়ে যায়। নির্দিষ্ট সংখ্যা ও সারণি কাজটিতেই আছে; এখানে গুরুত্বপূর্ণ উপসংহারটি হলো, উপস্থাপনের প্রতি কাঠামোগত দৃষ্টিভঙ্গি এমন সুবিধা দেয় যা কেবল মডেল জটিল করে তোলার মাধ্যমে পাওয়া যায় না।
বাস্তবে এটি কোথায় কাজে লাগবে
প্রথম ও সবচেয়ে স্পষ্ট — অনুসন্ধান ও সমতুল্য পণ্য খোঁজা। যখন ক্রেতা নষ্ট হয়ে যাওয়া জিনিসের বিকল্প খোঁজেন, তার দরকার অ্যাট্রিবিউট অনুযায়ী সামঞ্জস্য, ছবির সাধারণ মিল নয়। দ্বিতীয় — সুপারিশ: ভিন্ন উপাদানের ভ্যারিয়েন্টকে একই পণ্যের অন্য কনফিগারেশন থেকে আলাদা করতে পারলে সেগুলো লাভবান হয়। তৃতীয় — ক্যাটালগের পরিচ্ছন্নতা: ডুপ্লিকেট ও প্রায়-ডুপ্লিকেট, যেগুলো এখন অটোমেশন আন্দাজে জোড়া লাগায়, সূক্ষ্ম-দানাদার উপস্থাপনায় আরও অর্থপূর্ণভাবে আলাদা হয়।
আরও একটি কম স্পষ্ট স্তর আছে — ব্যাখ্যাযোগ্যতা। হাইপারএজগুলো এমন কাঠামো তৈরি করে, যা থেকে দেখা যায় কেন পণ্যগুলো পাশাপাশি এসেছে। র্যাঙ্কিংয়ের ত্রুটি নিয়ে কাজ করা দলগুলোর জন্য এটি দুর্বোধ্য প্রকৃতির ভেক্টরের চেয়ে বেশি কাজের।
এখনো যা খোলা রয়ে গেছে
গ্রাফ কাঠামো নিয়ে যেকোনো কাজ খরচে গিয়ে ঠেকে: হাইপারগ্রাফ তৈরি করতে হয়, আর ক্যাটালগ আপডেট হলে সেটি হালনাগাদ অবস্থায় রাখতে হয়। লক্ষ লক্ষ কার্ডে এটি কতটা সস্তা এবং কত ঘন ঘন এটি পুনর্গঠন করতে হবে, লেখকরা অ্যানোটেশনে প্রকাশ করেননি।
দ্বিতীয় প্রশ্ন — স্থানান্তরযোগ্যতা। ডেটাসেটটি একটি বিষয়ক্ষেত্রেই সংগৃহীত, আর জানা নেই হাইপারএজের আচরণের ধরন কতটা ভালো টিকে থাকবে, ধরা যাক, পোশাক থেকে ইলেকট্রনিকে যাওয়ার সময়, যেখানে অ্যাট্রিবিউটগুলো সম্পূর্ণ ভিন্নভাবে গঠিত। তৃতীয় — এমন পদ্ধতি ইতিমধ্যে চালু প্রোডাকশন পাইপলাইনের সাথে কতটা খাপ খায়: উপস্থাপনের পদ্ধতি বদলানো সাধারণত গোটা সার্চ ইনডেক্স পুনরায় ইনডেক্স করার অর্থ বহন করে।
যাই হোক, দিকটি স্পষ্টভাবে চিহ্নিত। তর্কটি কার মডেল বড় তা নিয়ে নয়, বরং পণ্যের অর্থ সঠিকভাবে কীভাবে সংরক্ষণ করা যায় তা নিয়ে: একটি গড় বিন্দুতে, নাকি সংযোগের জালে, যেখানে সূক্ষ্ম বিবরণ হারিয়ে যায় না।