তিনটি মডেল, একটি লাইসেন্স আর কোনো শর্ত ছাড়া
Granite 4.2 আর আগের রিলিজগুলোর মতো শুধু নির্দেশ অনুসরণে সীমাবদ্ধ অ্যাসিস্ট্যান্ট নয়। IBM পরিবারটিকে স্পষ্ট যুক্তি (reasoning)-এর চারপাশে নতুন করে সাজিয়েছে: যেকোনো মডেল প্রথমে ধাপে ধাপে চিন্তা করে, তারপর উত্তর দেয়। রিলিজে তিনটি সাইজ আছে — 3B, 8B এবং 30B প্যারামিটার।
ব্যবসার জন্য মূল খবরটি বেঞ্চমার্কে নয়, লাইসেন্সে। তিনটি মডেলই Apache 2.0-এর অধীনে বিতরণ করা হচ্ছে: ডাউনলোড, ফাইন-টিউনিং এবং প্রোডাকশনে চালানো — কোনোটির জন্যই অতিরিক্ত অনুমোদন বা বাণিজ্যিক ব্যবহারে কোনো বিধিনিষেধ লাগবে না। নিয়ন্ত্রিত খাতের কোম্পানিগুলোর জন্য অন-প্রেমে ওয়েট রাখার সুবিধা প্রায়ই মেট্রিকের টেবিলের যেকোনো সারির চেয়ে বেশি গুরুত্বপূর্ণ।
পাশাপাশি দুটি স্পিচ মডেলও এসেছে — Granite Speech 5.0 Turbo CTC, প্রতিটি 470 মিলিয়ন প্যারামিটারের; সেগুলো নিয়ে নিচে আলাদাভাবে আলোচনা করা হয়েছে।
কাজের মোড সরাসরি chat-টেমপ্লেটেই বদলানো যায়। একটি thinking মোড আছে, একটি non-thinking, আর মাঝখানে low-effort: সহজ প্রশ্নের জন্য সংক্ষিপ্ত যুক্তি-বাজেট, যাতে যে কাজে দরকার নেই সেখানে টোকেন নষ্ট না হয়। মূলত একই মডেলই সামলায় "ভালো করে ভেবে বলো" আর "দ্রুত উত্তর দাও" — দুটোই।
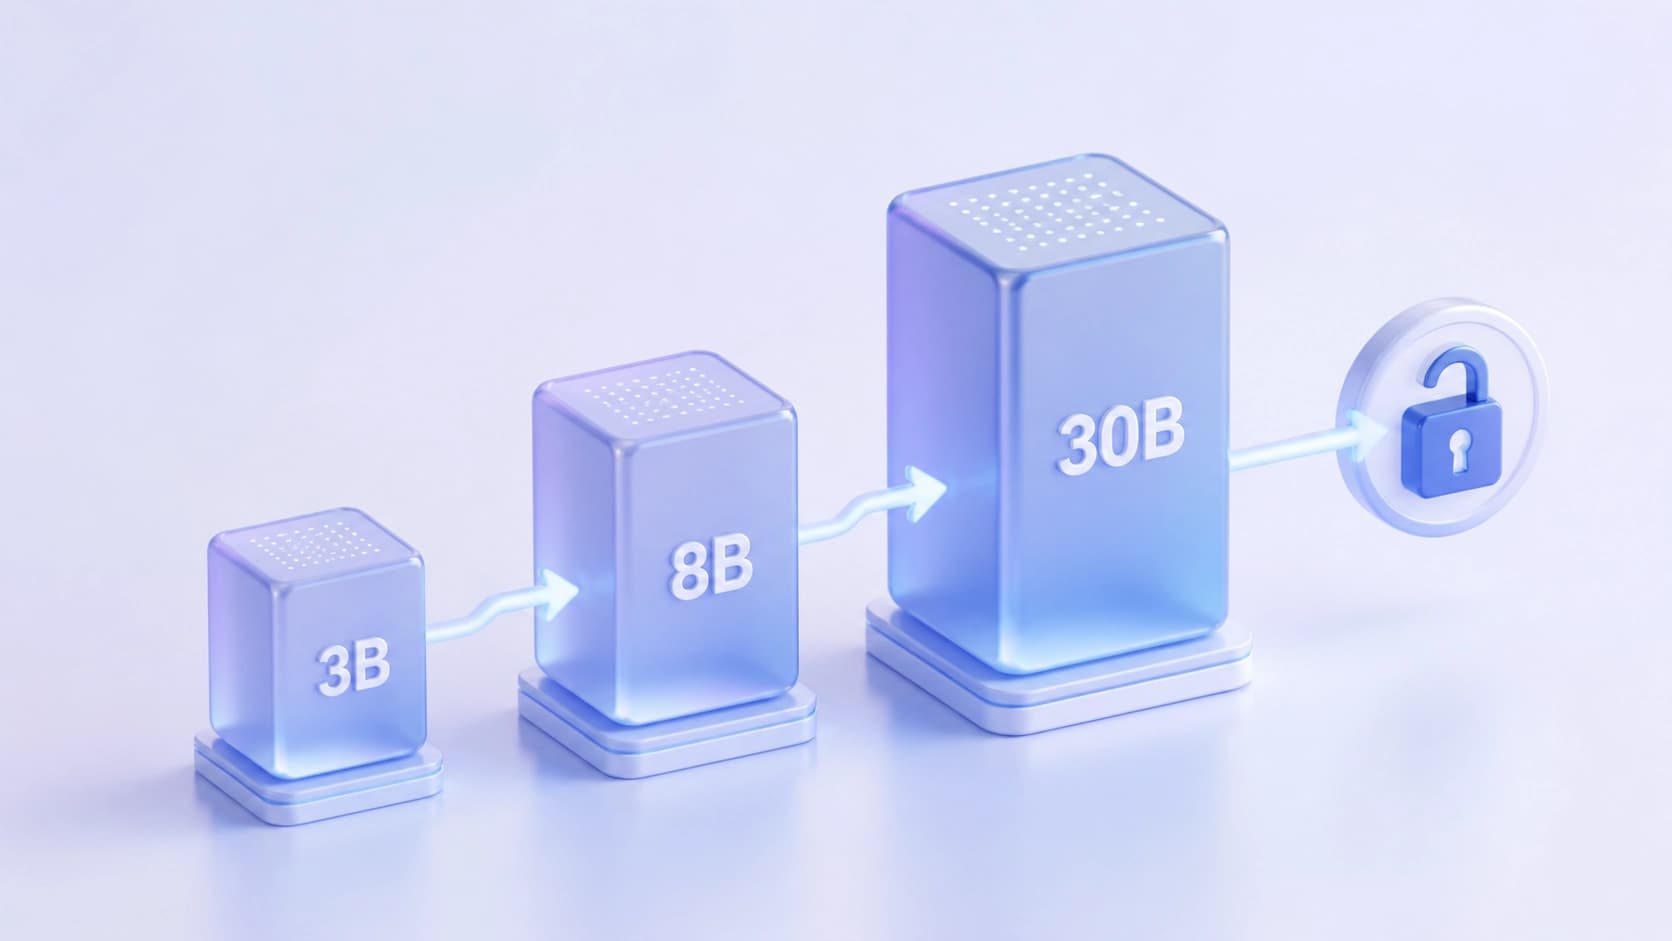
কোন কাজে কোন সাইজ
3B — একজন ডেভেলপারের ল্যাপটপ
ছোট মডেলটি ব্যক্তিগত ডেভেলপার ও ছোট স্টার্টআপের জন্য। এটি Ollama বা LM Studio-এর মাধ্যমে লোকালি চালানো যায়, এমনকি প্রকাশিত GGUF-কোয়ান্টে Q4_K_M পর্যন্ত। এটি হলো "ল্যাপটপে বসিয়ে API-বিলের চিন্তা ছাড়াই পরীক্ষা-নিরীক্ষা" করার পরিস্থিতি।
8B — একটি টিমের জন্য একটি আধুনিক GPU
মাঝারি সাইজটি মিড-মার্কেট টিমের জন্য: একটি আধুনিক গ্রাফিক্স কার্ডই যথেষ্ট মডেলটিকে কাজের পরিবেশে চালু রাখতে।
30B — কর্পোরেট পরিবেশ
বড় ভ্যারিয়েন্টের জন্য A100 বা H100-মানের ক্ষমতা দরকার, সাথে vLLM-এ FP8 বা NVFP4-এ সার্ভ করা। তবে এটাই সেই ক্ষেত্র যেখানে মডেলটি নিজের সীমানার ভেতরে রাখা যায় এবং ডেটা বাইরে পাঠাতে হয় না।
IBM স্পষ্টভাবে যে খাতগুলোকে টার্গেট করছে: সফটওয়্যার ডেভেলপমেন্ট ও ডেভেলপার টুল, আর্থিক সেবা, স্বাস্থ্যসেবা, টেলিকম, সরকারি খাত এবং কনট্যাক্ট সেন্টার — শেষটি বিশেষভাবে নতুন স্পিচ মডেলগুলোর জন্য। সাধারণ ব্যবহারের ক্ষেত্রগুলো — কোড লেখার এজেন্ট, টার্মিনাল ও DevOps অটোমেশন, গভীর গবেষণা ও অনুসন্ধান, দীর্ঘ ডকুমেন্টে RAG, স্ট্রাকচার্ড টুল কলিং এবং বড় আকারে ট্রান্সক্রিপশন।
আর্কিটেকচার: কোনো চালাকি ছাড়া ডেন্স ট্রান্সফরমার
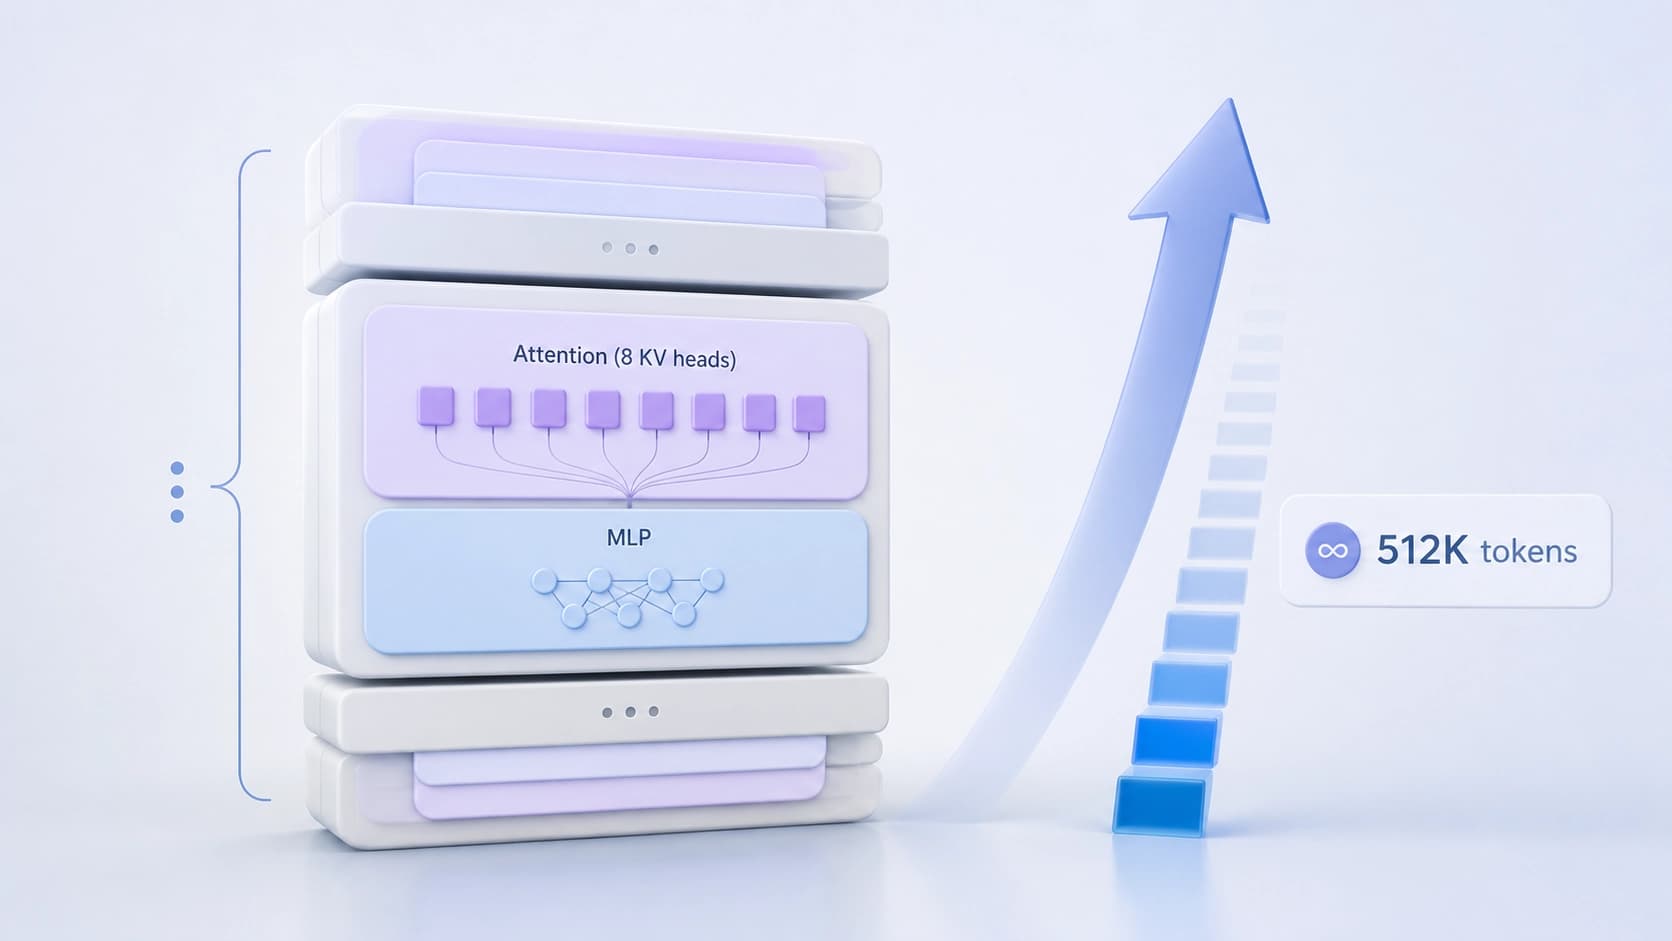
Granite 4.2 হলো decoder-only ডেন্স ট্রান্সফরমার। কোনো হাইব্রিড নয়, কোনো mixture-of-experts নয়: আস্থা রাখা হয়েছে আচরণের পূর্বানুমেয়তা ও ডিপ্লয়মেন্টের সরলতার উপর, যা কর্পোরেট পরিবেশের জন্য যুক্তিসঙ্গত।
প্রযুক্তিগত খুঁটিনাটি:
- 8টি KV-হেডসহ Grouped Query Attention;
- RoPE যেখানে θ = 10 000 000;
- MLP-তে SwiGLU;
- RMSNorm যেখানে ε = 1e-5;
- ইনপুট ও আউটপুট এমবেডিং আলাদা (untied);
- bfloat16 নির্ভুলতা।
সাইজগুলো এভাবে আলাদা: 3B-তে 40টি লেয়ার ও 2560-এর এমবেডিং, 8B-তে একই 40টি লেয়ার কিন্তু এমবেডিং 4096, আর 30B-তে 64টি লেয়ার এবং MLP-এর হিডেন সাইজ 32 768।
প্রকাশিত আর্কিটেকচার টেবিলে সিকোয়েন্স দৈর্ঘ্য বলা হয়েছে 131 072 টোকেন, অর্থাৎ 128K। তবে প্রি-ট্রেনিং রানটি পাঁচটি ফেজে হয়েছিল এবং এতে 512K টোকেন পর্যন্ত লম্বা কনটেক্সটের একটি ধাপ ছিল। স্ক্র্যাচ থেকে ট্রেনিং হয়েছে প্রায় 15 ট্রিলিয়ন টোকেনে।
ট্রেনিং: SFT, তারপর বহু-ধাপের RL
সুপারভাইজড ফাইন-টিউনিং ধাপটি নির্ভর করেছিল প্রায় 7.2 মিলিয়ন স্যাম্পলের উপর — প্রায় 100 বিলিয়ন টোকেন, যার মধ্যে প্রশিক্ষণযোগ্য প্রায় 65 বিলিয়ন। ডেটা মিশ্রণটি এভাবে বিন্যস্ত: 31.6% এজেন্টিক উদাহরণ বনাম 68.4% নন-এজেন্টিক, যেখানে এজেন্টিক অংশের 69% সফটওয়্যার ইঞ্জিনিয়ারিংয়ে।
ট্র্যাজেক্টরিগুলো হার্নেসে সংগ্রহ করা হয়েছে — এর মধ্যে আছে OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex এবং Goose। গুণমান দুইভাবে ফিল্টার করা হয়েছে: বিচারকের ভূমিকায় ছিল GPT-OSS-120B ও Gemma 4, সাথে tools ও messages ফিল্ডে SHA-256 অনুযায়ী ডিডুপ্লিকেশন।
পোস্ট-ট্রেনিং একবারের প্রক্রিয়া নয়, বরং কয়েকটি পরিবেশে RL-এর একটি শৃঙ্খল। প্রতিটি ধাপ আলাদা অ্যাসিঙ্ক্রোনাস GRPO রান, যা আগের চেকপয়েন্ট থেকে warm-start হয়; value-নেটওয়ার্কের বদলে leave-one-out বেসলাইন ব্যবহার করা হয়, আর ক্লিপড ইমপর্ট্যান্স স্যাম্পলিং off-policy ড্রিফট সীমিত করে। ক্রমটি এমন: প্রথমে RLVR, তারপর skill boosters, তারপর SWE, Terminal ও Search, এবং শেষে RLHF।
এখানেই রিলিজের সবচেয়ে গুরুত্বপূর্ণ সীমাবদ্ধতা: এজেন্টিক RL ব্লকটি শুধু 8B ও 30B-তে প্রয়োগ করা হয়েছে। ছোট 3B শুধু বেসিক RL ও অ্যালাইনমেন্টের মধ্য দিয়ে গেছে — আর এটাই মূলত সাইজগুলোর মধ্যে সক্ষমতার ব্যবধান ব্যাখ্যা করে। ট্রেনিং হয়েছে NeMo-RL ও NeMo-Gym-এ, CoreWeave-এ রাখা NVIDIA GB200 NVL72 ক্লাস্টারে। অতিরিক্তভাবে পাইপলাইনে CodeAlchemy থেকে 1 ট্রিলিয়ন টোকেন সিন্থেটিক কোড এবং সার্ভিং দ্রুত করার জন্য একটি স্পেকুলেটিভ ডিকোডিং স্তর যুক্ত করা হয়েছে।
IBM-এর মেট্রিক কী দেখায়
সংখ্যাগুলো IBM নিজেই দাবি করেছে, তাই এগুলোকে স্বাধীন যাচাই নয়, বরং একটি দিশা হিসেবে পড়া উচিত। মানের ক্রম — 3B / 8B / 30B:
- SWE-Bench Verified: 3B-এর জন্য কোনো মূল্যায়ন নেই, 8B-তে — 47.6, 30B-তে — 57.00;
- Terminal-Bench 2.1: যথাক্রমে 20.56 ও 29.24;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38।
কৌতূহলোদ্দীপক একটি বিষয় — ফাংশন কলিং পরীক্ষায় 8B কিছুটা 3B-এর চেয়ে পিছিয়ে (50.29 বনাম 52.41)। এটি মনে করিয়ে দেয় যে আকার নিজে থেকে প্রতিটি আলাদা দক্ষতায় সুবিধার নিশ্চয়তা দেয় না, আর কাজ অনুযায়ী মডেল বাছাই করা বড় চেকপয়েন্টের পেছনে ছোটার চেয়ে বেশি জরুরি।
স্পিচ: LLM-ব্যাকবোন ছাড়া 470 মিলিয়ন প্যারামিটার
Granite Speech 5.0 Turbo CTC স্পিচ মডেলগুলো ভাষা-মডেল-ভিত্তিক প্রচলিত ASR সিস্টেমের চেয়ে মৌলিকভাবে আলাদা: এখানে LLM-ব্যাকবোন একেবারেই ব্যবহার করা হয় না, বরং অডিও থেকে টেক্সটে রূপান্তর করা হয় connectionist temporal classification-এর মাধ্যমে। এখান থেকেই কমপ্যাক্টতা — 470 মিলিয়ন প্যারামিটার।
IBM দাবি করছে একটি H200-এ RTFx প্রায় 12 600, যেখানে Open ASR লিডারবোর্ডে গতির বর্তমান শীর্ষস্থানীয়রা দেখায় প্রায় 6 000। বড় আকারের রেকর্ডিংয়ের ভলিউম থাকা কনট্যাক্ট সেন্টারগুলোর জন্য থ্রুপুটের এই পার্থক্য সরাসরি টাকায় রূপান্তরিত হয়। WebGPU-তে একটি ডেমোতে মডেলটি চেষ্টা করে দেখা যায়।
সব মিলিয়ে
IBM কর্পোরেট বাজারের জন্য একটি পূর্বানুমেয় পণ্য দাঁড় করিয়েছে: আর্কিটেকচারাল অদ্ভুততা ছাড়া ডেন্স মডেল, উন্মুক্ত লাইসেন্স, নিজের হার্ডওয়্যারে ডিপ্লয়মেন্ট এবং বিভিন্ন ধরনের কাজের জন্য আলাদা যুক্তি-মোড। এজেন্টিক সক্ষমতা 8B ও 30B-তে কেন্দ্রীভূত, তাই 3B-কে যুক্তিসঙ্গতভাবে একটি সস্তা প্রবেশবিন্দু ও সরল পরিস্থিতির মডেল হিসেবে দেখা উচিত, কোনো ক্ষতি ছাড়া "ছোট ভাই" হিসেবে নয়। বিস্তারিত IBM Research ব্লগ, টেকনিক্যাল ডেসক্রিপশন এবং GitHub রিপোজিটরিতে মিলিয়ে দেখা উচিত, যেগুলোর লিংক রিলিজের সাথে দেওয়া আছে।