
এমিলির সাথে ভিডিও পরামর্শ: ডাক্তারের স্তরে গুগলের AI সিস্টেম সম্পন্ন হয়েছে
গুগলের পরীক্ষামূলক মেডিকেল AI সিস্টেম অভিনেতা-পার্টের সাথে সুসংগত ভিডিও আলোচনা পরিচালনা করেছে এবং যারা সরাসরি চিকিৎসকের মত মূল্যায়ন লাভ করেছে তাদের কাছ থেকে মূল্যায়ন লাভ করেছে। এই গবেষণা দেখায় যে, ব্যবহারিক ব্যবহারিক প্রয়োগের চূড়ান্ত উপসংহারে পৌঁছানো সম্ভব ।.
সাম্প্রতিক বছরগুলোতে, কৃত্রিম বুদ্ধিমত্তা ঔষধের ওপর ক্রমবর্ধমানভাবে আস্থা গড়ে তুলেছে, কিন্তু বেশির ভাগ সিস্টেম টেক্সট তথ্য বা ব্যক্তিগত কাজের মাধ্যমে কাজ করছে। গুগল থেকে নতুন গবেষণা এই কথোপকথনকে ভিন্ন স্তরে তুলে ধরেছে: কোম্পানিটি সরাসরি ভিডিও আলোচনার মাধ্যমে পরীক্ষা করেছে, আর এর ফলাফল হচ্ছে চিকিৎসকদের অনুশীলনের কাজের সমান। এর মানে এই নয় যে AI ডাক্তারকে প্রতিস্থাপনের জন্য প্রস্তুত, কিন্তু তারা ইতোমধ্যে পরীক্ষা পরিচালনা করতে পারে এবং একজন প্রাথমিক যত্ন বিশেষজ্ঞের পর্যায়ে চিকিৎসা ইতিহাস সংগ্রহ করতে পারে।
গবেষণা যা দেখিয়েছে
এই বিচারের মধ্যে ১৫ জন পেশাদার অভিনেতা, যারা পাঁচটি এলাকায় রোগীদের বিরুদ্ধে অভিযোগ নিয়ে কাজ করে: কার্ডপিলোম বিষয়, ব্যথা, মানসিক রোগ এবং চোখের লক্ষণ, নিউরোক্লোকালিক এবং মানসিক অবস্থা, এবং একই সাথে গাকুলোলোলোলোলোতার পথও রয়েছে। সকল পরামর্শ একটি সুসংগত ভিডিওর আকারে অনুষ্ঠিত হয়: আমি বিশ্বাস করি অভিনেতার সাথে প্রতারণা, প্রশ্ন করা এবং ভার্চুয়াল পরীক্ষা করার চেষ্টা করা।
কিন্তু, চিকিৎসাবিজ্ঞানের ক্ষেত্রে তা সম্ভব নয় । অবাক হওয়ার মতো বিষয় হলো যে চেরনোবিলের স্কোর একই পরিকল্পনার অধীনে যারা সরাসরি ডাক্তারদের সাথে কাজ করে তাদের সাথে অনুরুপ হয়েছে। এটা কেবল অভিযোগ সংগ্রহ করার জন্যই প্রযোজ্য নয় কিন্তু সেইসঙ্গে ডায়োজিনীস, সুপারিশ এবং যোগাযোগের গুণগত মানও ঠিক করে । ভিডিও বিন্যাসটি টেক্সট চ্যাটের সুবিধা লাভ করেছে: চিকিৎসকরা একটি ভিডিও স্ট্রিমিং এর মাধ্যমে এই পদ্ধতিকে উন্নত করে ভার্চুয়াল পরীক্ষার মাধ্যমে অভিনেতাদের খুঁজে বের করার জন্য এবং পরিচালনায় নির্দেশনা প্রদান করে। অভিনেতারা নিজেরাই নিজেদের পছন্দসই ভিডিও পছন্দ করেন- তারা সমস্যা বর্ণনা করার জন্য এটি আরও সুবিধাজনক এবং কার্যকরভাবে খুঁজে পান।
AEEI কিভাবে কাজ করে
সফল হওয়ার রহস্য অস্বাভাবিক স্থাপত্যে আছে। Amemini একটি অ্যামি-agent স্কীম ব্যবহার করে যেখানে তিনজন স্বাধীন এজেন্ট এই প্রক্রিয়ার জন্য দায়ী। প্রথম, বিক্রেতাকীভাবে আমরা দেখাতে পারি যে, আমরা যিহোবার ওপর নির্ভর করি? দ্বিতীয় এজেন্ট, পরিকল্পনা করা হচ্ছেঅতীতে কাজ করা: এটা ক্রমাগত বিভিন্ন রোগনির্ণয় এবং চিকিৎসা পরিকল্পনা সম্বন্ধে তাজা সংবাদ প্রদান করে থাকে, যা হারিয়ে যাচ্ছে তা চিহ্নিত করে এবং প্রশ্ন করার কৌশলকে সমন্বয় করে। তৃতীয়টা-ছবিএগুলো ভিডিও ও অডিও স্ট্রিমগুলোর বিশ্লেষণ করে থাকে ।
পরিশ্রমের এই ভাগটি কথাবার্তা বলার এজেন্টকে ধীরে ধীরে সাড়া দেওয়ার সুযোগ দেয় । এর ফলে, কথাবার্তার ধরন স্বাভাবিক বলে মনে হয়, কোনো বিরতি ছাড়াই । সম্মেলনের চ্যাটবোট থেকে এটি গুরুত্বপূর্ণ, যা সম্পূর্ণ ভাবে একটি অনুরোধের প্রক্রিয়া এবং তারপর থেকে এর উত্তর আসে।
পদ্ধতি এবং ফলাফল
এই গবেষণাটি একটি এলোমেলো মাল্টি-আর্ম বিচারের মতো ডিজাইন করা হয়েছে। একই ভিডিও চিত্র ব্যবহার করে একই পদ্ধতির একটি টেক্সট সংস্করণ এবং একই ভিডিও ইন্টারফেস ব্যবহার করে দশ প্রকার প্রাথমিক চিকিৎসা চিকিৎসকের একটি দল মিলে তাকে তুলনা করা হয়েছে। সকল পরামর্শ তখন এক বিশেষজ্ঞ প্যানেল অন্ধভাবে দু’টি শর্তের বিরুদ্ধে যুক্তি উপস্থাপন করে: সামগ্রিকভাবে প্রতিদ্বন্দ্বিতা এবং দৃশ্যের দক্ষতা।
এর সাথে, গুগল টেলিমেক্রেটিক প্রতিযোগিতার উপর ভিত্তি করে একটি স্বয়ংক্রিয় মূল্যায়নের স্যুইট তৈরি করেছে। এটি নির্দিষ্ট ধারণা পরীক্ষা- উদাহরণ হিসেবে বলা যায়, একটি আনবিক দিক বা শ্বাসরুদ্ধকর যন্ত্রণাকে পৃথক করার ক্ষমতা। কিছু সিমুলেশনের মধ্যে ভিডিও স্ট্রিম দেখার জন্য বিভিন্ন তথ্য ব্যবহার করা হয়েছিল । ( মথি ২৪: ৪৫ - ৪৭) এটা সেই ব্যবস্থার দুর্বলতাকে দ্রুত শনাক্ত করে এবং অভিনেতাদের সঙ্গে বিচার করার আগে এর নকশাকে সংশোধন করে ।
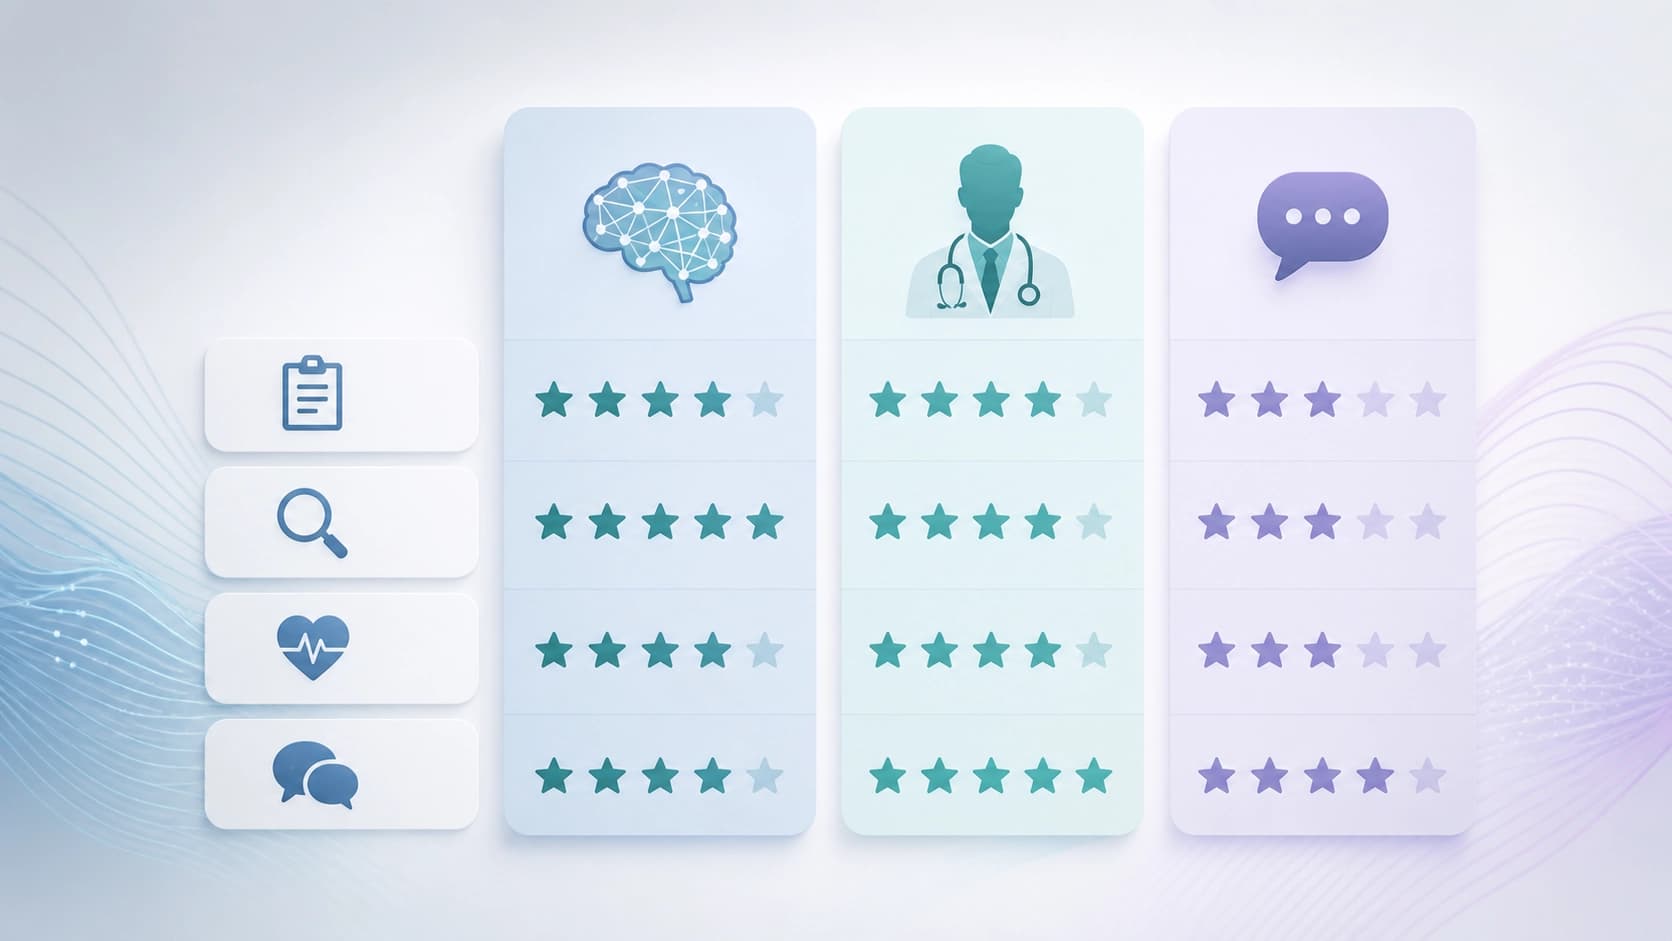
চূড়ান্ত মূল্যায়ন দেখিয়েছিল যে, তিন জন এজেন্টের প্রত্যেকে চিকিৎসা সংক্রান্ত মেট্রিকগুলো উন্নত করার ক্ষেত্রে অবদান রাখে: ইতিহাস, চিকিৎসা সংক্রান্ত যুক্তি, সুপারিশ, যোগাযোগ এবং প্রতিক্রিয়া। ভিডিও, যা সব প্রধান রেখার সাথে মিলে যায় এবং এর বেশির ভাগ ক্ষেত্রে লেখা সংস্করণকে সঠিক প্রমাণ করে। ভিডিওর দৃশ্য যেখানে তোলা হয়েছিল, সেখানে সম্ভবত গতি, কিন্তু তা গ্রহণযোগ্য বলে প্রমাণিত হয়েছে।
সীমা ও সম্ভাবনা
এর উল্লেখযোগ্য ফলাফল সত্ত্বেও, গবেষণাকারীরা নিজেরাই গুরুতর সীমাবদ্ধতা সম্বন্ধে সাবধান করে । মূল বিষয়টি হচ্ছে অভিনেতারা সত্যিকার রোগী, তাদের লক্ষণ, আচরণ, সংযোগের গুণগত মান, পরিবেশ এবং চিকিৎসা ইতিহাস সব সময় তৈরি স্ক্রিপ্টের চেয়ে প্রসারিত করে। এছাড়াও, অডিওভিজুয়াল ধারণা বিশেষ করে গুরুত্বপূর্ণ তথ্য প্রদান করতে পারে, বিশেষ করে এই দৃশ্য থেকে যে তথ্য পাওয়া যায় তা ইচ্ছাকৃতভাবে বাদ দেওয়া হয়নি-কারণ অভিনেতারা তাদের চিত্রগ্রহণ করতে পারে না।
স্বয়ংক্রিয় মূল্যায়ন বা অনুকরণমূলক পরামর্শের কোনটাই প্রমাণ করে না যে এই পদ্ধতি একটি বাস্তব ক্লিনিকে সমানভাবে কাজ করবে। গুগল বর্তমানে প্রায় কোন উৎপাদনশীল তথ্য নেই- সকল বাস্তব বিশ্ব-বিশ্ব সীমানা এখনো টেক্সট ভিত্তিক। তাই, কোন কথা বলার আগে... ...ভবিষ্যৎ, পূর্ণ-আধুনিক পরীক্ষার প্রয়োজন, যেখানে মানুষের লক্ষণ আর আচরণ খুব কম অনুমান করা হয়।
তা সত্ত্বেও, এটা সত্যি যে চেরনোবিল একটি ভিন্ন রোগনির্ণয় করতে পারে, চিকিৎসা বিষয়ক ইতিহাস সংগ্রহ করতে পারে এবং একজন সাধারণ ডাক্তারের পর্যায়ে ভার্চুয়াল পরীক্ষা করতে পারে। ভবিষ্যতে, এই ধরনের ব্যবস্থা ডাক্তারদের জন্য সহায়ক হতে পারে, বিশেষ করে টেলিমেডিন- কিন্তু এখন পর্যন্ত এটা কেবল একটি গবেষণা যন্ত্র, যা তৈরি করা কোন চিকিৎসা টুল নয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
OpenCollab: এজেন্টদের প্রোগ্রামযোগ্য সমন্বয়, নিয়ন্ত্রিত রানটাইম পরিবেশ এবং প্রোটোকল মেনে চলার মেট্রিক
ফ্রেমওয়ার্কটি এজেন্টদের পারস্পরিক ক্রিয়াকলাপের কাঠামো নির্ধারণ, পরীক্ষার জন্য একটি অভিন্ন পরিবেশ এবং ইভেন্টের বিস্তারিত ট্রেসিংকে একত্র করে; নতুন প্রবর্তিত Adherence মেট্রিকটি দেখায়, বাস্তব সম্পাদন ঘোষিত কাঠামোর সঙ্গে কতটা সামঞ্জস্যপূর্ণ। বেঞ্চমার্কে Duo কনফিগারেশন নতুন SOTA অর্জন করে, অন্যদিকে একক-এজেন্ট সংস্করণে টোকেন খরচ সবচেয়ে কম।
11 নভেম্বর 2026
Toollery: ফাইন-টিউনিং ছাড়াই কয়েক দশ হাজার বিকল্প থেকে LLM এজেন্টের জন্য টুল নির্বাচন
Toollery দক্ষতা ও টুলের বিবরণের ওপর ভিত্তি করে একটি সার্চ ইনডেক্স তৈরি করে এবং অনুরোধের সময় মডেলকে কেবল সীমিতসংখ্যক সম্ভাব্য প্রার্থী দেয়। কয়েক দশ হাজার ফাংশন পর্যন্ত বিস্তৃত লাইব্রেরিতে চালানো পরীক্ষায় দেখা গেছে, নির্দিষ্ট top-K বজায় রেখেও এই পদ্ধতি বাছাইয়ের মান ধরে রাখতে পারে, যদিও চূড়ান্ত ফল নির্ভর করে ব্যবহারের ধরন এবং প্রোভাইডারের ক্যাশিংয়ের ওপর।
11 নভেম্বর 2026
ড্যাশবোর্ড বিশ্লেষণে GUI এজেন্টদের ধাপে ধাপে ডায়াগনস্টিকস: DashAct বেঞ্চমার্ক
DashAct উপস্থাপন করা হলো—মানুষের দ্বারা যাচাই করা ৩৪৮টি ট্র্যাজেক্টরির একটি বেঞ্চমার্ক, যা ইন্টারঅ্যাকটিভ প্যানেলে GUI এজেন্টদের কাজকে তিনটি ধাপ ও চারটি ভিজ্যুয়াল পরিস্থিতিতে বিশ্লেষণ করে। ফলাফলগুলোতে অ্যাকশন পূর্বাভাস এবং ভিজ্যুয়াল লক্ষ্য শনাক্তকরণে ধারাবাহিক সমস্যা, পাশাপাশি প্রাসঙ্গিক ও স্থানিক সহায়তার ওপর এজেন্টদের প্রতিক্রিয়ার নির্ভরতা দেখা যায়।
11 নভেম্বর 2026