যাচাইযোগ্য পুরস্কার এবং তার অন্ধ জোন
যাচাইযোগ্য পুরস্কার-ভিত্তিক রিইনফোর্সমেন্ট লার্নিং ভাষা মডেলের জন্য একটি পরিচিত রেসিপি হয়ে দাঁড়িয়েছে: একটি কাজ থাকে যার উত্তর সুনির্দিষ্টভাবে যাচাই করা যায় — গণিত, কোড, সংক্ষিপ্ত উত্তরের প্রশ্ন — এবং একটি "সমাধান করেছে / করেনি" সংকেত থাকে। এই স্কিম কাজ করে, তবে এর একটি সুপরিচিত দুর্বলতা আছে। চূড়ান্ত পুরস্কার পুরো ফলাফলকে মূল্যায়ন করে, সেখানে পৌঁছানোর পথকে নয়। মডেল বানানো ভিত্তির উপর দাঁড়ানো সঠিক সিদ্ধান্তের জন্য নম্বর পেতে পারে, আবার ঠিক তেমনি সঠিক যুক্তি কিন্তু ব্যর্থ চূড়ান্ত উপস্থাপনার জন্য নম্বর হারাতে পারে।
ঠিক এখানেই হ্যালুসিনেশনের ঝুঁকি বাস করে। যদি পুরস্কার কেবল চূড়ান্ত মিলের উপর নির্ভর করে, তাহলে নীতির পথে সতর্ক হওয়ার কোনো প্রণোদনা থাকে না — উত্তর আন্দাজ করাই যথেষ্ট। এটি সংশোধনের একটি উপায় হলো প্রক্রিয়া-স্তরে তথ্যগত নিয়ন্ত্রণ যোগ করা: কেবল চূড়ান্ত ফলাফল নয়, মধ্যবর্তী দাবিগুলোও যাচাই করা।
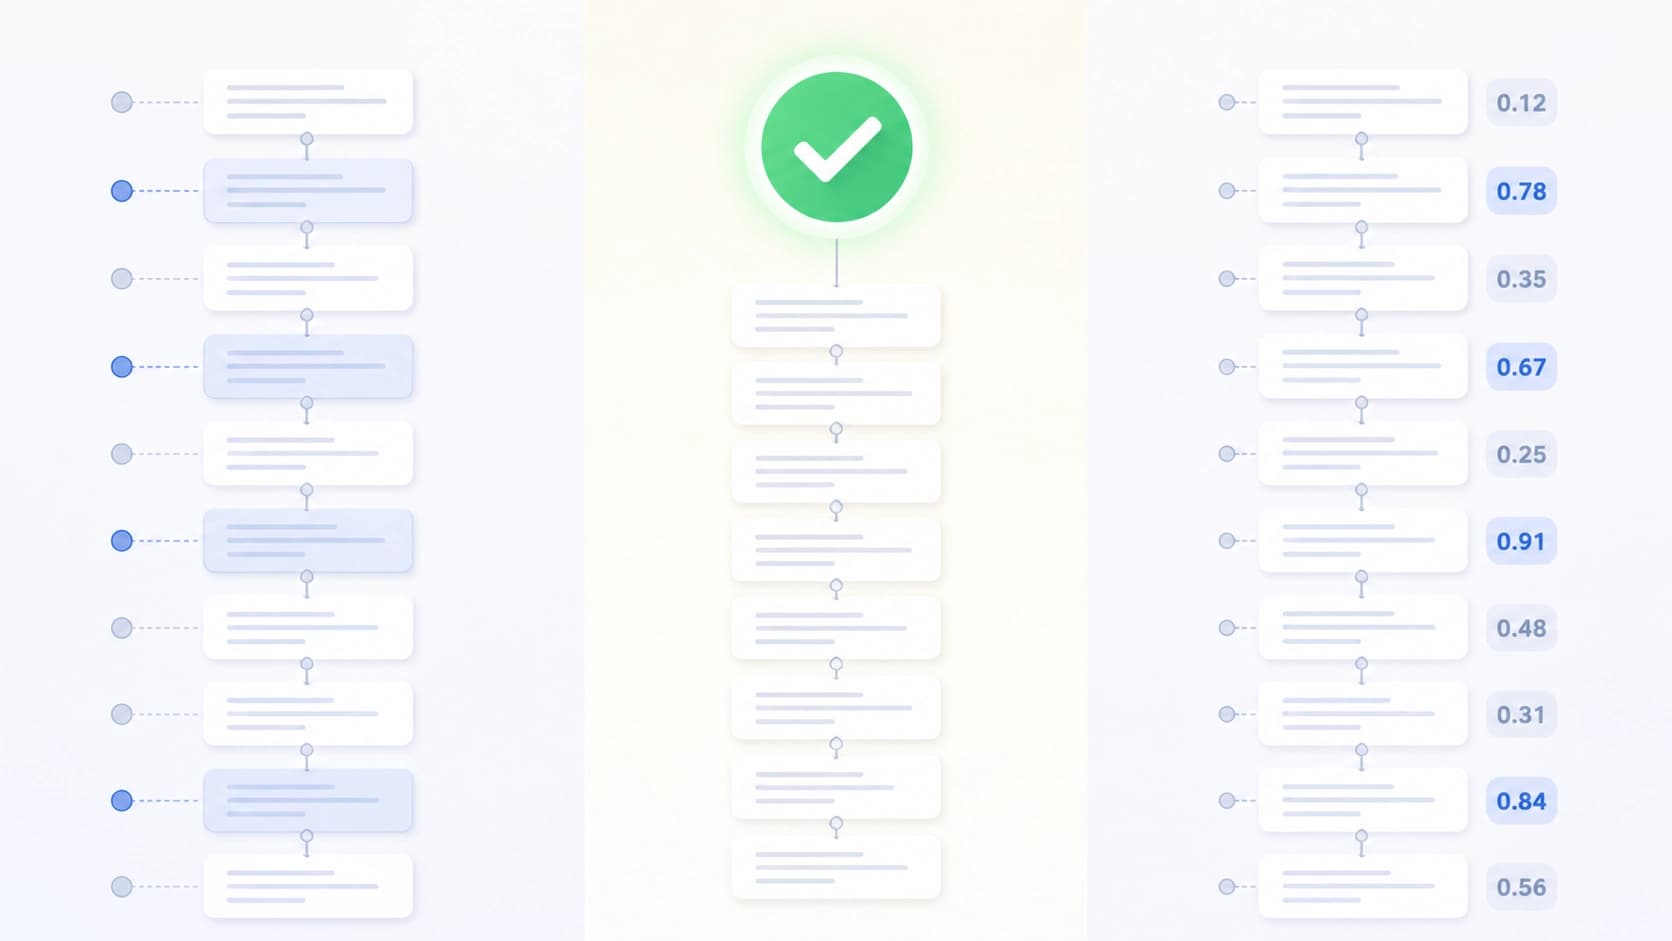
কিন্তু process-level পদ্ধতির নিজস্ব একটি সমস্যা ধরা পড়ে। তথ্য যাচাইগুলো সংগৃহীত হয় এবং মোটা দাগে গড় করা হয়: সংকেত পুরো অংশের জন্য একসাথে আসে, আর যাচাইগুলোর নির্ভরযোগ্যতা নিজেই কেউ মূল্যায়ন করে না। ফলস্বরূপ, যা সত্যিই যাচাই করা হয়েছে এবং যা সত্যিই নীতিতে হালনাগাদ করা হয়েছে — এর মধ্যে একটি ফাঁক তৈরি হয়।
একটি সমস্যার বদলে দুটি অস্পষ্টতা
arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) গবেষণাপত্রের লেখকরা এই ফাঁকটির একটি নাম দেন — "শব্দযুক্ত তথ্যগত ক্রেডিট অ্যাসাইনমেন্ট" (noisy factual credit assignment) — এবং এটিকে দুটি স্বাধীন দিক থেকে বিশ্লেষণ করেন।
- ক্রেডিট স্থানীয়করণের অস্পষ্টতা। কোন টোকেন বা অংশকে কৃতিত্ব বা দোষ দেওয়া হবে, তা স্পষ্ট নয়। তথ্য বাক্য-স্তরে যাচাই করা হয়েছে, কিন্তু হালনাগাদ হয় টোকেন-স্তরে — গ্রানুলারিটি মেলে না, আর সংকেত ছড়িয়ে পড়ে।
- ক্রেডিট নির্ভরযোগ্যতার অস্পষ্টতা। যাচাইয়ের উপর কতটা বিশ্বাস করা যায়, তা স্পষ্ট নয়। কিছু তথ্যগত রায় নির্ভরযোগ্য ও পুনরুৎপাদনযোগ্য, আবার কিছু টালমাটাল, প্রসঙ্গ বা নির্দিষ্ট উপস্থাপনার উপর নির্ভরশীল। আস্থার ওজন ছাড়া এগুলো সমান অধিকারে প্রশিক্ষণে ঢুকে পড়ে।
দ্বিতীয় দিকটি সবচেয়ে কম মূল্যায়িত। তথ্যগত সংকেত সামলানোর প্রচলিত স্কিমগুলো এমনভাবে আচরণ করে যেন সব যাচাই সমান মানসম্পন্ন। বাস্তবে তা নয়, আর দুর্বল যাচাইগুলো শক্তিশালী যাচাইয়ের মতোই অপটিমাইজেশন নষ্ট করতে শুরু করে।
FARCA কীভাবে গঠিত
FARCA-এর পূর্ণরূপ হলো Fact-Aligned Reliability-Aware Credit Assignment — তথ্যের সাথে সামঞ্জস্যপূর্ণ এবং তার নির্ভরযোগ্যতা বিবেচনাকারী ক্রেডিট অ্যাসাইনমেন্ট। এটি কোনো নতুন মডেল বা ডেটাসেট নয়, বরং একটি পলিসি অপটিমাইজেশন ফ্রেমওয়ার্ক: এটি তথ্যগত নিয়ন্ত্রণ কীভাবে প্রশিক্ষণ সংকেতে রূপান্তরিত হয়, তা পুনর্গঠন করে।
গ্রানুলারিটি সামঞ্জস্য করা
প্রথম ধাপ — সূক্ষ্ম-দানাদার ক্রেডিট স্থানীয়করণ। ধারণাটি বলতে সহজ কিন্তু বাস্তবায়নে জটিল: তথ্য যাচাইয়ের গ্রানুলারিটিকে পলিসি হালনাগাদের গ্রানুলারিটির সাথে সামঞ্জস্যপূর্ণ করতে হবে। তখন তথ্যগত সংকেত "পুরো উত্তরের গড় হিসেবে" না এসে সেই নির্দিষ্ট টোকেনের সাথে যুক্ত হয়, যেগুলো সত্যিই ওই দাবির জন্য দায়ী। অস্পষ্ট গড় করার বদলে পলিসি সুনির্দিষ্ট নির্দেশনা পায়।
যাচাইয়ের উপর কতটা বিশ্বাস করা যায় তা মূল্যায়ন করা
দ্বিতীয় ধাপ — নির্ভরযোগ্যতার ওজন। এগুলো গণনার জন্য লেখকরা প্রবর্তন করেন কনট্রাফ্যাকচুয়াল এভিডেন্স অ্যাট্রিবিউশন (counterfactual evidence attribution): তারা দেখেন, একটি তথ্যগত রায় মূল সাক্ষ্য-অংশের উপর কতটা নির্ভরশীল। যদি এই সাক্ষ্য সরিয়ে ফেলা বা বদলে দেওয়া হয় এবং রায় বদলে যায় — তাহলে যাচাইটি সত্যিই তার উপর নির্ভর করছে, এবং এমন সংকেত বেশি আস্থার যোগ্য। যদি সাক্ষ্য নির্বিশেষে রায় আগের মতোই থাকে, তাহলে রায়টি সম্ভবত আমরা যা ভাবছি তা নিয়ে নয় — এবং তার ওজন কমে যায়।
প্রাপ্ত ওজনগুলো এরপর তথ্যগত পুরস্কার এবং পলিসির স্থানীয় সুবিধাগুলোকে মডুলেট করে। ব্যবহারিক অর্থ: সম্ভাব্য অবিশ্বাসযোগ্য সংকেত হালনাগাদের সময় কম ভোট পায়, তবে সম্পূর্ণভাবে ব্লক হয় না। এটি কঠোর বাদ দেওয়ার বদলে নরম ফিল্টারিং — পলিসি তথ্য হারায় না, কিন্তু অন্ধভাবে তা অনুসরণ করা বন্ধ করে।
পরীক্ষাগুলো যা দেখায়
লেখকরা বিভিন্ন মডেল এবং তথ্যগত যুক্তি মূল্যায়নকারী কয়েকটি বেঞ্চমার্কে পদ্ধতিটি পরীক্ষা করেছেন। দাবিকৃত ফলাফল — সাধারণ যুক্তি-সামর্থ্য বজায় রেখে তথ্যগত নির্ভুলতার লক্ষণীয় বৃদ্ধি। এখানে শেষ অংশটি প্রথমটির চেয়ে কম গুরুত্বপূর্ণ নয়: তথ্যগত উন্নতি প্রায়ই অন্য দক্ষতার অবনতির বিনিময়ে কেনা হয়, যখন মডেল একইসাথে সতর্ক ও দুর্বল হয়ে পড়ে। লেখকদের তথ্যমতে, এখানে তা ঘটে না।
আলাদাভাবে উল্লেখ্য, পদ্ধতিটি যাচাইযোগ্য পুরস্কার-ভিত্তিক RL প্যারাডাইমেই থাকে — এটি বিদ্যমান পাইপলাইন ত্যাগ করার দাবি করে না এবং তা মৌলিকভাবে ভিন্ন কিছু দিয়ে প্রতিস্থাপনও করে না। এটি তথ্য যাচাই এবং পলিসি হালনাগাদের মধ্যে একটি স্তর হিসেবে সংযুক্ত হয়।
এ থেকে যা অনুসরণ করে
গবেষণাপত্রের মূল ভাবনা একটি স্থাপত্যের চেয়ে বিস্তৃত। মডেলের তথ্যগত নির্ভুলতা নিয়ে আলোচনা সাধারণত "যাচাই করা হবে কি হবে না" এই যুক্তিতে চলে। কিন্তু যখন যাচাই ইতিমধ্যেই আছে, তখন মূল প্রশ্ন সরে যায়: তাদের ফলাফল ঠিক কীভাবে প্রশিক্ষণে রূপান্তরিত হয়। এই সংযোগস্থলের ভুল দেখতে ভুলের মতো লাগে না, এটি সাধারণ প্রশিক্ষণ-শব্দের মতো দেখায় — আর তাই সহজেই অলক্ষিত থেকে যায়।
উৎসগুলোকে সমানভাবে বিশ্বাস করা হয় না — এই স্বীকৃতি সাধারণ বোধের স্তরে প্রায় তুচ্ছ মনে হয়। কিন্তু রিইনফোর্সমেন্ট লার্নিংয়ের স্কিমগুলোতে এটি এখনও বিরল: সংকেতগুলো একটি সাধারণ কড়াইতে জমা হয়, আর নির্ভরযোগ্য সাক্ষ্য ও এলোমেলো আন্দাজের মধ্যে পার্থক্য মুছে যায়। FARCA হলো এই পার্থক্যটিকে সূত্রে ফিরিয়ে আনার একটি প্রচেষ্টা। যাচাইযোগ্য উত্তরের কাজের বাইরে, যেখানে তথ্যকে এত সহজে নিশ্চিত বা খণ্ডন করা যায় না, সেখানে পদ্ধতিটি কতটা স্থানান্তরযোগ্য হবে — সেটি একটি খোলা প্রশ্ন, এবং সেটিই পরবর্তী কাজের সবচেয়ে আকর্ষণীয় দিক।