
DiSCO: টেক্সট-টু-ইমেজ সুরক্ষা ক্ষতিকারক কন্টেন্ট থেকে, মডেলের অভ্যন্তরীণ অংশে অ্যাক্সেস ছাড়াই
নতুন DiSCO পদ্ধতিটি একটি বাহ্যিক মডিউলের মতো কাজ করে: এটি নিরাপদ প্রম্পট নির্বাচন করে এবং অরক্ষিত মডেলগুলির জন্য সফল red-team আক্রমণের হার ৩৭.৭% এবং ইতিমধ্যে সুরক্ষিত সিস্টেমগুলির জন্য ২৫.১৩% কমিয়ে দেয়। পাশাপাশি, শব্দার্থিক নির্ভুলতা বজায় থাকে এবং চিত্রের সংগতি আরও উন্নত হয়।
সাধারণ প্রম্পটে লুকানো হুমকি
আধুনিক নিউরাল নেটওয়ার্ক, যা টেক্সট বর্ণনা থেকে ছবি তৈরি করে, চিত্তাকর্ষক ছবি তৈরি করতে সক্ষম, কিন্তু কখনও কখনও অবাঞ্ছিত কন্টেন্ট "বের করে দেয়"। সাধারণত এই ধরনের সিস্টেমের সুরক্ষা তাদের অভ্যন্তরীণ কাঠামোতে হস্তক্ষেপের উপর ভিত্তি করে তৈরি হয়: টেক্সট এনকোডার পুনঃপ্রশিক্ষণ, ওজন সংশোধন বা ইনফারেন্স পর্যায়ে বিশেষ প্রক্রিয়াকরণ। এই পদ্ধতিটি কার্যকর যতক্ষণ আপনার মডেলটিতে অ্যাক্সেস থাকে, তবে এটি "ব্ল্যাক বক্স" নীতি অনুসারে কাজ করা বন্ধ প্রোপ্রাইটারি সার্ভিসগুলির জন্য সম্পূর্ণ অনুপযুক্ত।
বিকল্প হিসেবে, বড় ভাষার মডেলগুলিকে স্বয়ংক্রিয়ভাবে অনুরোধগুলিকে নিরাপদ আকারে পুনর্লিখনের জন্য ব্যবহার করার চেষ্টা করা হয়। কিন্তু এখানেও একটি দুর্বল দিক রয়েছে: প্রম্পটটি ভাষাগতভাবে সম্পূর্ণ নিরীহ হয়ে ওঠে, তবে প্রশিক্ষণের সময় মডেলটি কীভাবে ডেটা বিতরণ করেছে তার কারণে, জেনারেশন তবুও ক্ষতিকারক এলাকায় চলে যায়। লেখকরা এই মোডটিকে "বেনাইন অ্যাডভারসারিয়াল" বলে অভিহিত করেছেন — যখন টেক্সট আনুষ্ঠানিকভাবে নিরাপদ, কিন্তু ফলাফল তা নয়।
DiSCO কী প্রস্তাব করে
DiSCO (Distribution-guided contrastive prompt optimization) পদ্ধতি, যা গবেষকদের একটি গ্রুপ দ্বারা তৈরি, সম্পূর্ণ ভিন্ন পথ প্রস্তাব করে: মডেলের ভিতরে না দেখে প্রম্পট স্তরে জেনারেশন সুরক্ষিত করা। এটি একটি কঠোরভাবে ব্ল্যাক-বক্স সমাধান, যা একটি বাহ্যিক প্লাগ-অ্যান্ড-প্লে মডিউল হিসেবে কাজ করে। এটির জন্য অতিরিক্ত প্রশিক্ষণ, পুনঃপ্রশিক্ষণ বা লক্ষ্য সিস্টেমের প্যারামিটার এবং আর্কিটেকচার সম্পর্কে কোনো তথ্যের প্রয়োজন নেই।
ধারণাটি হল স্বয়ংক্রিয়ভাবে সাফিক্স — অর্থাৎ প্রম্পটের শেষ অংশ — এমনভাবে পরিবর্তন করা যাতে জেনারেশনকে নিরাপদ পথে পরিচালিত করা যায়। উপযুক্ত সাফিক্স খোঁজা বিম সার্চের মাধ্যমে করা হয়, এবং প্রার্থীদের গুণমান কনট্রাস্টিভ স্কোরিং দিয়ে মূল্যায়ন করা হয়। এর জন্য মডিউলটি আগে থেকেই লক্ষ্য মডেল ব্যবহার করে দুটি ছবির পুল তৈরি করে: নিরাপদ এবং অনিরাপদ। জেনারেশনের ফলাফল রেফারেন্স পুলের সাথে তুলনা করে, DiSCO বুঝতে পারে কোন দিকে সাফিক্স "চাপতে" হবে।
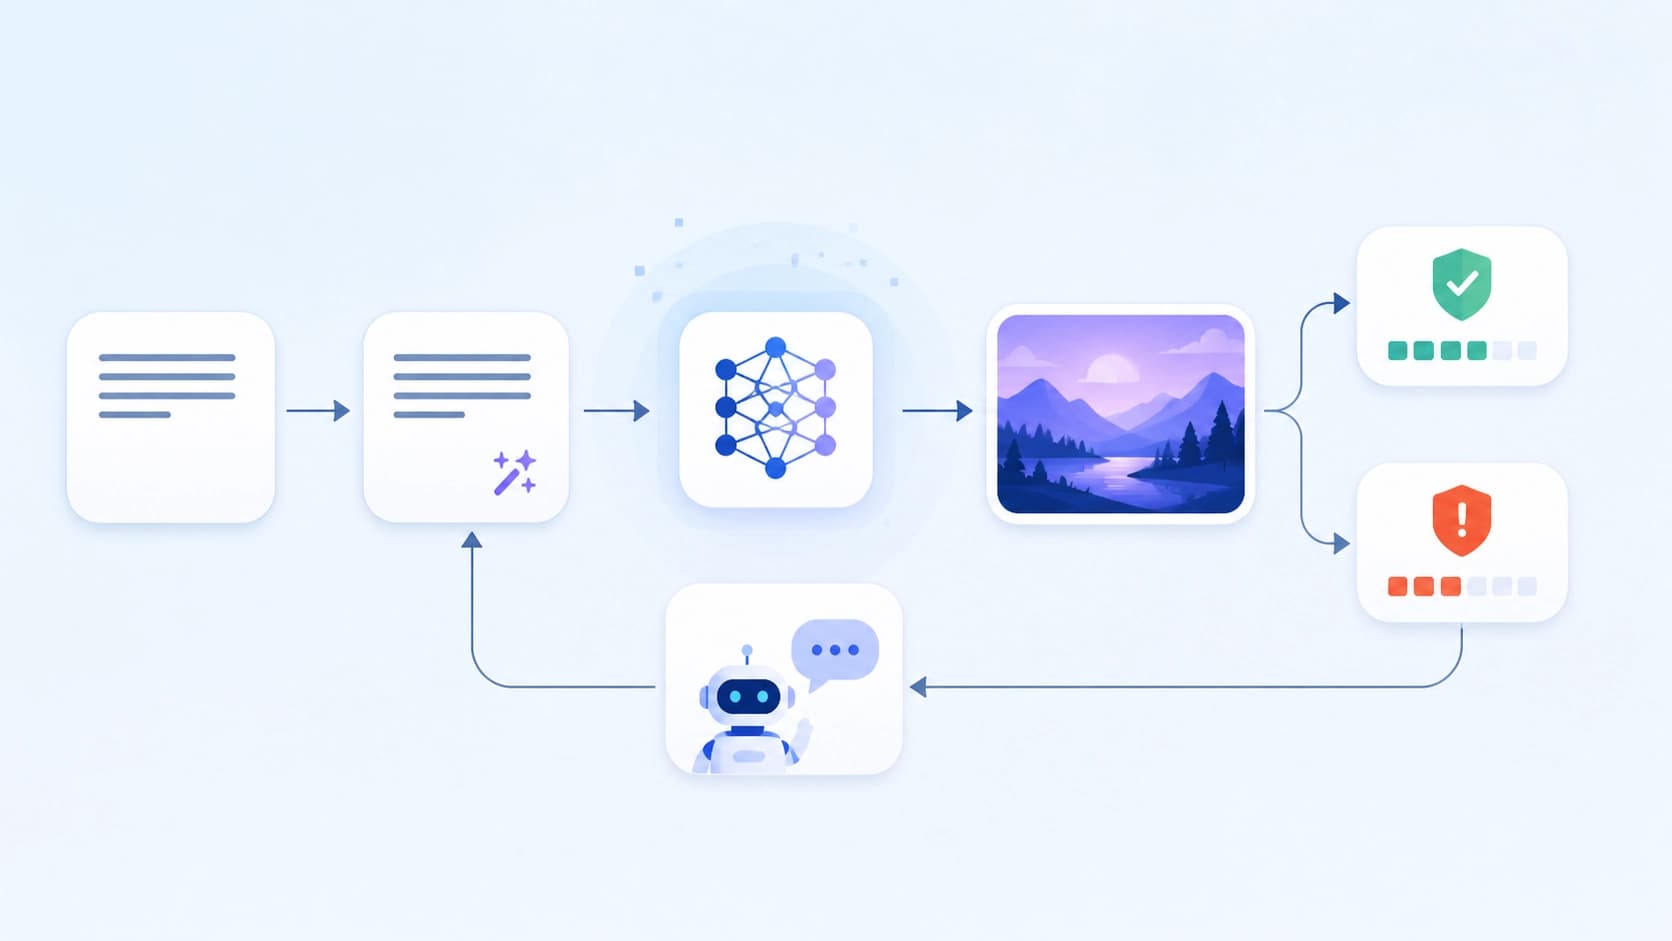
প্রক্রিয়াটি পুনরাবৃত্তিমূলক: প্রতিটি ধাপের পর মডিউলটি প্রাপ্ত ছবিটি মূল্যায়ন করে এবং যদি এতে এখনও অবাঞ্ছিত উপাদান থাকে, তবে সাফিক্সটি আবার সামঞ্জস্য করে। এটি চলতে থাকে যতক্ষণ না জেনারেশন নিরাপদ পুলের সাথে সামঞ্জস্যপূর্ণ হয়। এই সময়ে কোনো ধাপেই মডেলের অভ্যন্তরীণ অংশ প্রকাশের প্রয়োজন হয় না — সমস্ত মিথস্ক্রিয়া শুধুমাত্র প্রম্পট পাঠানো এবং ছবি পাওয়ার মাধ্যমে হয়।
এটি কতটা কার্যকর
গবেষকরা I2P (Inappropriate Image Prompts) বেঞ্চমার্কে একাধিক রেড-টিমিং আক্রমণের পরিস্থিতিতে DiSCO পরীক্ষা করেছেন। ফলাফল দেখায় যে সফল আক্রমণের হার কোনো সুরক্ষা ছাড়া মডেলগুলির জন্য ৩৭.৭% এবং অন্যান্য পদ্ধতি দ্বারা ইতিমধ্যে সুরক্ষিত মডেলগুলির জন্য ২৫.১৩% কমে যায়। এর অর্থ হল DiSCO শুধু যেখানে সুরক্ষা নেই সেখানে ফাঁক বন্ধ করে না, বরং বিদ্যমান বাধাগুলিকেও শক্তিশালী করে।
উল্লেখযোগ্য বিষয় হল, এতে শব্দার্থিক নির্ভুলতা ক্ষতিগ্রস্ত হয় না: উৎপন্ন ছবিগুলি মূল প্রম্পটের সাথে প্রাসঙ্গিক থাকে এবং সংগতি এমনকি উন্নত হয়। অন্য কথায়, মডিউলটি জেনারেশনের গুণমান নষ্ট করে না, বরং এটিকে সম্ভাব্য বিপজ্জনক ব্যাখ্যা থেকে দূরে সরিয়ে দেয়।
যেহেতু DiSCO আর্কিটেকচার-অ্যাগনস্টিক, এটি মডেলটি পরিবর্তন না করেই যেকোনো টেক্সট-টু-ইমেজ সিস্টেমের সাথে সংযুক্ত করা যেতে পারে। এটি বিশেষ করে বন্ধ বাণিজ্যিক API-গুলির জন্য মূল্যবান, যেখানে অ্যাক্সেস সীমিত, এবং ব্যবহারকারীদের জন্য যারা অন্যের পরিষেবার সুরক্ষা বাড়াতে চান — উদাহরণস্বরূপ, পাবলিক অ্যাপ্লিকেশনে ব্যবহারের আগে।
চিত্তাকর্ষক ফলাফল সত্ত্বেও, মনে রাখা উচিত যে পদ্ধতিটি "রূপালী বুলেট" নয়, বরং সুরক্ষার একটি স্তর। ঝুঁকি সম্পূর্ণভাবে দূর করা সম্ভব হবে না, তবে "অভ্যন্তরীণ" সুরক্ষা থেকে "বাহ্যিক" এবং অভিযোজিত পদ্ধতিতে স্থানান্তর — ক্ষতিকারক অনুরোধের বিরুদ্ধে জেনারেটিভ সিস্টেমের স্থিতিস্থাপকতার দিকে একটি গুরুত্বপূর্ণ পদক্ষেপ।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
AURA-Eval: কীভাবে যাচাই করবেন যে LLM এজেন্ট ঝুঁকি শনাক্ত করেছে এবং পরবর্তী পদক্ষেপ পরিবর্তন করেছে
এই ফ্রেমওয়ার্ক LLM এজেন্টদের আচরণকে চূড়ান্ত রায় দিয়ে নয়, বরং গুরুত্বপূর্ণ মুহূর্তে ঝুঁকির প্রতিক্রিয়া দিয়ে মূল্যায়ন করে: টুল কলের ধারা মাঝপথে থামিয়ে দেওয়া হয়, এরপর মডেলকে তার যুক্তি ও কাজ চালিয়ে যেতে হয়; আর LLM বিচারকদের একটি প্যানেল ঝুঁকি শনাক্তকরণ, পদক্ষেপের ধরন ও নিরাপত্তা বিশ্লেষণ করে। R-Judge-এর 157টি ট্র্যাজেক্টরি থেকে সংগৃহীত 1249টি কাজে, 20টি মডেলের নিরাপদ পথ না থাকলে অনিরাপদ পদক্ষেপ নেওয়ার প্রবণতা বেড়ে যায়; আর কাজ সম্পন্ন হওয়ার আগে তদারকি তুলে নিলে শুরুতে নিরাপদ থাকা ঘটনাগুলোর 52,3% অনিরাপদ হয়ে ওঠে।
10 নভেম্বর 2026
চের্ন–সাইমনস রিজার্ভারের স্মৃতি: সংযোগের স্বায়ত্তশাসিত গতিবিদ্যা এবং ঘনত্ব পরিবহন
এই নিবন্ধে আলোচনা করা হয়েছে, কীভাবে একটি রিজার্ভয়ার ইনপুট সিগন্যালের ইতিহাস একই সঙ্গে ঘনত্বের বণ্টন এবং জ্যামিতিক স্বাধীনতার মাত্রায় সংরক্ষণ করে। চারটি প্রক্রিয়ার তুলনা দেখায় যে কারেন্ট একটি স্বতন্ত্র সংযুক্তি উপাদান তৈরি করে, যা ঘনত্বের পরবর্তী প্রতিক্রিয়া পরিবর্তন করে; আর পরিমাপ করা সব বৈশিষ্ট্য বিবেচনায় নিলে ইমপালসের ক্রম ডিকোড করার ক্ষেত্রে সামান্য উন্নতি হয়।
10 নভেম্বর 2026
STAR: এন্ড-টু-এন্ড ইনসিডেন্ট ব্যবস্থাপনার জন্য সময়গত প্রেক্ষাপট ও সার্ভিস গ্রাফের অভিযোজিত স্বাভাবিকীকরণ
STAR ফ্রেমওয়ার্কটি মেট্রিক, লগ ও ট্রেস থেকে উপস্থাপনা শেখায়, যেখানে বহুমাত্রিক সময়গত গতিশীলতা এবং পরিষেবাগুলোর মধ্যে নির্ভরতার কাঠামো বিবেচনায় নিয়ে শেখনযোগ্য নরমালাইজেশন প্রয়োগ করা হয়। দুটি বাস্তব ডেটাসেটে, এই পদ্ধতি আধুনিক বেসলাইন পদ্ধতিগুলোর তুলনায় অ্যানোমালি শনাক্তকরণ, ব্যর্থতার অগ্রাধিকার নির্ধারণ এবং মূল কারণ অনুসন্ধানের মান ধারাবাহিকভাবে উন্নত করে।
10 নভেম্বর 2026