সিমুলেশন কী যাচাই করে
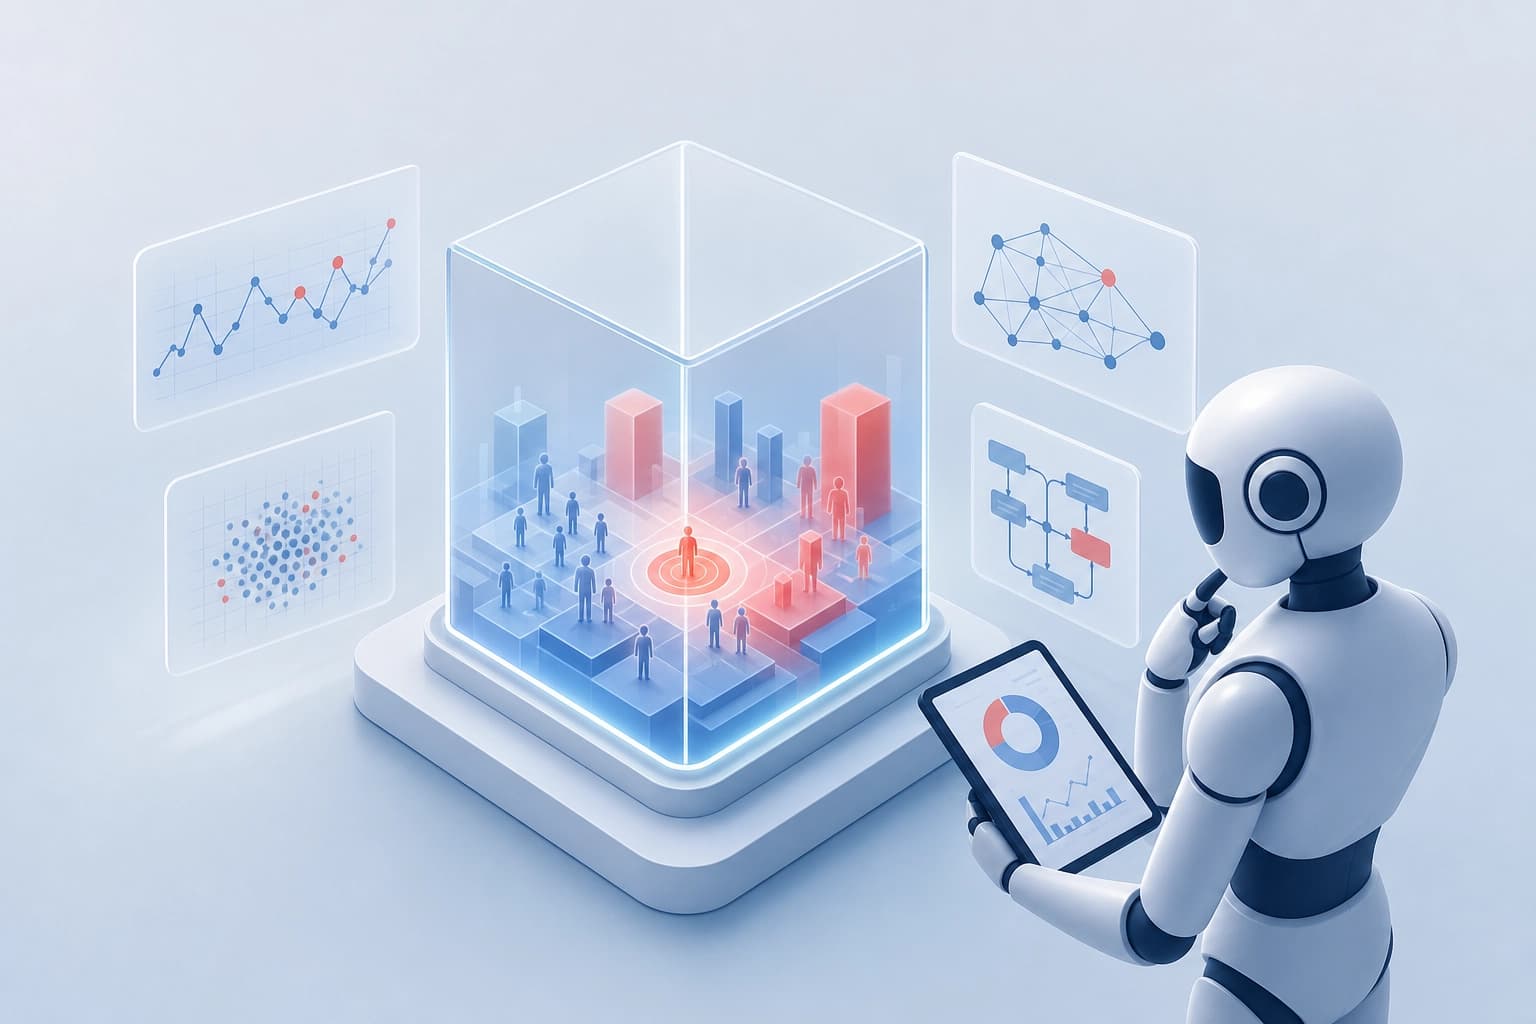
TRACE হলো ডিজিটাল বিজ্ঞাপনের জন্য একটি ডায়াগনস্টিক পরিবেশ। এটি ১২টি মূল কারণ এবং সেগমেন্টের বিস্তারিত অ্যাট্রিবিউশন নিয়ে কাজ করে। প্রতিটি পর্বে এজেন্ট Python ও SQL ব্যবহার করে ডেটা পরীক্ষা করে। এরপর এটি মূল কারণ এবং প্রযোজ্য ক্ষেত্রে, প্রভাবিত সেগমেন্ট শনাক্ত করে।
TRACE-এর বিবরণ Rui Sun, Zhan Shi এবং Bing He-এর একটি গবেষণাপত্রে দেওয়া হয়েছে, যা ৯ সেপ্টেম্বর ২০২৬ তারিখে arXiv-এ জমা দেওয়া হয়। গবেষণাপত্রটির শনাক্তকারী arXiv:2609.10315।
যেভাবে মূল্যায়ন তৈরি করা হয়
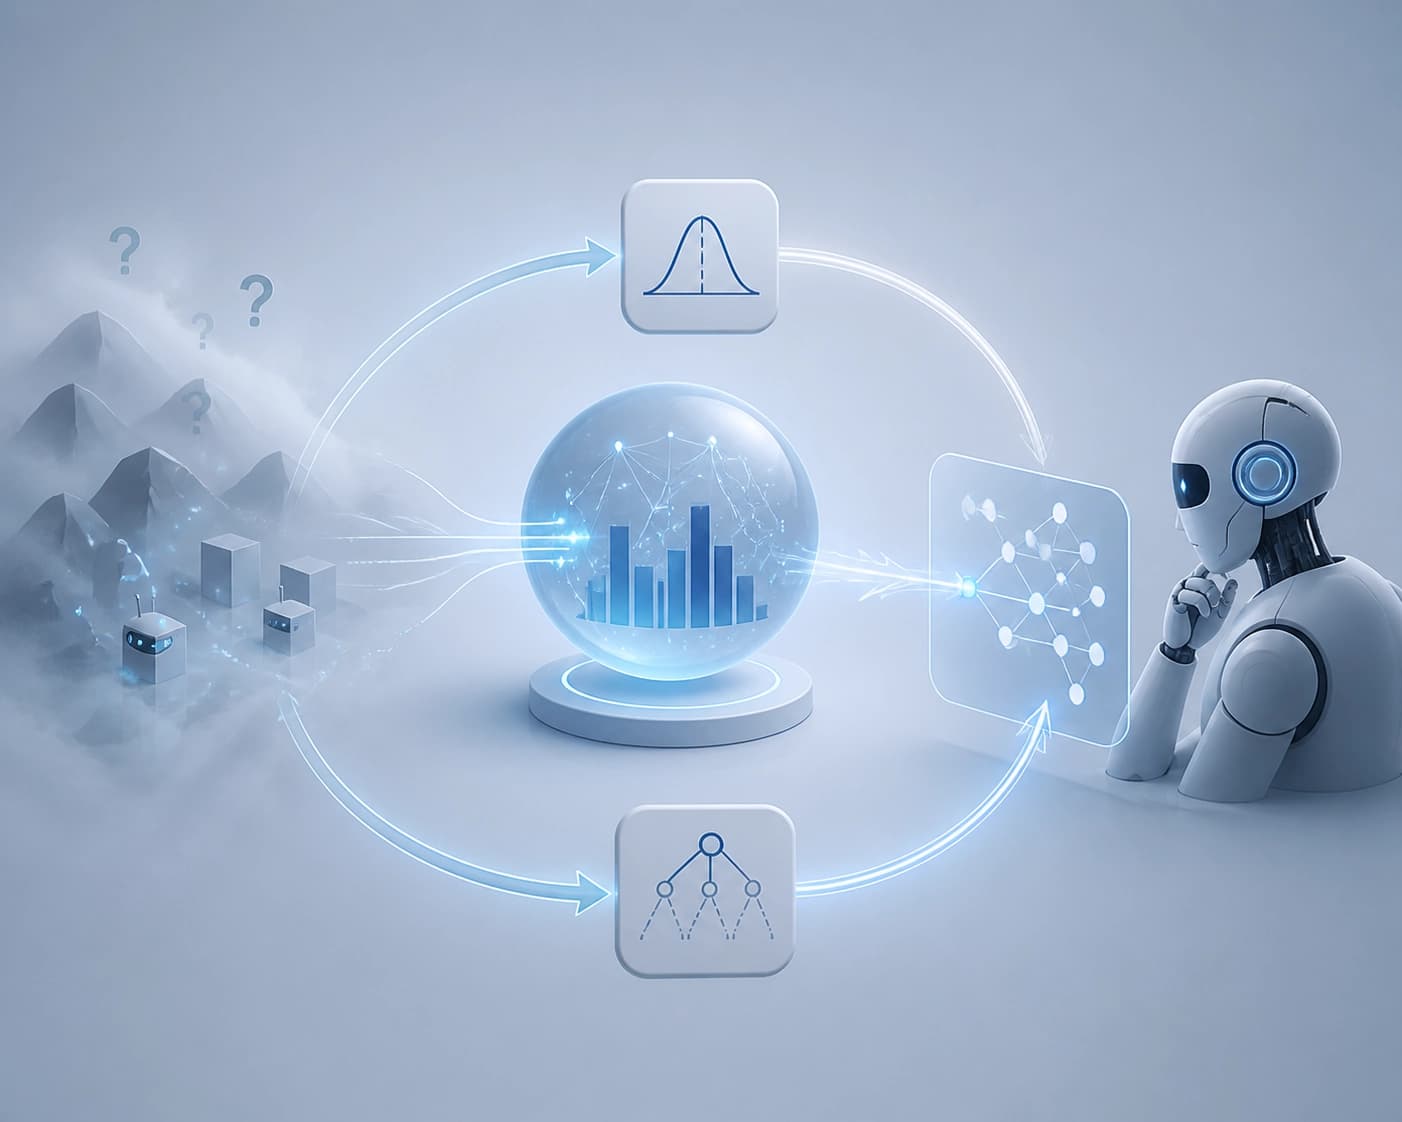
মূল্যায়নটি একটি হস্তক্ষেপ এবং তার ফলে সৃষ্ট পর্যবেক্ষণকে কেন্দ্র করে তৈরি হয়:
- একটি হস্তক্ষেপ বেছে নিয়ে নিয়ন্ত্রিত সিমুলেটরে প্রয়োগ করা হয়।
- সিমুলেটর সংশ্লিষ্ট পর্যবেক্ষণ তৈরি করে।
- এজেন্ট ডেটা পরীক্ষা করে এবং ব্যর্থতার কারণ খোঁজে।
- লুকানো হস্তক্ষেপটি রেফারেন্স লেবেল হিসেবে কাজ করে এবং বস্তুনিষ্ঠ পুরস্কার গণনা করতে সাহায্য করে।
এজেন্টকে তৈরি করা ব্যাখ্যা দেওয়া হয় না। তাকে কোলাহলপূর্ণ, মিশ্র এবং ডেটাজুড়ে ছড়িয়ে থাকা প্রমাণের মধ্যে যোগসূত্র খুঁজে বের করতে হয়। এভাবে সিমুলেশনটি আগে থেকে নির্ধারিত উত্তর শনাক্ত করার বদলে কারণগত অনুমান যাচাই করে।
ফলাফল কীভাবে পড়বেন
লেখকেরা ২৩৫টি পর্বের একটি সংরক্ষিত টেস্ট সেটে মডেলগুলোর মূল্যায়ন করেছেন। সবচেয়ে শক্তিশালী prompting baseline, Claude Opus 5, 0.686 FullAttr@1 ফল পেয়েছে।
| মডেল বা ধাপ | ফলাফল |
|---|---|
| supervised fine-tuning-এর পর Qwen3.5-35B-A3B | 0.159 → 0.637 |
| সংশ্লেষিত পুরস্কার দিয়ে RL-এর পর একই মডেল | 0.757 |
| prompting baseline-এ Qwen3.5-122B-A10B | 0.757-এর চেয়ে কম |
0.757 ফলটি বন্ধ-সোর্স frontier মডেলসহ মূল্যায়ন করা সব prompting baseline-কে ছাড়িয়ে গেছে। লেখকেরা আরও জানিয়েছেন, তৈরি হওয়া policy-টি 35B-র বেস মডেলের prompting সংস্করণের তুলনায় উল্লেখযোগ্যভাবে কমবার টুল ব্যবহার করেছে।
এজেন্ট প্রশিক্ষণের ক্ষেত্রে ফলাফল কী দেখায়
লেখকদের মতে, প্রশিক্ষণের জন্য স্কেল করা যায় এমন বস্তুনিষ্ঠ সংকেতে প্রবেশাধিকার মডেলের আকারের চেয়েও গুরুত্বপূর্ণ সীমাবদ্ধতা হতে পারে। এটি বর্ণিত কাজের ফলাফলের ভিত্তিতে করা একটি সিদ্ধান্ত, সব ধরনের AI সিস্টেমের জন্য কোনো সর্বজনীন নিয়ম নয়।
সিমুলেশনভিত্তিক মূল্যায়নের মাধ্যমে দ্ব্যর্থক ডায়াগনস্টিক যুক্তির কাজগুলোকে স্কেলযোগ্য রিইনফোর্সমেন্ট লার্নিংয়ের উপযোগী করা যেতে পারে। এর মূল শর্ত হলো, এজেন্টের সিদ্ধান্তকে লুকানো হস্তক্ষেপের সঙ্গে মেলানো এবং একটি বস্তুনিষ্ঠ পুরস্কার গণনা করা সম্ভব হতে হবে।
এই পদ্ধতি কখন উপযুক্ত
সমস্যার বিন্যাসে যদি নিচের বিষয়গুলো সম্ভব হয়, তাহলে কারণগত অনুমান যাচাইয়ের জন্য সিমুলেশন উপযুক্ত:
- একটি হস্তক্ষেপ নির্ধারণ করে নিয়ন্ত্রিত পরিবেশে প্রয়োগ করা;
- এর সঙ্গে সম্পর্কিত পর্যবেক্ষণ তৈরি করা;
- হস্তক্ষেপটিকে লুকানো রেফারেন্স লেবেল হিসেবে সংরক্ষণ করা;
- প্রযোজ্য ক্ষেত্রে, মূল কারণ এবং প্রভাবিত সেগমেন্ট—দুটিই মূল্যায়ন করা।
সমস্যাটিতে যদি এভাবে রেফারেন্স লেবেলের সঙ্গে মিলিয়ে দেখা সম্ভব না হয়, তাহলে বর্ণিত বস্তুনিষ্ঠ পুরস্কারের ব্যবস্থা নিশ্চিত করা যায় না। নির্বাচন করার ব্যবহারিক মানদণ্ড হলো—বিশ্লেষণের সময় লুকানো কারণটি প্রকাশ না করেই এজেন্টের সিদ্ধান্ত যাচাই করা যায় কি না।