
RLTLDR: এজেন্ট নিজেই ব্যর্থতা থেকে শিক্ষা নিয়ে পরবর্তী প্রচেষ্টায় তা কাজে লাগায়
ব্যর্থতার পর এজেন্টকে যাচাইকারীর সংকেত দেখানো হয় এবং সেটিকে একটি ইঙ্গিতে সংক্ষেপ করতে বলা হয়; প্রশিক্ষণ চলে «কাজ — ইঙ্গিত» জোড়ার ওপর, কোনো শিক্ষক বা আদর্শ সমাধান ছাড়াই। কঠিন কোডিং ও টুল-কলিং বেঞ্চমার্কে এই পদ্ধতি GRPO-র Pass@1-কে ০–১% থেকে বাড়িয়ে ১২–৩১% করে, আর এই জোড়াটি শেখাই যে এখানে নির্ণায়ক অবদান রাখে।
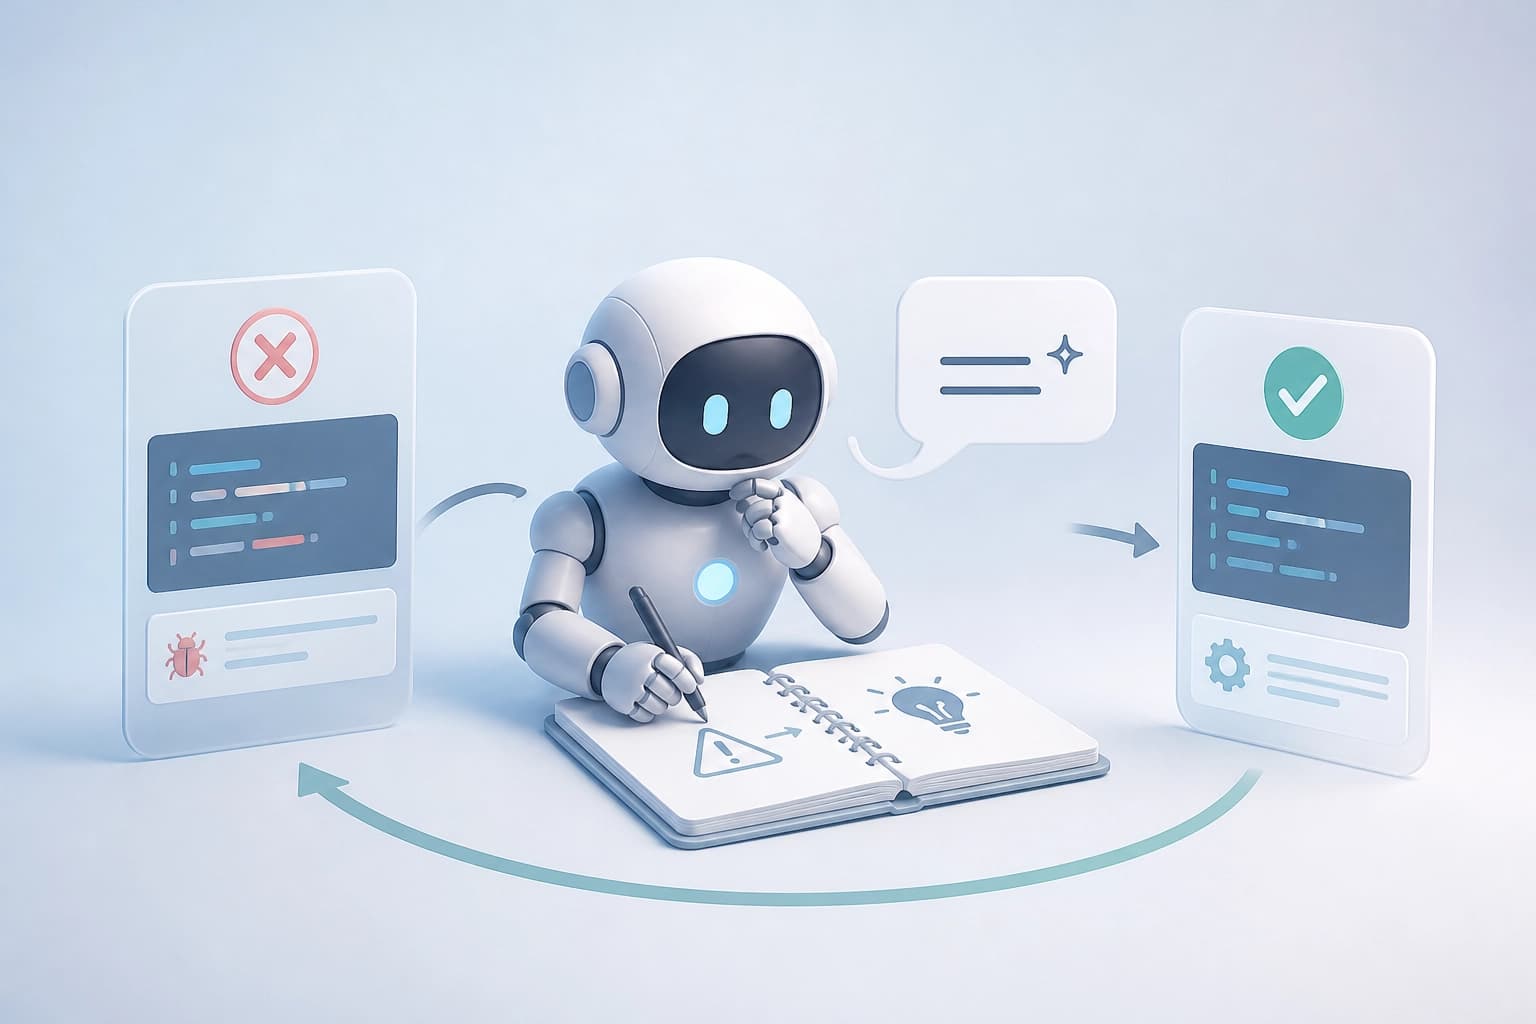
RLTLDR — যেসব কাজে সাফল্য অর্জন করা কঠিন, সেগুলোতে এজেন্টের স্ব-উন্নতির একটি পদ্ধতি। ব্যর্থ চেষ্টার পর এজেন্ট যাচাইকারীর আউটপুট দেখে নিজেই একটি সংক্ষিপ্ত উপসংহার তৈরি করে — TL;DR insight। পরের চেষ্টায় আগের সব উপসংহার বিবেচনায় নেওয়া হয়। Michael Kirchhof, Eleonora Gualdoni, Andrew Szot এবং তাঁদের সহলেখকদের কাজটিতে এই পদ্ধতির বিবরণ রয়েছে। প্রথম সংস্করণ জমা দেওয়া হয় 29 সেপ্টেম্বর 2026-এ। সর্বশেষ সম্পাদনা 19 অক্টোবর 2026-এ।
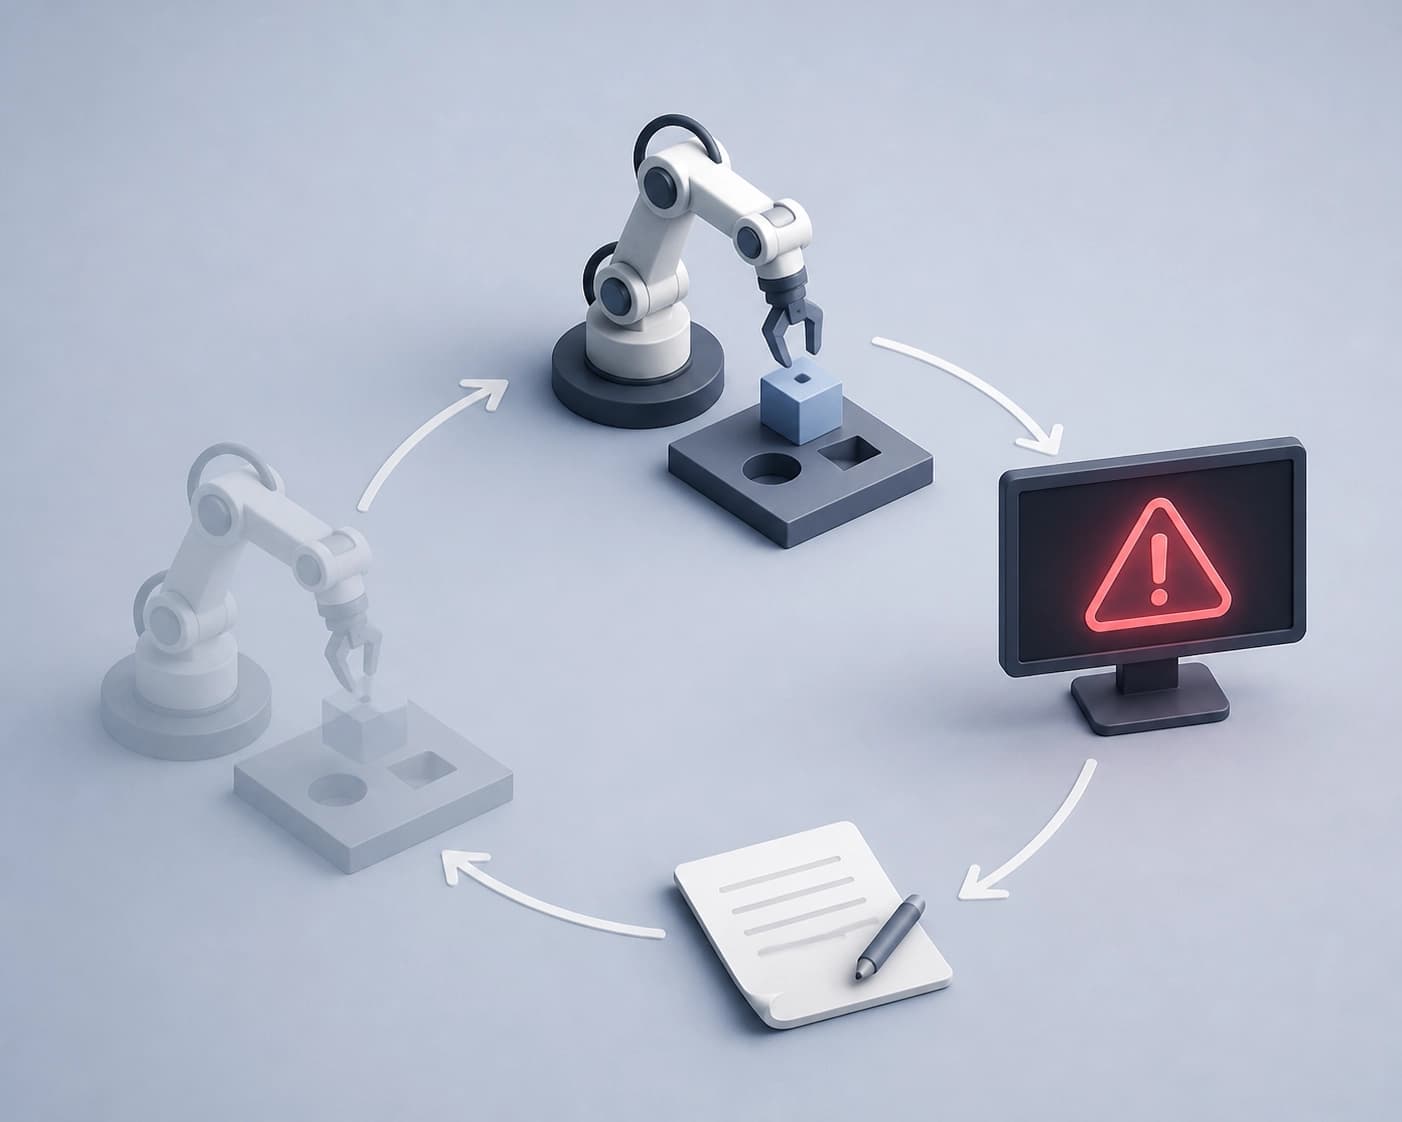
RLTLDR যে সমস্যার সমাধান করে
RLTLDR এজেন্টের স্ব-উন্নতির লক্ষ্যে তৈরি। এ ধরনের কাজে এজেন্টের পক্ষে সফল হওয়া কঠিন। ডিস্টিলেশনের জন্য শিক্ষক মডেল বা সমাধানের উদাহরণ নেই। তাই ব্যর্থতা ও যাচাইকারীর আউটপুটই প্রতিক্রিয়ার উৎস হয়ে ওঠে।
কাজের শর্তাবলি:
- শিক্ষক মডেল নেই;
- ডিস্টিলেশনের জন্য সমাধানের উদাহরণ নেই;
- এজেন্টের পক্ষে সফল হওয়া কঠিন;
- ব্যর্থতার পর যাচাইকারীর আউটপুট পাওয়া যায়।
উপসংহার: RLTLDR এমন পরিস্থিতির জন্য দরকার, যেখানে তৈরি সমাধান বা শিক্ষক নেই, কিন্তু যাচাই করা যায় এমন ব্যর্থতা আছে। ব্যবহারিক মানদণ্ড হলো এমন যাচাইকারীর উপস্থিতি, যার আউটপুট এজেন্টকে দেখানো যায়।
চক্রটি যেভাবে কাজ করে
RLTLDR চক্রটি ধারাবাহিক চেষ্টাকে কেন্দ্র করে গড়ে উঠেছে। প্রতিটি ব্যর্থতা পরের ধাপের জন্য উপাদান জোগায়।
ধাপগুলো:
- এজেন্ট একটি রোলআউট সম্পাদন করে এবং ব্যর্থ হয়।
- এজেন্ট যাচাইকারীর আউটপুট দেখে।
- এজেন্ট নিজের প্রতিক্রিয়া তৈরি করে — একটি সংক্ষিপ্ত TL;DR insight।
- পরের রোলআউটে আগের সব উপসংহার বিবেচনায় নেওয়া হয়।
- সমাধান না পাওয়া পর্যন্ত রোলআউটগুলো ধারাবাহিকভাবে চলে।
- প্রসঙ্গের উপসংহারগুলোর ওপর ব্যাকপ্রোপাগেশনসহ প্রশিক্ষণের মাধ্যমে «কাজ → উপসংহার» সম্পর্কটি শেখা হয়।
উপসংহার: চক্রটির মূল্য শুধু পরের চেষ্টার জন্য ইঙ্গিত দেওয়ায় নয়। কাজ ও উপসংহারের মধ্যকার সম্পর্ক শেখাই মূল বিষয়।
কঠিন কাজের ফলাফল
টুল-কলিং ও কোডিংয়ের কঠিন বেঞ্চমার্কে পরীক্ষা চালানো হয়েছিল। Pass@128=0 শর্ত অনুযায়ী লেখকেরা বেঞ্চমার্কগুলো বেছে নিয়েছিলেন। Qwen 3.5 9B Thinking পলিসিতে তুলনা করা হয়েছে।
| পদ্ধতি | মূল্যায়নের শর্ত | Pass@1 |
|---|---|---|
| স্ট্যান্ডার্ড GRPO প্রশিক্ষণ | বর্ণিত উপসংহার-চক্র ছাড়া | 0–1% |
| RLTLDR | প্রশিক্ষণের সময় প্রসঙ্গে উপসংহারসহ | 14–31% |
| RLTLDR | মূল্যায়নের সময় প্রসঙ্গে উপসংহার ছাড়া | 12–13% |
স্ট্যান্ডার্ড GRPO প্রশিক্ষণে Pass@1 0% থেকে 1%-এর মধ্যে থাকে। প্রশিক্ষণের সময় প্রসঙ্গে উপসংহার থাকলে RLTLDR 14–31% অর্জন করে। মূল্যায়নের সময় প্রসঙ্গে উপসংহার না থাকলে ফলাফল 12–13%। লেখকেরা «কাজ → উপসংহার» সম্পর্ক শেখাকে মূল বিষয় হিসেবে চিহ্নিত করেছেন।
উপসংহার: প্রসঙ্গে উপসংহার থাকলে Pass@1 বাড়ে। শেখার বিষয়টি যাচাই করতে পদ্ধতিটিকে উপসংহারসহ এবং উপসংহার ছাড়া—দুইভাবেই মূল্যায়ন করতে হবে।
SFTLDR: «কাজ — উপসংহার» জোড়ায় প্রশিক্ষণ
SFTLDR হলো প্রশিক্ষণের একটি সংক্ষিপ্ত রূপ। এটি শুধু (কাজ, উপসংহার) জোড়া দিয়ে শেখে। এতে রোলআউট বা সেগুলোর ওপর ব্যাকপ্রোপাগেশন ব্যবহার করা হয় না।
SFTLDR সম্পর্কে যা জানা আছে:
- প্রশিক্ষণ শুধু (কাজ, উপসংহার) জোড়া দিয়ে হয়;
- SFTLDR রোলআউট দেখায় না;
- SFTLDR রোলআউটের ওপর ব্যাকপ্রোপাগেশন প্রয়োগ করে না;
- এ ধরনের 4k জোড়া দিয়ে প্রশিক্ষণ দিলে RLTLDR-এর প্রায় সম্পূর্ণ কর্মক্ষমতা ফিরে আসে;
- পূর্ণ রোলআউটে ক্লাসিক্যাল SFT-এর কর্মক্ষমতার প্রায় কাছাকাছি পৌঁছায় SFTLDR;
- লেখকেরা এই পদ্ধতিকে একটি সংক্ষিপ্ত প্রশিক্ষণ-প্যারাডাইম হিসেবে বর্ণনা করেছেন: «এ ধরনের কাজের জন্য এ ধরনের বিষয় মনে রাখো»।
উপসংহার: SFTLDR হলো সংক্ষিপ্ত প্রশিক্ষণের একটি বিকল্প। মানদণ্ড: যেখানে «কাজ — উপসংহার» জোড়া সংগ্রহ করা যায়, সেখানে এটি পরীক্ষা করুন।
প্রযোজ্যতার মানদণ্ড
RLTLDR-এর জন্য যাচাইযোগ্য প্রতিক্রিয়া ও ধারাবাহিক প্রচেষ্টা দরকার। এসব শর্ত না থাকলে চক্রটি তৈরি করা যায় না। নিচের মানদণ্ডগুলো প্রযোজ্যতা মূল্যায়নে সহায়তা করে।
মানদণ্ড:
- কাজে ব্যর্থ চেষ্টা ও পুনরায় রোলআউটের সুযোগ আছে;
- এমন যাচাইকারী আছে, যার আউটপুট এজেন্টকে দেখানো যায়;
- এজেন্ট একটি সংক্ষিপ্ত উপসংহার তৈরি করতে পারে;
- পরের চেষ্টায় আগের সব উপসংহার বিবেচনায় নেওয়া হয়;
- শেখার বিষয়টি যাচাই করা জরুরি হলে, মূল্যায়নে প্রসঙ্গে উপসংহার ছাড়া একটি মোডও অন্তর্ভুক্ত থাকে।
উপসংহার: যেসব কাজে যাচাইকারী আছে এবং সাফল্য অর্জন করা কঠিন, সেগুলোর জন্য RLTLDR বেছে নেওয়া হয়। «কাজ — উপসংহার» জোড়ার ওপর সংক্ষিপ্ত প্রশিক্ষণ দরকার হলে SFTLDR বেছে নেওয়া হয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
তরঙ্গ পূর্বাভাসের সম্ভাব্যতাভিত্তিক সংশোধন: BridgeCast স্ট্রিমিং ম্যাচিংয়ের মাধ্যমে ভৌত মডেলকে রিএনালাইসিসের সঙ্গে সংযুক্ত করে
শর্তাধীন ফ্লো ম্যাচিং, ট্রান্সফরমার আর্কিটেকচার এবং বহির্জাত বায়ুমণ্ডলীয় বৈশিষ্ট্যের সাহায্যে ভৌত তরঙ্গ মডেলের আউটপুটকে পুনর্বিশ্লেষণ-সদৃশ ক্ষেত্রে রূপান্তর করার একটি হাইব্রিড পদ্ধতি উপস্থাপন করা হয়েছে। লেখকেরা জানান, বিভিন্ন পূর্বাভাসের সময়সীমা ও অঞ্চলে এটি আগের সেরা বেসলাইন পদ্ধতিগুলোর তুলনায় ধারাবাহিকভাবে ভালো ফল দেয়।
12 নভেম্বর 2026
OpenCollab: এজেন্টদের প্রোগ্রামযোগ্য সমন্বয়, নিয়ন্ত্রিত রানটাইম পরিবেশ এবং প্রোটোকল মেনে চলার মেট্রিক
ফ্রেমওয়ার্কটি এজেন্টদের পারস্পরিক ক্রিয়াকলাপের কাঠামো নির্ধারণ, পরীক্ষার জন্য একটি অভিন্ন পরিবেশ এবং ইভেন্টের বিস্তারিত ট্রেসিংকে একত্র করে; নতুন প্রবর্তিত Adherence মেট্রিকটি দেখায়, বাস্তব সম্পাদন ঘোষিত কাঠামোর সঙ্গে কতটা সামঞ্জস্যপূর্ণ। বেঞ্চমার্কে Duo কনফিগারেশন নতুন SOTA অর্জন করে, অন্যদিকে একক-এজেন্ট সংস্করণে টোকেন খরচ সবচেয়ে কম।
11 নভেম্বর 2026
Toollery: ফাইন-টিউনিং ছাড়াই কয়েক দশ হাজার বিকল্প থেকে LLM এজেন্টের জন্য টুল নির্বাচন
Toollery দক্ষতা ও টুলের বিবরণের ওপর ভিত্তি করে একটি সার্চ ইনডেক্স তৈরি করে এবং অনুরোধের সময় মডেলকে কেবল সীমিতসংখ্যক সম্ভাব্য প্রার্থী দেয়। কয়েক দশ হাজার ফাংশন পর্যন্ত বিস্তৃত লাইব্রেরিতে চালানো পরীক্ষায় দেখা গেছে, নির্দিষ্ট top-K বজায় রেখেও এই পদ্ধতি বাছাইয়ের মান ধরে রাখতে পারে, যদিও চূড়ান্ত ফল নির্ভর করে ব্যবহারের ধরন এবং প্রোভাইডারের ক্যাশিংয়ের ওপর।
11 নভেম্বর 2026