
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
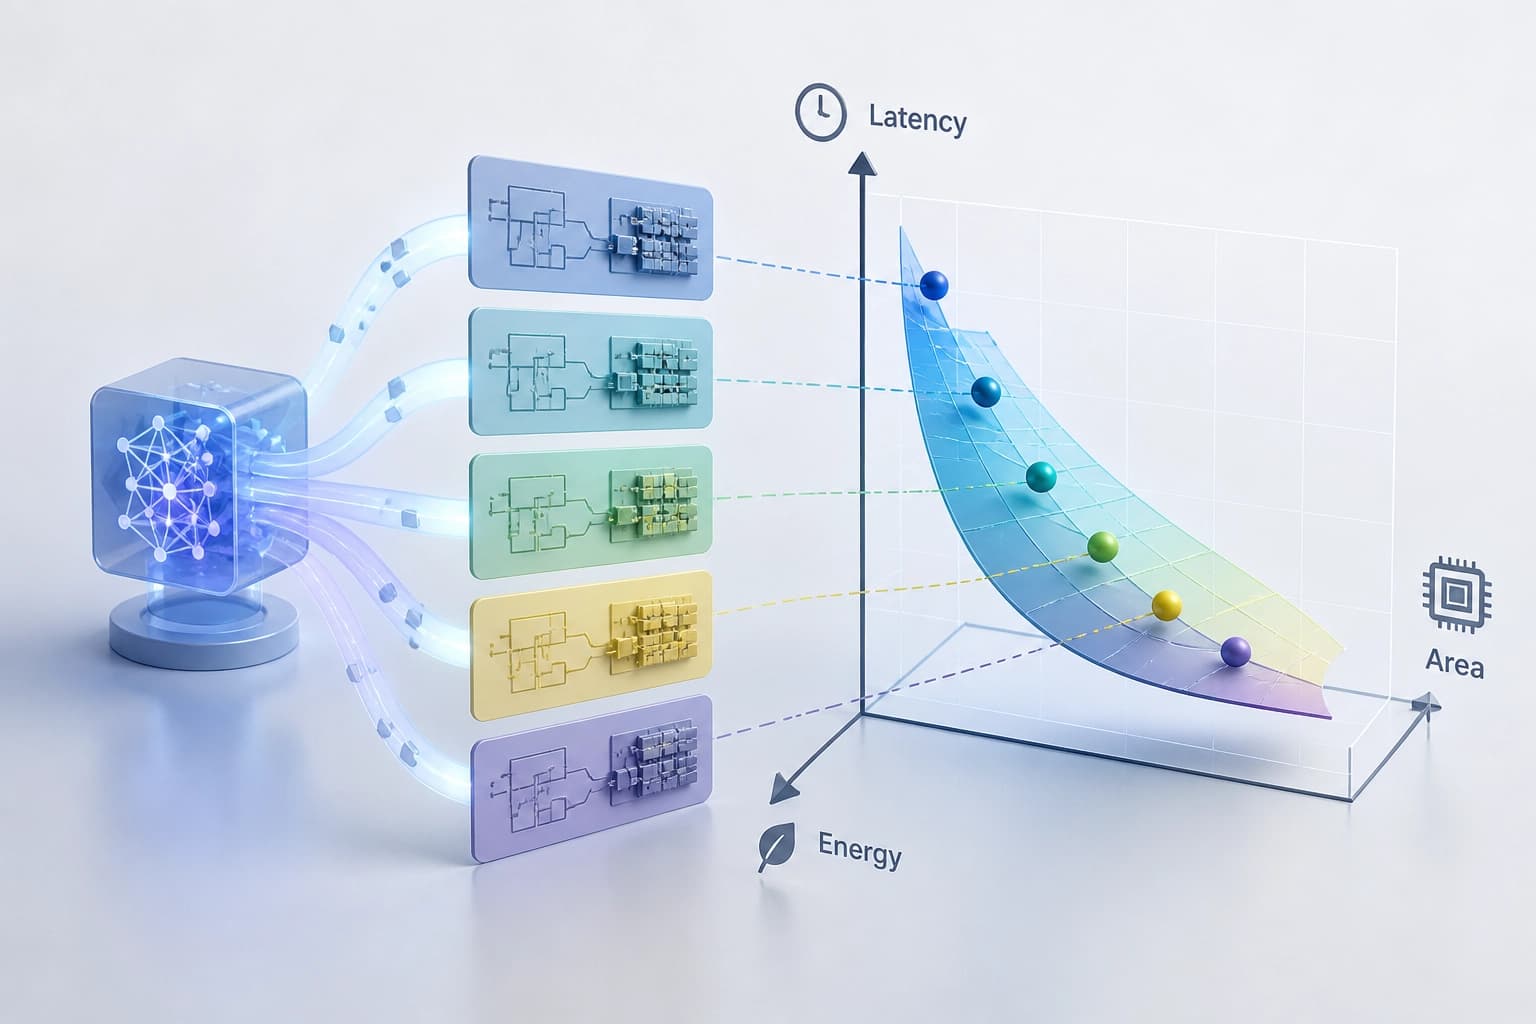
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
العمل والحالة
- العنوان: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- المؤلفون: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- تاريخ التقديم: 16 أكتوبر 2026.
- الحالة: تشير التعليقات إلى قبول العمل في COLM 2026.
المسودة الأولية متاحة على arXiv:2610.26904. يتناول العمل توليد RTL باستخدام نماذج اللغة الكبيرة. يدرّب الأسلوب النموذج على إخراج مجموعة من المرشحين بدلاً من تصميم واحد. وتُقيَّم هذه المجموعة ضمن فضاء PPA.
الخلاصة: قُبل العمل في COLM 2026، ويقترح نهجاً متعدد الأهداف لتوليف RTL باستخدام LLM. ومن المهم عند اختيار النهج التحول في الهدف نفسه، من تصميم واحد إلى مجموعة.
مشكلة المكافأة العددية
تجمع الأساليب الحالية عدة أهداف في مكافأة عددية واحدة. ويصعّب ذلك الحصول على حلول متنوعة ومثلى على جبهة باريتو في الوقت نفسه. كما يصبح من الصعب تحقيق مفاضلات مختلفة بين انخفاض استهلاك الطاقة وقِصر زمن التأخير وصِغر المساحة. وتحدد المكافأة العددية أهمية الأهداف قبل التوليد.
تعتمد الأهمية النسبية للأهداف على متطلبات المنتج وقيود المشروع. أما المكافأة المحددة مسبقاً فلا تتغير تبعاً لهذه المتطلبات. لذا نحتاج إلى مجموعة من المرشحين بمفاضلات مختلفة.
| النهج | ما الذي يحسّنه | متى تُختار المفاضلة |
|---|---|---|
| المكافأة العددية | تصميماً واحداً وفق مجموع الأهداف | قبل التوليد |
| النهج متعدد الأهداف | مجموعة من التصاميم على جبهة باريتو | بعد التوليد |
الخلاصة: تثبّت المكافأة العددية المفاضلة قبل التوليد. أما الصياغة متعددة الأهداف فتنقل الاختيار إلى مرحلة ما بعد التوليد.
ما الذي يحسّنه الأسلوب
يحسّن الأسلوب جودة مجموعة التصاميم بأكملها وتنوعها. وتتكوّن المجموعة عبر عمليات توليد متعددة. ويجري التقييم في فضاء أهداف PPA: الطاقة والأداء والمساحة. ولا يستهدف الأسلوب جودة تصميم واحد.
ترتبط أهداف PPA بمفاضلات. إذ تحقق التصاميم المختلفة توليفات مختلفة من انخفاض استهلاك الطاقة وقِصر زمن التأخير وصِغر المساحة. لذا يدرّب الأسلوب النموذج على تغطية نقاط مختلفة من جبهة باريتو. ويحصل المصمم على عدة مرشحين.
الخلاصة: يستهدف الأسلوب تغطية الجبهة، لا إجابة واحدة هي الأفضل.
عنصران في الأسلوب
خط أنابيب التدريب القائم على عمليات التوليد
يحوّل خط الأنابيب تحسين تغطية مجموعة حلول باريتو بأكملها إلى مهمة متسلسلة لتوليد التصاميم. ويجري التدريب على خطوات، كما تُمنح مهمة التوليد بنية متسلسلة.
المكافأة القائمة على مساهمة الحجم الفائق (Hypervolume Contribution)
تقيس دالة المكافأة HVC مساهمة التصميم المُولَّد في جبهة باريتو. وتعكس المكافأة الزيادة في التغطية، لا الجودة المطلقة لتصميم منفرد. وتربط HVC التدريب بتغطية الجبهة.
الخلاصة: يحدد خط الأنابيب التسلسل، وتوفر HVC إشارة للمساهمة في التغطية.
النتائج على RTLLM v2
أظهر التقييم على معيار RTLLM v2 زيادة في الحجم الفائق النسبي. وبلغت الزيادة +13,3 نقطة مئوية مقارنة بخط الأساس من دون تحسين PPA، و+14,4 نقطة مئوية مقارنة بأسلوب التعلم المعزز أحادي الهدف. كما أفاد المؤلفون بتفوق الأسلوب من حيث تنوع التصاميم.
| المقارنة | الزيادة في الحجم الفائق النسبي |
|---|---|
| خط الأساس من دون تحسين PPA | +13,3 نقطة مئوية |
| أسلوب التعلم المعزز أحادي الهدف | +14,4 نقطة مئوية |
الخلاصة: يحسّن الأسلوب تغطية الجبهة وتنوع التصاميم على RTLLM v2. وتتعلق الأرقام بالحجم الفائق النسبي، لا بالجودة المطلقة لكل تصميم.
المعيار العملي للاختيار
يتحدد اختيار النهج بحسب توقيت تثبيت المفاضلة. وتتطلب المكافأة العددية تحديد أهمية PPA قبل التوليد. أما النهج متعدد الأهداف فينقل الاختيار إلى مرحلة ما بعد التوليد، ويوفر مجموعة من المرشحين بمفاضلات مختلفة.
يقتصر تقييم الأسلوب على معيار RTLLM v2. ويتطلب استخدامه مع تدفق تصميم مختلف إجراء تحقق خاص به. ولا يجوز تعميم أرقام الزيادة على ظروف أخرى من دون تحقق.
الخلاصة: إذا كانت متطلبات PPA تتغير من منتج إلى آخر ومن مشروع إلى آخر، فإن النهج متعدد الأهداف يلائم مهمة الاختيار بعد التوليد. أما إذا كانت أهمية الأهداف معروفة ومحددة مسبقاً، فتناسبها المكافأة العددية، لأنها تتيح مفاضلة محددة مسبقاً.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026
نموذج العالم للوكلاء الذين يستخدمون نماذج لغوية كبيرة مغلقة: التصحيح عند نقاط الخطر
اقتُرحت PAWM بوصفها أداة تنبؤ خارجية لا تكرر المراقبة خطوة بخطوة، بل تتدخل عند احتمال حدوث إخفاق وتُبعد الوكيل عن الإجراء الخاطئ. بعد الضبط الدقيق المُشرف (SFT) على سيناريوهات اصطناعية والتدريب المشترك باستخدام GRPO، حققت الطريقة تحسنًا بنسبة 24.3% في ScienceWorld و7.7% في WebArena-Lite مع Claude Sonnet 4.5.
4 نوفمبر 2026