
Kucing mengejar harimau: tes yang mengungkap titik buta
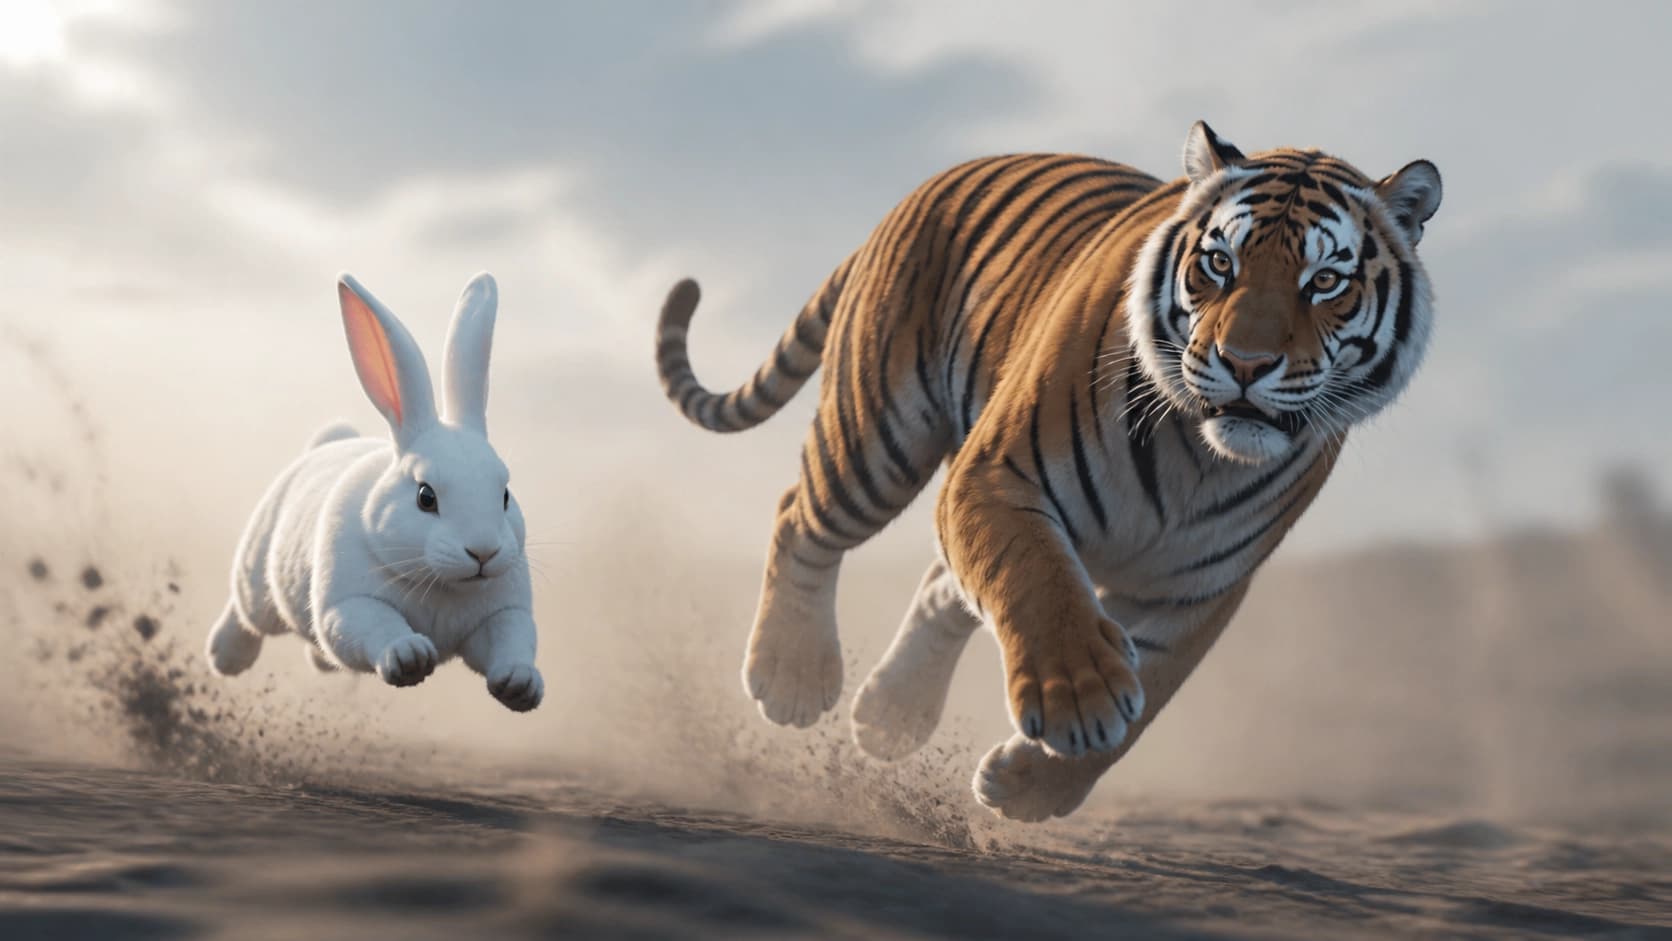
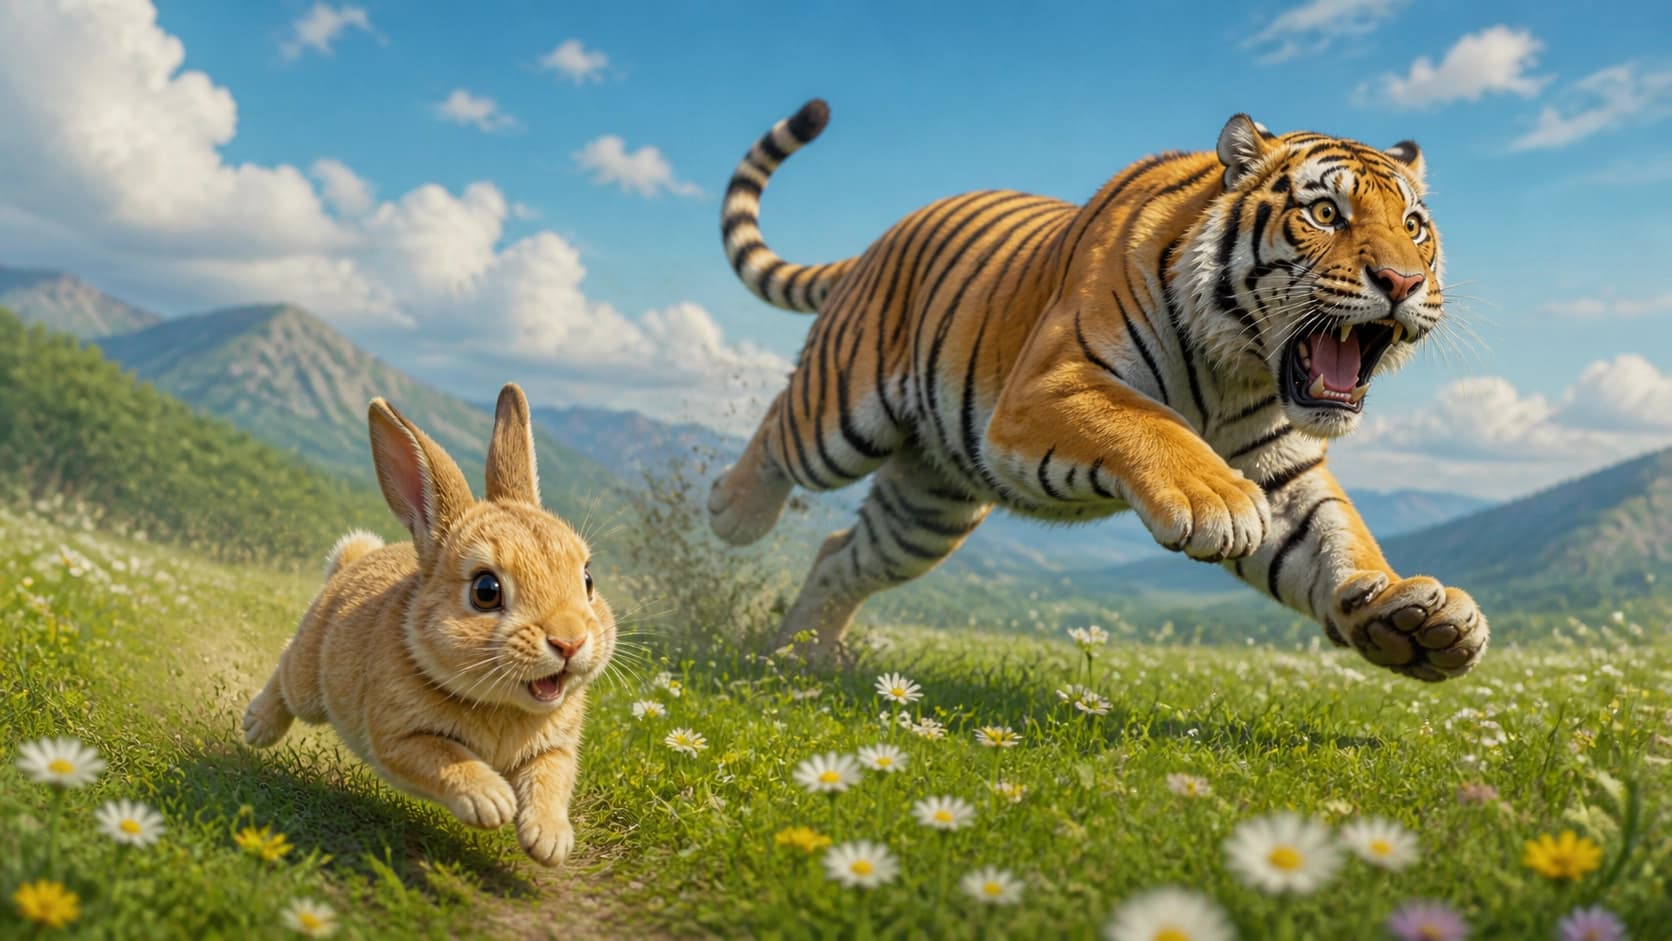
Bayangkan sebuah gambar: seekor kelinci melesat di padang rumput, dan di depannya seekor harimau kabur. Komposisinya rapi, detailnya tergambar jelas, tidak ada ambiguitas — secara visual semuanya jelas. Namun sebagian besar model multimodal terbuka justru menggambarkan adegan ini secara terbalik. Bukan karena penglihatannya buruk, melainkan karena tidak mempercayai apa yang dilihatnya.
Paradoks inilah yang dikupas dalam penelitian «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, penulis Chen Ling, Tongwei Zhang, Hanqian Li, dan Nai Ding). Karya ini terbit pada Januari 2026 dan sejak itu telah diperbarui dua kali — revisi terakhir bertanggal Agustus. Secara formal ini adalah artikel tentang computer vision, tetapi kesimpulannya jauh lebih luas: kesimpulan tersebut menghantam logika dasar bagaimana asisten multimodal modern dibangun.
Apa yang sebenarnya diuji
Model multimodal sudah lama dan dengan percaya diri menyelesaikan tugas-tugas "arus utama": mendeskripsikan foto, menemukan objek berdasarkan kueri teks, menjawab pertanyaan berdasarkan diagram. Namun tes semacam itu hampir selalu dibangun di atas adegan yang sesuai dengan ekspektasi sehari-hari. Kucing di ambang jendela, orang dengan payung di tengah hujan, mobil di jalan — semua ini telah dilihat model jutaan kali dalam keterangan dataset.
Lalu apa yang terjadi jika dunia visual bertentangan dengan akal sehat? Untuk mengetahuinya, tim menyusun benchmark CAIT — 400 adegan sintetis dengan detail tinggi. Masing-masing menggambarkan tindakan yang bertentangan dengan gambaran dunia yang lazim: kelinci yang mengejar harimau itu tadi adalah contoh khasnya. Gambarnya sintetis, artinya terkendali: kita bisa yakin bahwa petunjuk visualnya benar-benar ada dan tidak ambigu.
Ide kunci metodologinya adalah bahwa jawaban yang benar di sini tidak bisa disimpulkan dari teks pertanyaan. Jawaban itu hanya bisa diperoleh dengan satu cara — melihat gambarnya dan menerima apa yang tergambar di sana.
Manusia, model tertutup, dan model terbuka: kesenjangan dalam angka
Hasilnya terbagi ke dalam tiga tingkat yang sangat berbeda.
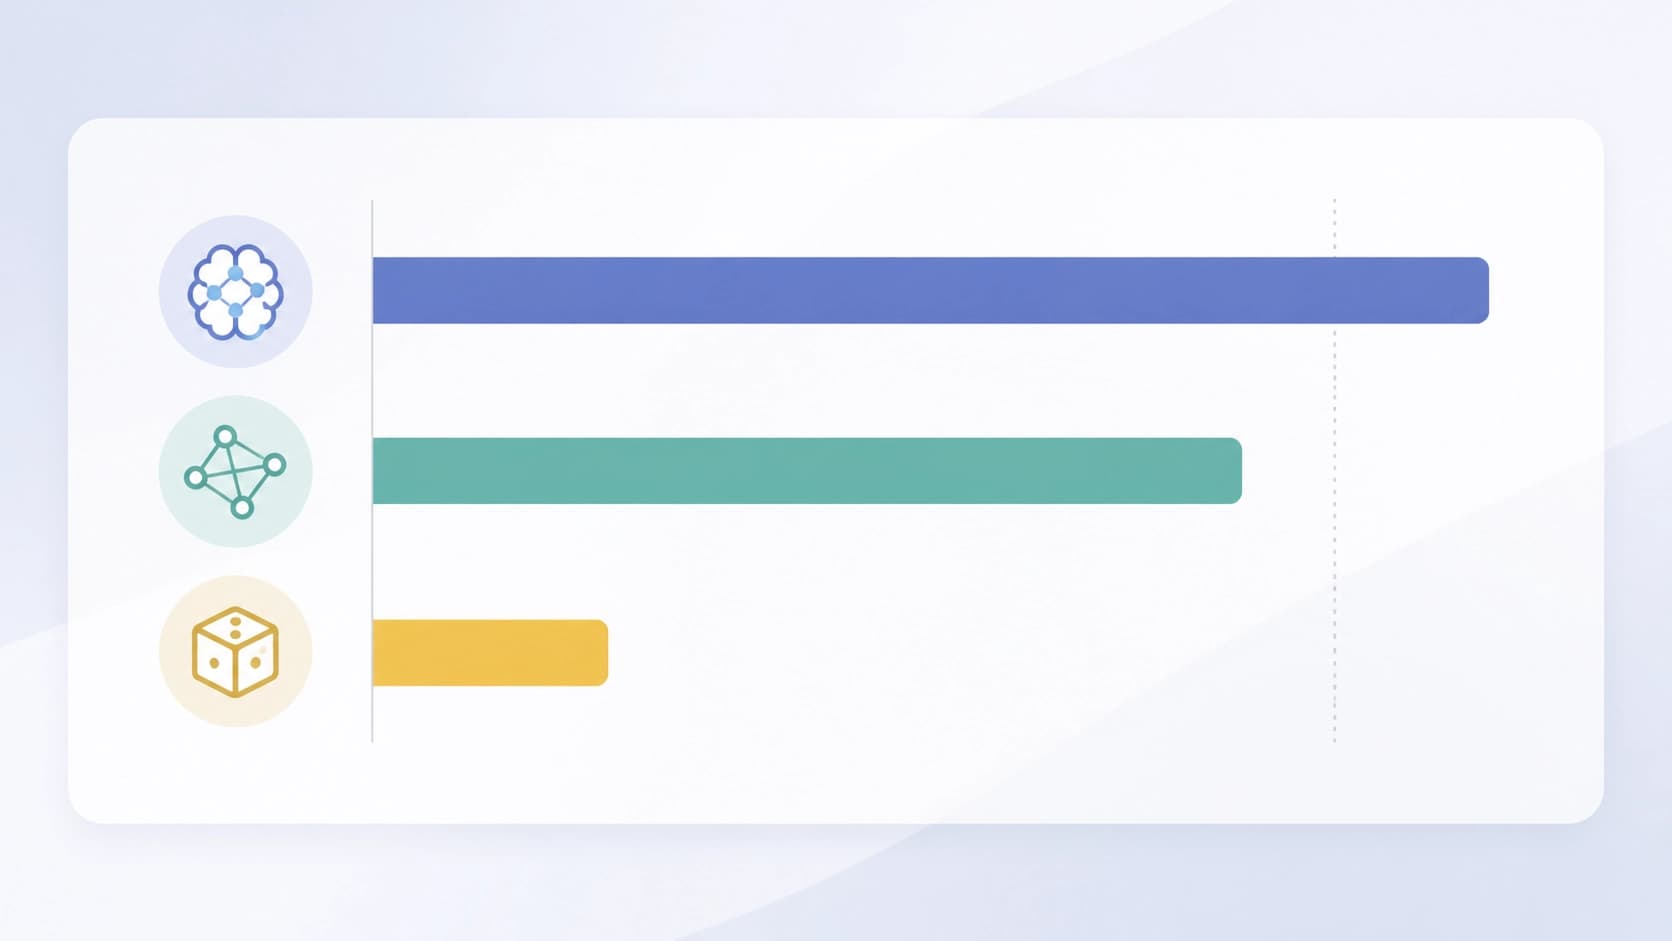
- Manusia menyelesaikan tugas ini hampir sempurna — akurasi sekitar 0,95. Bagi kita tidak ada yang sulit untuk melihat adegan yang tidak biasa dan sekadar mencatatnya.
- Model proprietari — dalam penelitian ini diikutsertakan solusi-solusi terkemuka, termasuk Claude dan Gemini — menunjukkan pemahaman yang stabil: akurasi mencapai 0,88. Tidak sempurna, tetapi sistemnya jelas melihat gambar, bukan menebak.
- Model instruction-tuned terbuka — 14 perwakilan representatif — terpuruk hingga tingkat tebakan acak. Dengan kata lain, jawabannya hampir tidak berkorelasi dengan apa yang sebenarnya tergambar.
Inilah alur cerita utamanya: kesenjangan antara "harimau" pada solusi tertutup dan "kelinci" pada solusi terbuka ternyata bukan kosmetik, melainkan prinsipil. Persoalannya bukan bahwa model terbuka sedikit lebih buruk dalam menangani tugas sulit — dalam adegan kontra-intuitif, mereka berhenti menjadi multimodal dalam arti yang cukup bermakna.
Tersangka utama — prior bahasa
Analisis kesalahan menunjukkan mekanisme kegagalannya. Persoalannya bukan bahwa model tidak mengenali kelinci. Persoalannya adalah bahwa model memilih untuk tidak mempercayai matanya.
Ketika sinyal visual bertentangan dengan statistik teks, prior bahasa yang kuat pun berlaku: model secara otomatis menggantikan pengamatan yang anomali dengan deskripsi teks yang paling sering muncul. Harimau mengejar kelinci — frasa ini terus-menerus muncul dalam korpus. Urutan sebaliknya — hampir tidak pernah. Dan pada persimpangan antara "melihat" dan "mengharapkan", sistem memilih yang kedua.
Pada dasarnya, masukan visual bagi model semacam itu hanyalah petunjuk tentang frasa mana yang harus diambil dari memori. Jika gambarnya mengonfirmasi pola — semuanya baik-baik saja. Jika gambarnya bertentangan dengannya — pola yang menang. Dari situlah akurasi setingkat lempar koin: model menjawab berdasarkan inersia bahasa, bukan berdasarkan isi gambar.
Jebakan penalaran: "mengubah pikiran" tentang adegan
Saran yang logis adalah menambahkan rantai penalaran (Chain-of-Thought) ke model. Biarkan model mengucapkan langkah-langkahnya, memeriksa dirinya sendiri, sampai pada kesimpulan. Sebagian ini berhasil: akurasinya memang meningkat.
Namun peningkatan itu ada harganya, dan harganya ganda.
Pertama, jawabannya menjadi jauh lebih lambat — penalaran yang panjang membutuhkan waktu dan komputasi. Kedua — dan ini lebih menarik — muncul mode kegagalan baru. Model mulai benar-benar mengubah pikiran tentang apa yang dilihatnya. Seolah-olah ia mencatat adegannya, lalu membuangnya: hal seperti ini tidak mungkin terjadi, ini melanggar hukum fisika dunia nyata, berarti saya mungkin salah. Akibatnya, sistem menolak menerima konten visual faktual justru karena konten itu mustahil.
Hasilnya adalah ironi tersendiri: alat yang dimaksudkan untuk membuat kesimpulan lebih berdasar, kadang berubah menjadi mesin untuk menekan fakta-fakta yang tidak nyaman.
Apa yang membantu: fine-tuning dan prompting terstruktur
Kabar baiknya adalah masalah ini tidak fatal. Para penulis menjelaskan dua pendekatan yang secara signifikan meredam ketergantungan pada prior bahasa.
- Fine-tuning yang ditargetkan. Pelatihan lanjutan pada data yang sesuai mengurangi kecenderungan menggantikan pengamatan dengan pola dan mengembalikan bobot pada kanal visual.
- Prompting terstruktur. Jika model diberi format jawaban yang mewajibkannya mencatat apa yang diamati terlebih dahulu, lalu baru menafsirkannya, akurasi meningkat tanpa pelatihan ulang.
Dalam kedua kasus, model terbuka mulai mendasarkan kesimpulannya pada bukti visual yang nyata, bukan pada statistik teks. Artinya, kesenjangan dengan solusi tertutup adalah soal arsitektur dan pelatihan, bukan ketidakmungkinan yang prinsipil.
Apa implikasinya dalam praktik
Bagi pengembang yang membangun produk di atas model multimodal terbuka, kesimpulannya cukup membumi.
Perlu diingat bahwa jawaban yang percaya diri tidak sama dengan apa yang dilihat. Di tempat adegannya sesuai dengan ekspektasi, model menunjukkan keandalan; di tempat adegannya menyimpang, model diam-diam dan tanpa disadari menyisipkan karangan yang masuk akal. Yang paling berbahaya adalah kesalahannya tidak terlihat seperti kesalahan: deskripsinya menjadi mulus, logis, dan sepenuhnya salah.
Secara terpisah, perlakukan penalaran sebagai alat dengan efek samping. Chain-of-Thought tidak selalu membantu dan tidak pada semua tugas — kadang ia mengubah model menjadi skeptis yang menolak kesimpulannya sendiri yang sebenarnya benar.
Dan akhirnya, yang terpenting. "Kelinci mengejar harimau" bukanlah keanehan, melainkan ujian murni tentang apa yang sebenarnya dipercayai model. Selama jawaban atas pertanyaan ini masih tidak berpihak pada gambar, menyebut sistem itu multimodal hanya bisa dilakukan secara bersyarat.


