
ड्रोन से भीड़ की गिनती बिना मार्किंग के: सऊदी अरब में विश्व कप के लिए अनुकूली प्रोटोकॉल
शोधकर्ताओं ने 525 रनों पर एक समाधान का परीक्षण किया जो हवा से लोगों की गिनती में डोमेन परिवर्तन के कारण होने वाली 31–49% त्रुटि को ठीक करता है और भीड़ उभरने से पहले ही कुचले जाने के जोखिम के बारे में चेतावनी देता है। कार्य में बड़े पैमाने के आयोजनों के लिए गुरुत्वाकर्षण का नियम और छह-बिंदु तैनाती प्रोटोकॉल भी प्रस्तावित किया गया है।
ड्रोन से बिना लेबलिंग के भीड़ की गिनती: बड़े पैमाने के आयोजनों के लिए अनुकूली प्रोटोकॉल
विश्व स्तर पर बड़े पैमाने के खेल आयोजनों और धार्मिक समारोहों की मेजबानी की तैयारी में, भीड़ प्रबंधन तकनीकों को लगातार निखारा जा रहा है। सबसे चुनौतीपूर्ण परिदृश्यों में से एक वार्षिक तीर्थयात्रा है, जहाँ लाखों श्रद्धालु एक साथ एकत्र होते हैं। ऐसे आयोजनों के लिए सिर्फ कैमरे वाले ड्रोन ही नहीं, बल्कि बुद्धिमान प्रणालियों की आवश्यकता होती है जो वास्तविक समय में भीड़ के घनत्व का आकलन कर सकें और भगदड़ के खतरे के बारे में पहले से चेतावनी दे सकें।
समस्या यह है कि लोगों की गिनती के मानक मॉडल एक डेटा पर प्रशिक्षित होते हैं, लेकिन वास्तविकता में उन्हें दूसरे डेटा का सामना करना पड़ता है: अलग कोण, रोशनी, घनत्व, गति। प्रत्येक नए फ्रेम को मैन्युअल रूप से लेबल करना बहुत महंगा और धीमा है। इसलिए शोधकर्ता बाहरी संकेतों के बिना, मॉडलों को तुरंत अनुकूलित करने के तरीकों की तलाश कर रहे हैं। arXiv (2608.17625) पर हालिया कार्य इसी समस्या को समर्पित है, जिसके लेखकों ने भारी भीड़ की स्थितियों में ऐसी प्रणालियों की सुरक्षित तैनाती के लिए एक संपूर्ण प्रोटोकॉल प्रस्तावित किया है।
मॉडल को अपरिचित फ्रेम पर कैसे काम कराएं
मुख्य विचार बिना लेबल के अनुकूलन है। मॉडल केवल फ्रेम का उपयोग करके, बिना किसी लेबलिंग के, नए वीडियो स्ट्रीम के अनुकूल खुद को ढाल लेता है। लेखकों ने 525 नियंत्रित रन किए और चार प्रकार की विकृतियों और पांच गंभीरता स्तरों पर दृष्टिकोण का परीक्षण किया। यह पता चला कि अनुकूलन डोमेन शिफ्ट द्वारा लाई गई त्रुटि के 31 से 49 प्रतिशत के बीच सुधार करता है — यानी प्रशिक्षण और वास्तविक डेटा के बीच का अंतर। सबसे अच्छी विधि स्थिर मूल मॉडल की तुलना में पूर्ण त्रुटि को 41.8 अंक कम करती है, और परिणाम सांख्यिकीय रूप से महत्वपूर्ण है (p=7.5×10⁻¹⁰)।
लेकिन केवल औसत गुणवत्ता ही महत्वपूर्ण नहीं है। शोधकर्ताओं ने गंभीरता का नियम निकाला है, जो विधियों को दो श्रेणियों में विभाजित करता है: वे जो सटीकता का निरंतर पूर्ण अंतर देते हैं, और वे जिनका अंतर दृश्य की जटिलता बढ़ने के साथ बढ़ता है। व्यवहार में, इसका मतलब है कि स्थिरता बजट की पहले से गणना की जा सकती है — यह समझना कि एल्गोरिदम का कौन सा कॉन्फ़िगरेशन वास्तविक उड़ान में सुरक्षित रूप से चलाया जा सकता है, और कौन सा बहुत जटिल फ्रेम पर गुणवत्ता खोना शुरू कर देगा।
इसके अतिरिक्त, लेखकों ने वास्तविक हवाई फुटेज के साथ पूर्ण पैमाने के कॉर्पस पर मॉडल का परीक्षण किया। मूल मॉडल, जिसे 14.6 की सत्यापन त्रुटि तक प्रशिक्षित किया गया था, वास्तविक फ्रेम पर MAE में 48 अंक खराब प्रदर्शन कर रहा था। अनुकूलन ने मुख्य कमी को ठीक किया — घने दृश्यों का व्यवस्थित रूप से कम आकलन। यह महत्वपूर्ण है, क्योंकि घने दृश्यों में ही भगदड़ बनना शुरू होती है, और डेटा को कम आंकना त्रासदी का कारण बन सकता है।
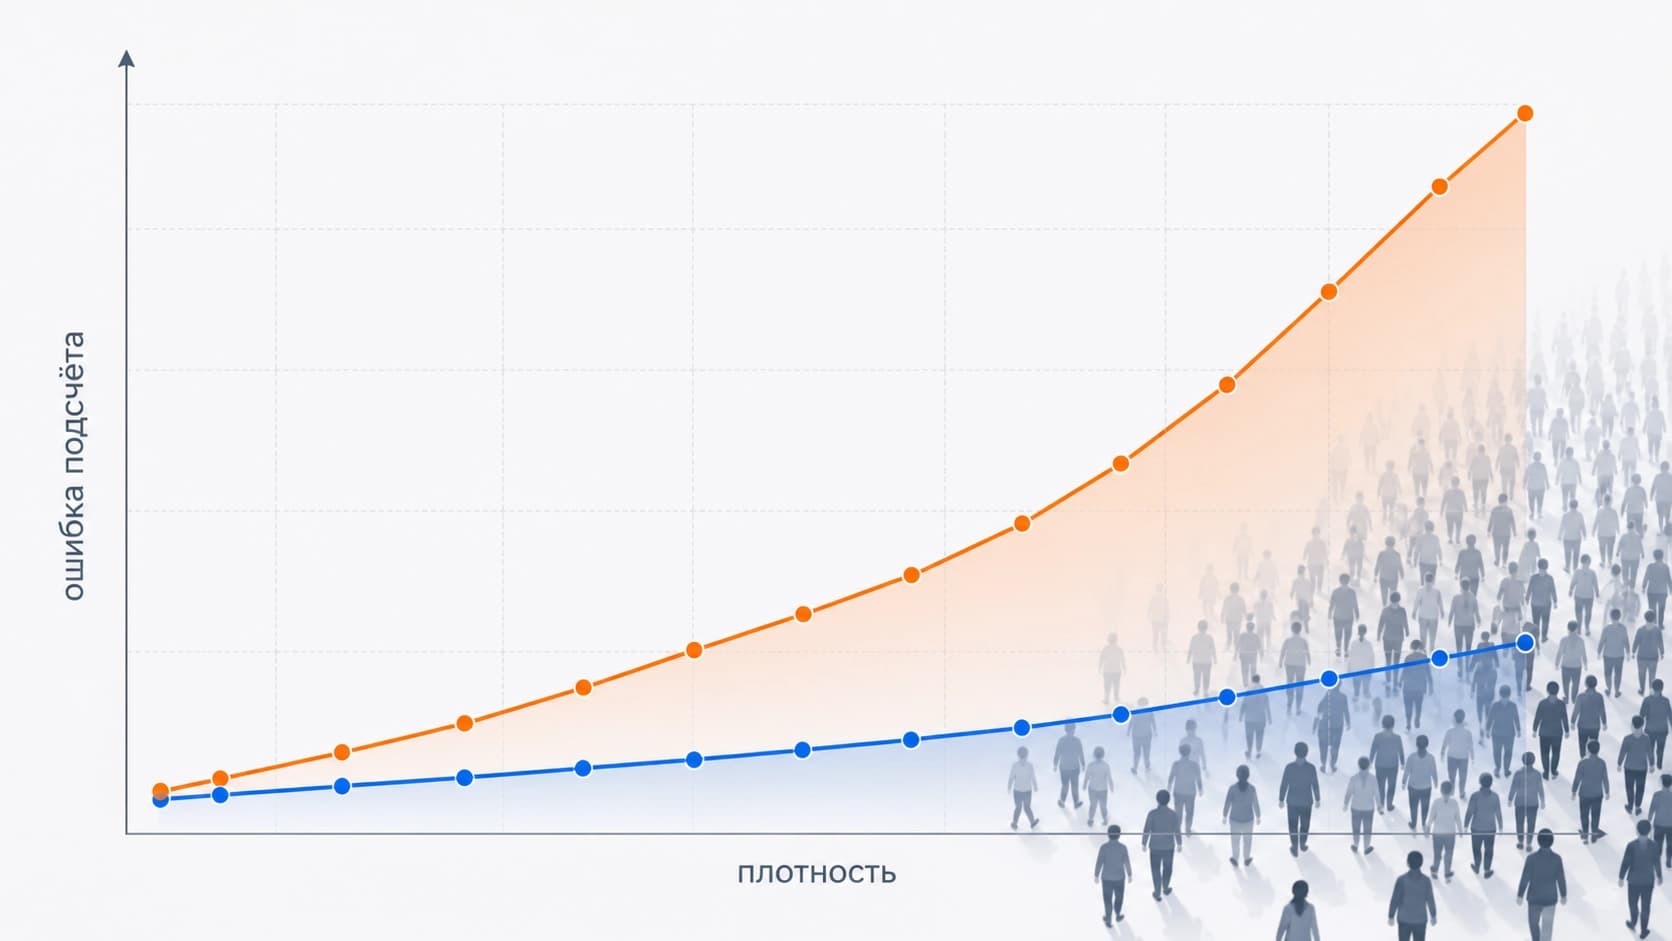
अनुकूलन कब धोखा दे सकता है
लेखक दृष्टिकोण की सीमाओं पर भी ईमानदारी से चर्चा करते हैं। उन्होंने एक विशेष मोड का परीक्षण किया जिसमें 200 मिलीसेकंड के अंतराल के साथ 300 फ्रेम के लंबे क्लिप का उपयोग किया गया — मानक से पांच गुना चौड़ा। यह पता चला कि इस मोड में, अनुकूलन संकेत लोगों के वास्तविक प्रवाह से नहीं, बल्कि सरल डेटा सामान्यीकरण द्वारा समझाया जाता है। निरंतरता का अवशेष आनुपातिक गिनती त्रुटियों पर लगभग प्रतिक्रिया नहीं करता है, जो वास्तव में डोमेन शिफ्ट के कारण उत्पन्न होती हैं। चार एब्लेशन ने इसकी पुष्टि की: संकेत और वास्तविक प्रवाह के बीच सहसंबंध 0.999 था, और 40% इनपुट डेटा की विकृति ने सटीकता को केवल 0.05 MAE से बदला। निष्कर्ष: अनुकूलन पर तभी भरोसा किया जा सकता है जब इसका काम वास्तव में प्रवाह के कारण हो, न कि प्रसंस्करण कलाकृतियों के कारण।
"शिफ्ट मापना" ही पर्याप्त क्यों नहीं है
कई प्रणालियाँ डोमेन शिफ्ट की मात्रा का आकलन करने और इसके आधार पर यह तय करने की कोशिश करती हैं कि अनुकूलन कब चालू करना है। लेखकों ने दिखाया कि यह दृष्टिकोण काम नहीं करता। उन्होंने एक बिना लेबल वाला शिफ्ट गेट बनाया और पाया कि शिफ्ट की मात्रा और सटीकता को वास्तविक नुकसान लगभग रैंक सहसंबंधित नहीं हैं (Spearman rho=0.20)। वास्तविक शिफ्टों के बीच, सहसंबंध तो नकारात्मक भी है (rho=-0.60)। इसका मतलब है कि शिफ्ट की मात्रा पर आधारित गेट 58% मामलों को छोड़ देता है जहाँ अनुकूलन मदद कर सकता था, और इसके विपरीत — वहाँ चालू हो जाता है जहाँ इसकी आवश्यकता नहीं है। इसलिए लेखक वितरण की पूंछ की निगरानी के साथ बिना शर्त अनुकूलन की नीति प्रस्तावित करते हैं — औसत शिफ्ट पर नहीं, बल्कि दुर्लभ लेकिन खतरनाक विचलनों पर ध्यान देना।
छह-बिंदु तैनाती प्रोटोकॉल
सभी प्रयोगों के आधार पर, लेखकों ने कार्यान्वयन के लिए एक व्यावहारिक प्रोटोकॉल तैयार किया। इसमें छह चरण शामिल हैं — पूर्ण रिज़ॉल्यूशन पर सत्यापन से लेकर वास्तविक भीड़भाड़ वाले एपिसोड पर जोखिम मॉड्यूल की जाँच तक। उनका ऐसा मॉड्यूल वास्तविक भीड़भाड़ वाले छह पूर्ण-लंबाई वाले क्लिपों में से दो पर काम कर गया। प्रोटोकॉल के लिए यह भी आवश्यक है कि पहले से तय किया जाए कि किसी विशेष प्रकार की शूटिंग के लिए कौन से अनुकूलन तरीके स्वीकार्य हैं, और यह जाँचा जाए कि सामान्यीकरण घनत्व के वास्तविक संकेत को छिपा तो नहीं रहा है।
अंततः, शोध से पता चलता है: ड्रोन से बिना लेबल के भीड़ की गिनती अब सिद्धांत नहीं, बल्कि इंजीनियरिंग अभ्यास है। लेकिन सिस्टम को इतने बड़े पैमाने पर काम करने के लिए, न केवल सटीक मॉडल की आवश्यकता है, बल्कि उनके परीक्षण और तैनाती के लिए सुविचारित प्रक्रियाओं की भी आवश्यकता है। यह दृष्टिकोण — आँकड़ों से लेकर विशिष्ट प्रोटोकॉल तक — एल्गोरिदम को सामूहिक आयोजनों की सुरक्षा के लिए एक विश्वसनीय उपकरण में बदलने की अनुमति देता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026
STAR: एंड-टू-एंड घटना प्रबंधन के लिए समय-संदर्भ और सेवा ग्राफ का अनुकूली सामान्यीकरण
STAR फ्रेमवर्क मेट्रिक्स, लॉग और ट्रेस के आधार पर अभ्यावेदन सीखता है। इसके लिए यह बहुस्तरीय समयगत गतिशीलता और सेवाओं के बीच निर्भरता संरचना को ध्यान में रखते हुए सीखने योग्य सामान्यीकरण लागू करता है। दो वास्तविक डेटासेट पर यह पाइपलाइन आधुनिक आधारभूत विधियों की तुलना में विसंगति पहचान, विफलताओं की रैंकिंग और मूल कारणों की खोज की गुणवत्ता में लगातार सुधार करती है।
10 नवम्बर 2026