
CEG-Agent:通过错误图对 LLM 智能体轨迹中的失败进行因果分析
本文提出了 CEG-Agent,这是一种用于对智能体执行轨迹进行因果诊断的工具框架。形式化分类将异常、错误和故障区分开来,类型化的 CEG 图将执行事件与诊断节点及最终失败关联起来;基准测试 CEG-Bench 证实,该方法在语义和结构准确性方面处于领先地位。
智能体轨迹诊断的难点
在复杂应用中,人们会使用基于 LLM 的智能体。这类智能体的轨迹很长,因而难以诊断故障。
现有诊断方法将异常、错误和故障混为一谈,导致诊断目标含糊不清。
这些方法没有对具有因果意义的错误如何传播和放大进行结构化建模。因此,任务最终故障无法得到可靠归因。
实用标准:诊断方法应区分不同类型的偏差,并追踪它们之间的因果关系。
什么是 CEG-Agent
CEG-Agent 是一个使用工具的智能体框架,用于对智能体轨迹进行因果诊断。
该框架引入了明确的异常、错误和故障分类体系,并以此构建因果错误图(Causal Error Graphs,CEGs)。
| 方法 | 区分异常、错误和故障 | 错误传播模型 |
|---|---|---|
| 现有诊断方法 | 将这些概念混为一谈 | 未进行结构化建模 |
| CEG-Agent | 引入明确的分类体系 | 构建具有因果关系的 CEGs |
选择标准:框架应提供明确的诊断目标,并以类型化的因果模型为基础。
因果错误图:类型化的因果表示
CEGs 是一种统一的类型化表示,用因果关系连接轨迹中的各个元素。
图中包含三类元素:
- 执行事件;
- 诊断节点;
- 以故障形式呈现的结果。
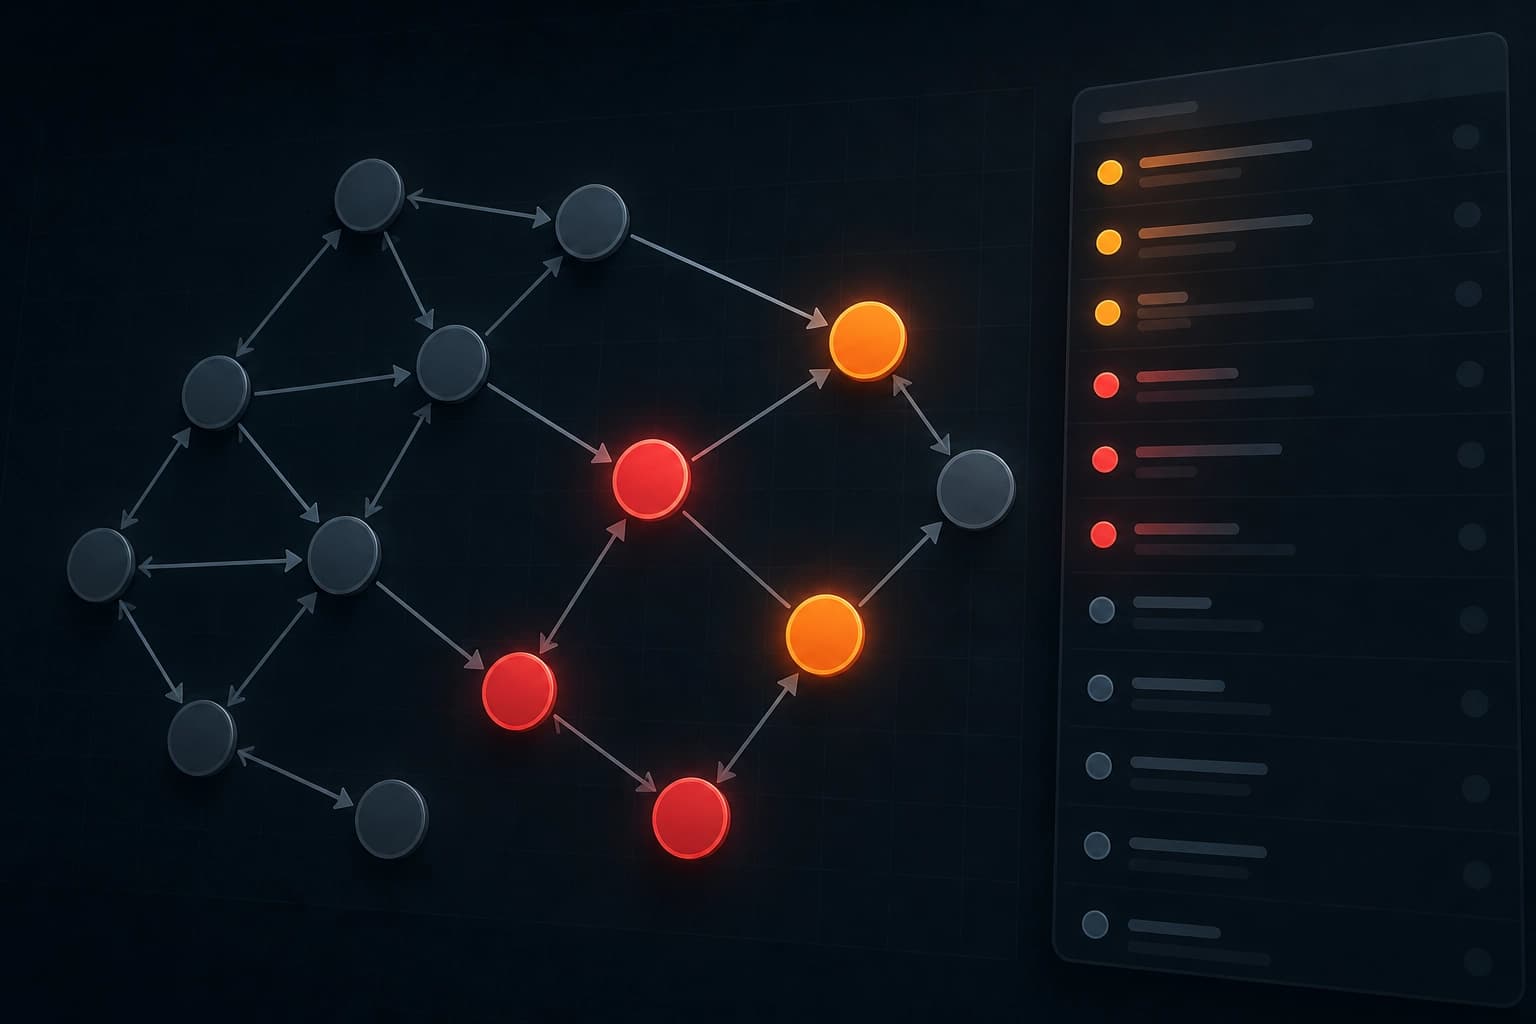
所有元素都通过统一格式的因果关系相连。这使该图有别于彼此孤立的信号集合。
标准:这种表示应通过明确的因果关系,将执行过程与最终故障联系起来。
CEG-Bench 与基于 AAAP 的标注
为评估轨迹因果诊断而创建了 CEG-Bench。这是一个完全由智能体进行标注的基准测试。
该基准中的 CEG 标注采用对抗式智能体裁决协议(Adversarial Agentic Adjudication Protocol,AAAP)生成。标注具有较高的可靠性和一致性。
研究人员还使用专家构建的人工基准集对标注进行了验证。自动标注与专家标注高度吻合。
标准:经过人工基准验证标注的基准测试,适用于比较因果诊断方法。
结果与选择标准
在 CEG-Bench 实验中,CEG-Agent 达到了最先进的水平。评估依据两项标准进行。
第一项标准是语义宽松评分,第二项是结构精确评分。该框架在这两项标准上都达到了最先进的水平。
选择标准:如果任务同时要求分析在语义和结构上都正确,应以达到这一水平的方法为参考。
常问问题
相关材料
所有材料
转向概率单纯形可缩小对比式多模态模型中的模态差距
在论文 arXiv:2610.32890 中,作者提出用概率单纯形替代球面嵌入,并加入轻量级 softmax 适配器和总变差相似度。在五个检索基准测试中,模态间的质心 ℓ2 距离降低了 97–99%,同时检索质量保持不变或有所提升。
3 十一月 2026
ActionRAG 如何在 LLM 智能体的记忆图扩散过程中重新审视证据
提出了一种图式记忆架构,在索引阶段谨慎协调实体,并在查询时依据局部结构重新评估关联。在 MemoryAgentBench 上,该方法的平均准确率达到 55.1,比最强检索基线高 5.4 个百分点,且每次查询的合成成本很低。
3 十一月 2026
十五家公司支持 MDK Tether,实现挖矿自动化
设备制造商、矿池和运营商已着手基于 Tether 开放工具集开发集成,以统一设备监控和管理;AI 代理 QVAC 已在此基础上运行。目前尚未发布有关降低电力成本或提高效率的独立验证。
2 十一月 2026