
CARAT: testam se os LLMs de ciência dos materiais geram estruturas ou parafraseiam o prompt
O trabalho propõe um protocolo que fixa a pergunta e a resposta de referência em oito formas de apresentação da estrutura e assinala separadamente as relações no GraphSpace. As experiências com afinação com pares, mascaramento de campos-alvo e adição de evidências mostram que o modelo é capaz de aprender tanto a aplicação da relação como o seguimento de referências, mas a remoção da referência reduz a precisão para níveis inferiores aos dos percursos heurísticos.
Porque a precisão não prova raciocínio
Um modelo de linguagem para ciência dos materiais pode dar a resposta correta por duas razões diferentes. Ou a deduz a partir de dados estruturais, ou reproduz um valor já presente na entrada. A métrica habitual de precisão não distingue estes casos. Uma descrição estrutural pode conter um campo usado para avaliar a resposta, fazendo com que a pontuação reflita a leitura de uma pista.
O benchmark CARAT foi criado em torno desta distinção. Avalia se os LLM de ciência dos materiais raciocinam com base em dados estruturais ou se repetem a pista. Os autores do artigo são Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li e Bin Chong; o trabalho foi submetido a 29 de setembro de 2026.
Critério prático: uma elevada precisão em dados estruturais, por si só, não prova nada. É preciso analisar as condições em que a resposta foi obtida.
Como funciona a comparação controlada
A pergunta e a resposta de referência permanecem inalteradas nas oito representações comparadas. As relações estruturais são indicadas separadamente, em GraphSpace.
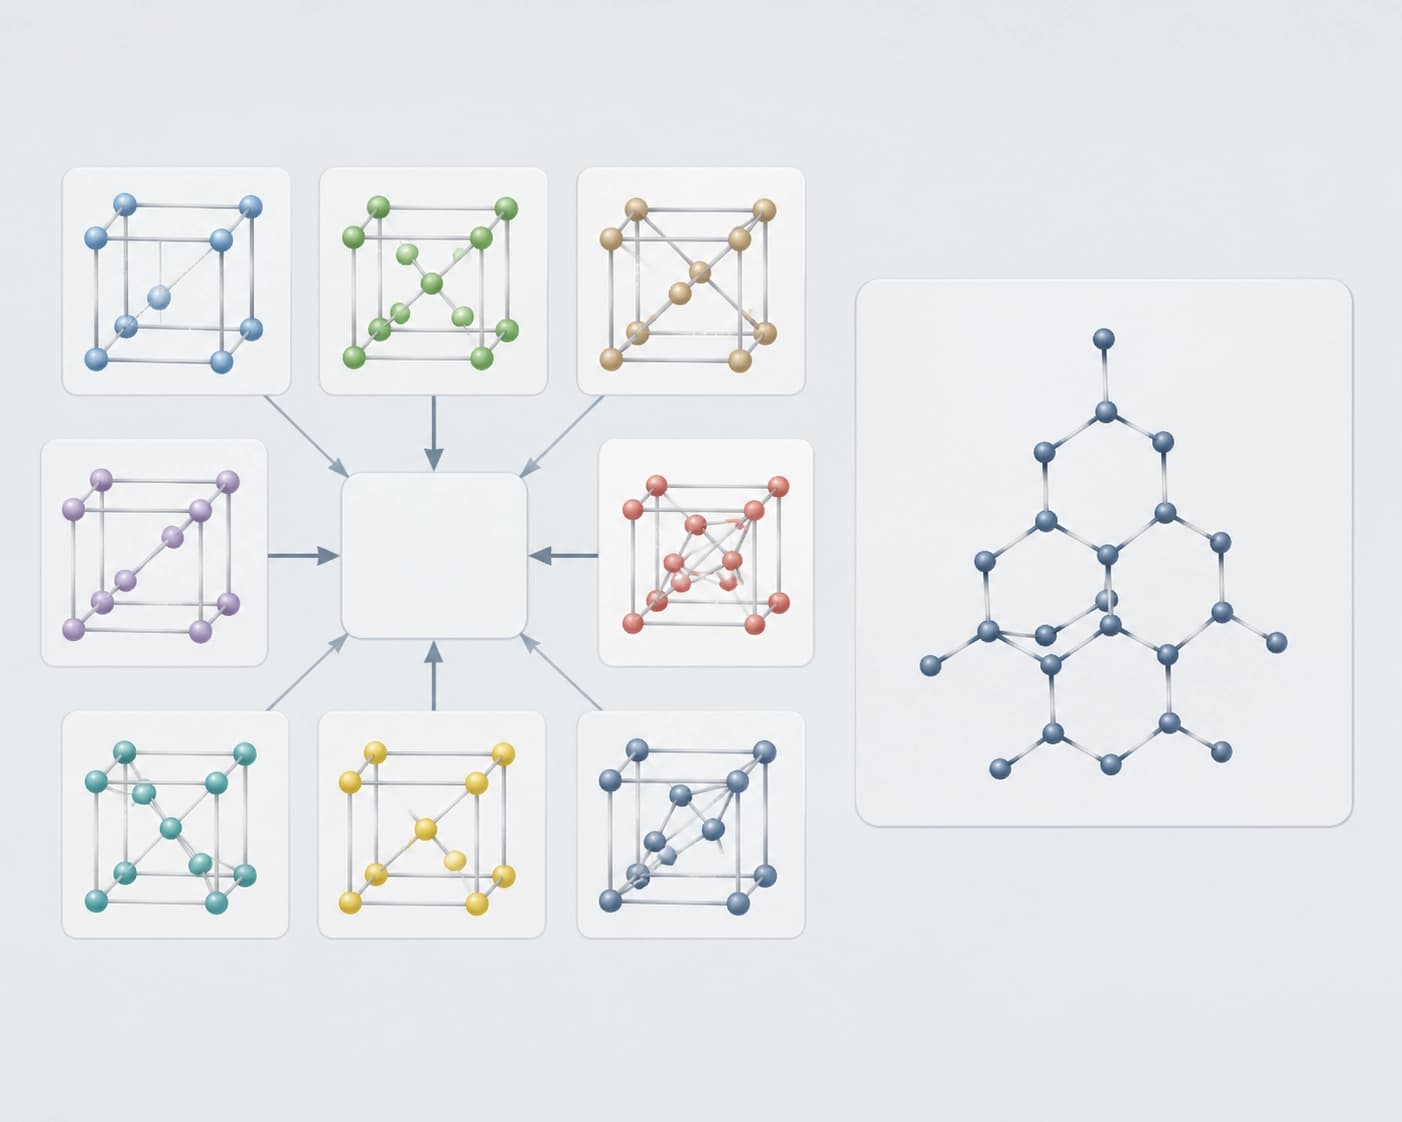
A isto juntam-se o ajuste fino controlado, a ocultação das respostas, a adição de evidências, a inferência emparelhada e uma regra que permite abster-se de fazer uma afirmação.
| O que é comparado | Diferença |
|---|---|
| Representação com base na estrutura versus entrada apenas com a fórmula, nas famílias de tarefas mais difíceis | 17.3 pontos |
Manter a pergunta fixa elimina a explicação baseada na formulação da tarefa. A ocultação das respostas impede que o modelo simplesmente indique um valor já fornecido.
Conclusão: só faz sentido comparar representações quando a pergunta e a referência permanecem inalteradas. Caso contrário, a diferença indicará a qualidade do texto da tarefa, não o trabalho com a estrutura.
Qual é a diferença entre GraphSpace e um grafo simples
GraphSpace supera um grafo periódico simples em 19.3 pontos. Esta diferença resulta de dois efeitos distintos.
| Condição | Diferença |
|---|---|
| A representação simples contém tudo o que é necessário para responder | 1.96 pontos |
| Esses campos estão totalmente ausentes da representação simples | 46.7 pontos |
Quando a representação de base é suficiente para responder, a vantagem quase desaparece. Quando os campos necessários não estão presentes, a diferença torna-se grande. Os autores observam que o resultado principal da comparação reflete a falta de dados na representação de base, e não a forma como as evidências são representadas.
Critério prático: antes de concluir que uma representação é superior, verifique que campos contém. Caso contrário, está a medir a completude dos dados, não o método.
Atalhos e reformulação do benchmark
A avaliação revelou um ponto fraco do conjunto de tarefas. Uma regra que ignora a referência e lê diretamente a lista responde a quatro das sete famílias de tarefas mais difíceis. O modelo pode não compreender a relação e simplesmente contorná-la.
O benchmark foi reformulado. Onze destes atalhos passaram a produzir resultados próximos do acaso.
Conclusão: um conjunto de tarefas só serve para avaliar o raciocínio depois de ser verificado quanto a possíveis atalhos. Se uma regra simples resolver algumas famílias, o que está a ser avaliado não é o raciocínio.
A referência na resposta e o uso da relação
O modelo congelado cita uma referência, mas dá a mesma resposta em 95.6% dos casos emparelhados quando essa referência é redirecionada. O modelo repete a relação, sem a utilizar.
| Condição | Proporção de casos emparelhados com a mesma resposta |
|---|---|
| Modelo congelado, referência redirecionada | 95.6% |
| Após treino controlado, referência redirecionada | 99.8% |
| Referência removida | 23.4% |
| Melhor atalho | 27.0% |
Após o treino controlado, o valor chega a 99.8%. A remoção da referência reduz o valor para 23.4%, abaixo dos 27.0% obtidos com o melhor atalho. Os autores concluem que ambos os passos de treino — usar a relação e apoiar-se na referência — podem ser aprendidos.
Critério: citar uma referência não é o mesmo que utilizá-la. É preciso verificar o comportamento do modelo quando a referência é redirecionada e quando é removida.
O que isto significa para a avaliação de ferramentas
- Verifique se a entrada contém a resposta pronta à pergunta.
- Analise os resultados quando a referência é redirecionada e removida, não apenas quando é citada.
- Exija uma descrição dos controlos: pergunta e referência inalteradas, e várias representações.
- Confirme se o conjunto de tarefas foi atualizado após a verificação de possíveis atalhos.
- Avalie a diferença alegada em conjunto com a composição dos dados, e não como um número isolado.
Critério de escolha: um resultado merece confiança se não puder ser explicado pela presença do campo necessário na pista ou pela ação de uma regra simples de contorno.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A transição para o simplex probabilístico reduz a lacuna modal em modelos multimodais contrastivos
O trabalho arXiv:2610.32890 propõe substituir embeddings esféricos por um simplex probabilístico, adicionando adaptadores softmax leves e a similaridade de Variação Total. Em cinco benchmarks de recuperação, a distância ℓ2 entre centroides de modalidades diferentes diminui 97–99%, mantendo ou melhorando a qualidade da recuperação.
3 novembro 2026
Como o ActionRAG reavalia evidências durante a difusão no grafo de memória de agentes LLM
Foi proposta uma arquitetura de memória em grafo que, na fase de indexação, harmoniza cuidadosamente as entidades e, no momento da consulta, reavalia as relações com base na estrutura local. No MemoryAgentBench, o método alcançou uma precisão média de 55,1 e uma melhoria de 5,4 pontos percentuais face ao melhor método de referência de recuperação, com um custo de síntese reduzido por consulta.
3 novembro 2026
Quinze empresas apoiaram o MDK Tether para automatizar a mineração
Fabricantes de equipamentos, pools e operadores assumiram o desenvolvimento de integrações com o conjunto aberto da Tether para unificar a monitorização e a gestão dos equipamentos; o agente de IA QVAC já funciona com base nele. Ainda não foram publicados dados independentes que confirmem a redução dos custos de eletricidade ou o aumento da eficiência.
2 novembro 2026