
AffordanceWAM: দৃশ্য পূর্বাভাস ও ম্যানিপুলেটর নিয়ন্ত্রণের মধ্যস্থতাকারী হিসেবে অ্যাফোর্ড্যান্সগুলি
এই কাজটিতে এমন একটি জেনারেটিভ মডেলের বর্ণনা দেওয়া হয়েছে, যা একই সঙ্গে ভবিষ্যতের RGB পর্যবেক্ষণ, স্কেলার ফিল্ড ও অ্যাফোর্ড্যান্সের হিটম্যাপ এবং রোবটের অবিচ্ছিন্ন কমান্ড পূর্বাভাস দেয়। অ্যাকশন অ্যানোটেশন ও রিটার্গেটিং ছাড়াই মানুষের ভিডিও ব্যবহার করে এটি পারস্পরিক ক্রিয়ার বৈচিত্র্য বাড়ায়। RoboCasa, CALVIN ABC→D এবং বাস্তব কাজগুলোতে, শুধু RGB ও শুধু রোবটের ডেটার ওপর ভিত্তি করে তৈরি বেসলাইনগুলোর তুলনায় এই পদ্ধতি ধারাবাহিকভাবে ভালো ফল দেয়।
মডেলটি কী
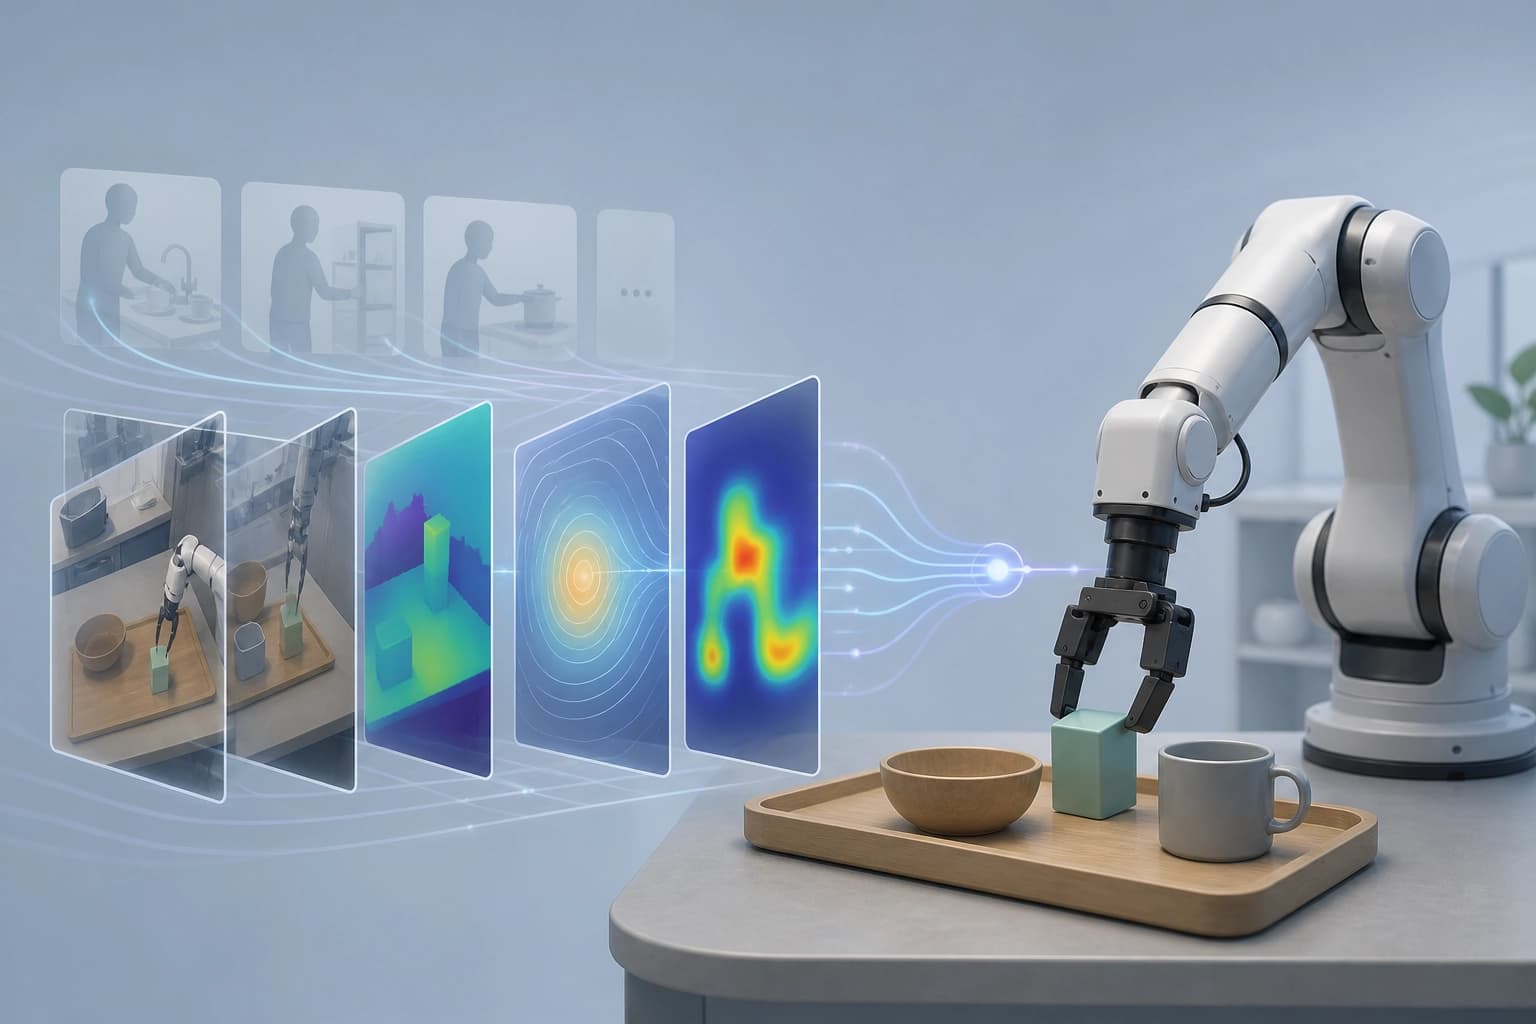
arXiv:2609.22332 প্রবন্ধে AffordanceWAM উপস্থাপন করা হয়েছে—রোবোটিক ম্যানিপুলেশনের জন্য অ্যাফরড্যান্স-সচেতন জেনারেটিভ World Action Model। প্রথম সংস্করণটি জমা দেওয়া হয়েছিল 16 Sep 2026-এ। সর্বশেষ উল্লেখিত সংস্করণ হলো v3, সংশোধিত 18 Oct 2026-এ। মডেলটি বস্তু-কেন্দ্রিক স্থানিক-কালিক অ্যাফরড্যান্স উপস্থাপন করে। এটি দুটি ফরম্যাট ব্যবহার করে:
- Scalar Affordance;
- Affordance Heatmap.
এই উপস্থাপনাগুলো জেনারেট করা ভবিষ্যৎ World-এর অংশ। অ্যাফরড্যান্স দৃশ্যের ভিজ্যুয়াল পূর্বাভাসকে কাজের জন্য প্রাসঙ্গিক বস্তু ও মিথস্ক্রিয়ার অঞ্চলগুলোর সঙ্গে যুক্ত করে। এগুলো মানুষ ও রোবটের ভিডিওতে মিথস্ক্রিয়ার জন্য একটি অভিন্ন ভিত্তি হিসেবে কাজ করে। এভাবে অ্যাফরড্যান্স দৃশ্যের পূর্বাভাস এবং ম্যানিপুলেটর নিয়ন্ত্রণের মধ্যবর্তী সংযোগ হিসেবে কাজ করে।
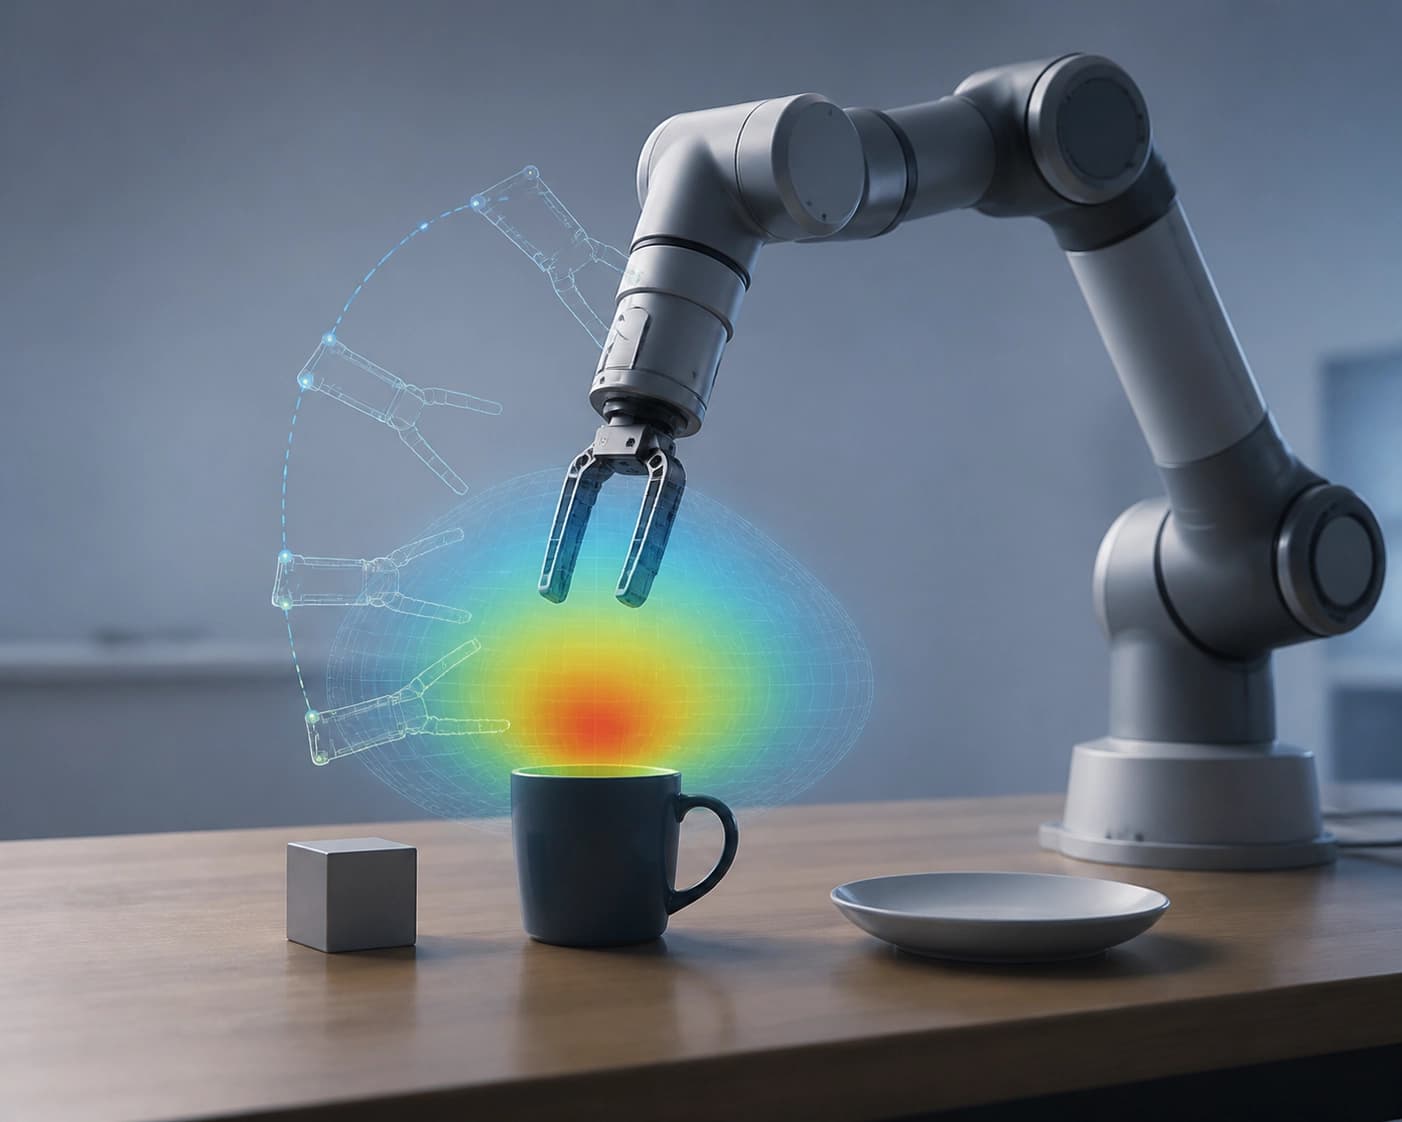
উপসংহার: মডেলটি বস্তু ও ক্রিয়ার অঞ্চলের জন্য একটি স্পষ্ট ফরম্যাট দেয়। এই ফরম্যাট ভবিষ্যতের পূর্বাভাসকে নিয়ন্ত্রণের সঙ্গে যুক্ত করে।
আর্কিটেকচার: দুটি এক্সপার্ট এবং একটি অভিন্ন উদ্দেশ্য
AffordanceWAM-এর ভিত্তি হলো প্রাক-প্রশিক্ষিত video diffusion Transformer। মডেলটি পৃথকভাবে প্যারামিটারযুক্ত World Expert এবং Action Expert ব্যবহার করে। Masked Joint Self-Attention তাদের সংযুক্ত করে।
| উপাদান | প্রবন্ধে বর্ণিত ভূমিকা |
|---|---|
| World Expert | পৃথকভাবে প্যারামিটারযুক্ত বিশ্ব-বিষয়ক এক্সপার্ট |
| Action Expert | পৃথকভাবে প্যারামিটারযুক্ত অ্যাকশন-বিষয়ক এক্সপার্ট |
| Masked Joint Self-Attention | World Expert এবং Action Expert-কে সংযুক্ত করে |
| অভিন্ন flow-matching objective | RGB, অ্যাফরড্যান্স ও অ্যাকশনের পূর্বাভাসকে একত্রিত করে |
মডেলটি যৌথভাবে ভবিষ্যতের RGB পর্যবেক্ষণ, Scalar Affordance fields, Affordance Heatmaps এবং রোবটের অবিচ্ছিন্ন অ্যাকশনের পূর্বাভাস দেয়। এই সব আউটপুটকে অভিন্ন flow-matching objective একত্রিত করে। এক্সপার্টদের পৃথক প্যারামিটার যৌথ প্রশিক্ষণে বাধা দেয় না। তাদের সংযোগ বিশ্ব ও অ্যাকশনের যৌথ পূর্বাভাসকে সমর্থন করে।
উপসংহার: আর্কিটেকচারটি বিশ্ব ও অ্যাকশনের প্যারামিটার আলাদা রাখে। একই সঙ্গে Masked Joint Self-Attention এবং অভিন্ন উদ্দেশ্য যৌথ পূর্বাভাস বজায় রাখে।
মানুষের ভিডিও এবং রোবটের ট্র্যাজেক্টরিতে প্রশিক্ষণ
AffordanceWAM-এর প্রশিক্ষণে ভবিষ্যৎ World-এর তিনটি স্ট্রিমের সবকটির জন্য মানুষের ভিডিও ব্যবহার করা হয়। রোবটের ট্র্যাজেক্টরিগুলো অতিরিক্তভাবে অ্যাকশনের জন্য সুপারভিশন দেয়। এই স্থানান্তরের জন্য মানুষের অ্যাকশনের লেবেল বা রিটার্গেটিংয়ের প্রয়োজন হয় না।
| ডেটার উৎস | প্রশিক্ষণে অবদান |
|---|---|
| মানুষের ভিডিও | ভবিষ্যৎ World-এর তিনটি স্ট্রিমের সবকটিকে প্রশিক্ষণ দেয় |
| রোবটের ট্র্যাজেক্টরি | অতিরিক্তভাবে অ্যাকশনের জন্য সুপারভিশন দেয় |
অ্যাফরড্যান্স মানুষ ও রোবটের ভিডিওতে মিথস্ক্রিয়ার জন্য একটি অভিন্ন ভিত্তি হিসেবে কাজ করে। তাই মানুষের অ্যাকশনের লেবেল ছাড়াই মানুষের ভিডিও ব্যবহার করা যায়। লেখকেরা অ্যাফরড্যান্সকে vision-language-action এবং মানুষ থেকে রোবটে দক্ষতা স্থানান্তরের জন্য একটি কার্যকর ইন্টারফেস হিসেবে বর্ণনা করেছেন।
উপসংহার: অ্যাফরড্যান্স মানুষ ও রোবটের ভিডিওর জন্য একটি অভিন্ন ইন্টারফেস দেয়। এতে মানুষের অ্যাকশনের লেবেল ও রিটার্গেটিংয়ের প্রয়োজন দূর হয়।
পরীক্ষা: উন্নতি এবং ডেটার ওপর নির্ভরতা
লেখকেরা RoboCasa, CALVIN ABC→D এবং বাস্তব ম্যানিপুলেশনে AffordanceWAM পরীক্ষা করেছেন। পরীক্ষায় বেসলাইন পদ্ধতিগুলোর তুলনায় ধারাবাহিক উন্নতি দেখা যায়। বেসলাইন পদ্ধতিগুলো কেবল RGB বা কেবল রোবটের ডেটা ব্যবহার করে।
RoboCasa-তে অ্যাফরড্যান্স দিয়ে অ্যানোটেট করা মানুষের ভিডিওর পরিমাণ বাড়ার সঙ্গে সঙ্গে ফলাফল ধারাবাহিকভাবে উন্নত হয়। রোবটের সুপারভিশনের পরিমাণ স্থির রেখেই এই উন্নতি দেখা যায়। এই প্রভাব প্রশিক্ষণে অ্যাফরড্যান্সের অবদান নির্দেশ করে।
| শর্ত | প্রবন্ধ অনুযায়ী ফলাফল |
|---|---|
| কেবল RGB-ভিত্তিক বেসলাইন | AffordanceWAM-এ ধারাবাহিক উন্নতি |
| কেবল রোবটের ডেটাভিত্তিক বেসলাইন | AffordanceWAM-এ ধারাবাহিক উন্নতি |
| রোবটের সুপারভিশন স্থির রেখে অ্যাফরড্যান্স-সহ মানুষের ভিডিও বাড়ানো | RoboCasa-তে ধারাবাহিক উন্নতি |
নির্বাচনের ব্যবহারিক মানদণ্ড হলো অ্যাফরড্যান্স অ্যানোটেশন-সহ মানুষের ভিডিওর পরিমাণ। রোবটের সুপারভিশন স্থির রেখে এই পরিমাণ বাড়ালে RoboCasa-তে ধারাবাহিক উন্নতি হয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ফাইন-টিউনিং ছাড়াই উৎসের SQL উপস্থাপনার মাধ্যমে LLM-এর হ্যালুসিনেশন যাচাই করা
এই গবেষণায় যাচাই করা হয়েছে, হ্যালুসিনেশন শনাক্তকরণে তত্ত্বাবধান ছাড়াই উৎসের সঙ্গে সংযোগ স্থাপনের জন্য LLM কি একটি মৌলিক প্রতীকী দক্ষতা—উৎস নথি থেকে SQL ডেটাবেস তৈরি—ব্যবহার করতে পারে। RAGTruth ও DiaHalu-তে এই নিউরো-সিম্বলিক পাইপলাইনটি সরাসরি পূর্বাভাসের চেয়ে বেশি নির্ভুল এবং অত্যাধুনিক পদ্ধতিগুলোর সঙ্গে তুলনীয়, অথচ বিষয়ভিত্তিক সূক্ষ্ম-টিউনিংয়ের প্রয়োজন হয় না।
9 নভেম্বর 2026
MathAdv: মেশিন-উৎপন্ন প্রমাণের চূড়ান্ত নির্ভুলতার আড়ালে কী লুকিয়ে আছে
গণিতের ১৩টি বিশ্ববিদ্যালয় ও স্নাতকোত্তর শাখার কাজ নিয়ে তৈরি এই ডায়াগনস্টিক সেটটি Lean 4-এ মেশিন প্রুফ সিস্টেমকে শুধু চূড়ান্ত ফলাফলের ভিত্তিতে নয়, বিষয়জ্ঞান, অনানুষ্ঠানিক যুক্তির গুণমান এবং শর্তাবলি নতুনভাবে উপস্থাপন করা হলে তা সামাল দেওয়ার সক্ষমতার ভিত্তিতেও মূল্যায়ন করে। উপাদানভিত্তিক বিশ্লেষণে দেখা যায়, কোনো সমস্যাকে আনুষ্ঠানিক রূপে রূপান্তর করা এখনও প্রধান বাধা; আর সাফল্য গণিতের শাখা ও সমস্যা উপস্থাপনের পদ্ধতির ওপর অনেকটাই নির্ভর করে।
9 নভেম্বর 2026
নিয়ন্ত্রিত অপারেশন হিসেবে প্রেজেন্টেশন সম্পাদনা: EditPPT ফ্রেমওয়ার্ক এবং DeckEdit-Bench বেঞ্চমার্ক
লেখকেরা কোডের অবাধ জেনারেশনের বদলে স্লাইড সম্পাদনাকে নির্দিষ্ট অবজেক্ট, অনুমোদিত কার্যকলাপ এবং বাইরের বিষয়বস্তু অপরিবর্তিত রয়েছে কি না তা যাচাই করার ভিত্তিতে বিশ্লেষণ করেছেন। গুণমান পরিমাপের জন্য তৈরি করা হয়েছে DeckEdit-Bench (মানুষের তৈরি 28টি প্রেজেন্টেশনে 183টি কাজ), আর পাঁচটি বেস মডেলে মাল্টি-এজেন্ট পদ্ধতি EditPPT 97%-এর বেশি বিষয়বস্তু অক্ষত রেখে 66,7–74,9% কাজ সফলভাবে সম্পন্ন করে।
8 নভেম্বর 2026