
الناس مفهومون، لكن نماذج اللغة الكبيرة ليست كذلك: الخبراء لم يتمكنوا من تفسير منطق النماذج
قارن الباحثون العوامل الخفية الكامنة وراء إجابات البشر وستة نماذج لغوية على مهام الاستدلال الكمي والكيمياء. العوامل المستخلصة من إجابات البشر نجح الخبراء في تفسيرها، بينما تبين أن معظم البنى النموذجية كانت غير شفافة بالنسبة لهم.
الناس مفهومون، والنماذج اللغوية الكبيرة ليست كذلك: الخبراء لم يتمكنوا من تفسير منطق النماذج
عندما ننظر إلى نتائج الاختبارات، يبدو من الطبيعي افتراض أن الذكاء الاصطناعي يحل المهام "مثل الإنسان": يستخدم نفس المفاهيم والقواعد والاستدلالات. ومع ذلك، فإن دراسة جديدة تلقي بظلال الشك على هذا الافتراض. اكتشف العلماء أن البنى الخفية التي تحدد إجابات النماذج اللغوية الكبيرة، في معظم الحالات، لا تخضع للتفسير البشري — حتى لدى الخبراء المتخصصين.
ما الذي تم فحصه بالضبط
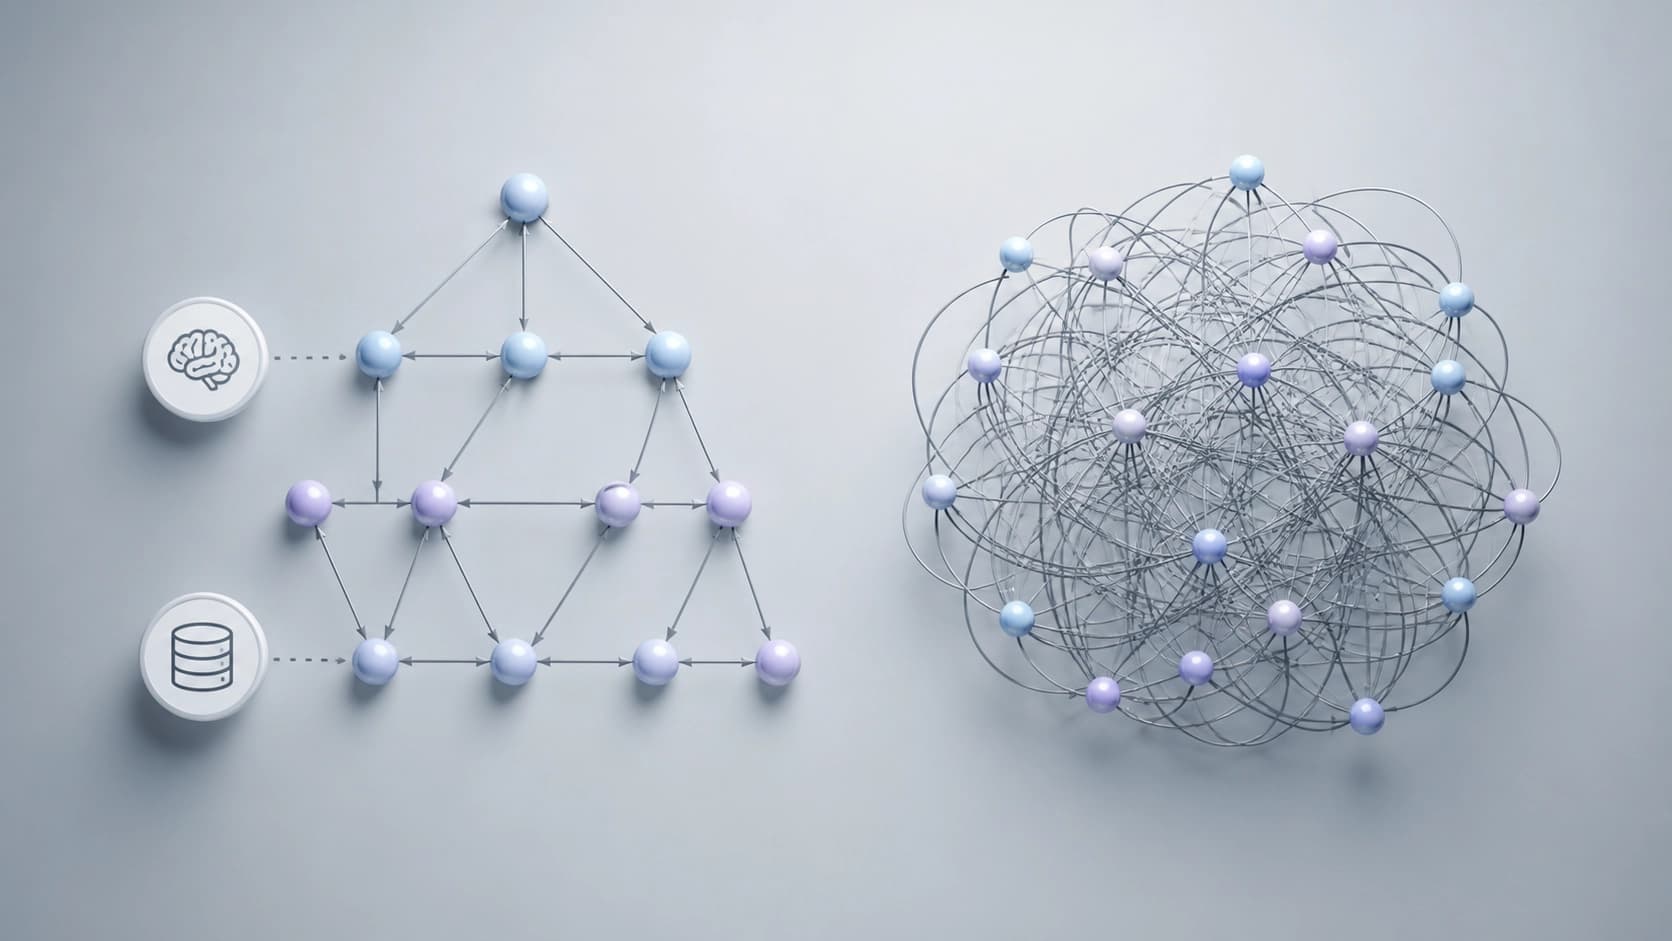
مؤلفو العمل (arXiv:2608.17810) — ألونا ستروغاتسكي، ليكول زينفيلد، جيسون كوبر وزملاؤهم — أخذوا إجابات البشر وستة نماذج لغوية كبيرة مختلفة على مهام في الاستدلال الكمي والكيمياء. وباستخدام التحليل العاملي الاستكشافي، حددوا لكل مجموعة عوامل كامنة خفية يُفترض أنها تقف وراء نجاح أداء هذه المهام.
ثم درس الخبراء المتخصصون البنى الناتجة بشكل أعمى وحاولوا إسناد معنى تربوي للعوامل: على سبيل المثال، "القدرة على التعامل مع الصيغ" أو "فهم القياس الكيميائي". استبعد الشكل الأعمى أي تلميحات — لم يكن المتخصصون يعرفون ما إذا كانت الرسوم البيانية تتعلق بالبشر أم بالنماذج.
النتيجة: فجوة في قابلية التفسير
تمكن الخبراء دون أي مشاكل تقريبًا من فهم العوامل المستخلصة من الإجابات البشرية. حصلت معظم البنى على تفسير ذي معنى، كان من السهل تحويله إلى توصيات للتعليم أو التشخيص.
أما مع النماذج اللغوية الكبيرة، فكانت الصورة مختلفة:
- في الاستدلال الكمي، لم يتمكن الخبراء من تفسير أي عامل بشكل ذي معنى من العوامل المحددة للنماذج.
- في الكيمياء، كان الوضع أفضل قليلاً، لكنه ظل بعيدًا عن المثالية: لم يُفسَّر سوى حوالي نصف البنى.
ما معنى هذا
يتوصل المؤلفون إلى استنتاج مهم: عندما تُظهر النماذج اللغوية الكبيرة نتائج عالية في الاختبارات، فهذا لا يعني أنها تستدل بالطريقة المألوفة لدينا. قد تجد النماذج طرقًا فعالة إحصائيًا، لكنها "غريبة" تمامًا عن الإنسان، لحل المهام. آلياتها الداخلية تعمل على مستوى الأنماط التي لا تحمل معنى تربويًا أو معرفيًا مفهومًا.
هذه الملاحظة تتحدى الممارسة الشائعة المتمثلة في محاولة استخلاص استنتاجات حول مستوى المعرفة أو الكفاءات من نتائج الذكاء الاصطناعي. إذا لم نتمكن من شرح البنى التي تقف وراء الإجابات، فإننا نخاطر بنسب قدرات غير موجودة إلى النماذج — أو على العكس، تفويت القيود الحقيقية.
إلى أين نتجه من هنا
لا تدعي الدراسة أن تفسير النماذج اللغوية الكبيرة مستحيل من حيث المبدأ. إنها تُظهر فقط أن النهج الكلاسيكي، المصمم لدراسة الإدراك البشري، لا يُنقل إلى النماذج مباشرة. ربما سيكون من الضروري تطوير طرق تحليل جديدة جذريًا — تلك التي تراعي الطبيعة "غير البشرية" للبنى الكامنة.
في الوقت الحالي، يبقى السؤال مفتوحًا: إذا كان الخبراء لا يستطيعون تفسير منطق النماذج، فهل يمكننا الاعتماد على استخدامها في التعليم وتقييم المعرفة؟ الإجابة، على الأرجح، ستتطلب إعادة نظر في كل من مناهج اختبار الذكاء الاصطناعي وتوقعاتنا من "ذكاء" الآلات.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التحقق من المرشحين أغلى من توليدهم: طُعوم لمواجهة البحث عن الثغرات باستخدام النماذج اللغوية الكبيرة
يتناول العمل عدم التكافؤ في تكلفة البحث الوكيلي عن العيوب: فتوليد النسخ رخيص، بينما يتطلب تأكيدها عبر تحليل إمكانية الوصول والتنفيذ وإثبات المفهوم الجزء الأكبر من الميزانية، ما يجعل التحقق هدفًا دفاعيًا مستقلًا. وقد خفّض RedHerring المقترح — وهو طُعم قابل للتكيّف مع المستودع ومزوّد بشهادة مخفية — عدد الثغرات الحقيقية المكتشفة بنسبة 38,7–60,4% في 33 مشروعًا ضمن OSS-Fuzz، مع تساوي التكاليف؛ وحتى بعد تحذير الوكيل، ظل الانخفاض عند 37,2%.
9 نوفمبر 2026
التحقق من هلوسات LLM عبر عرض المصادر باستخدام SQL، دون إعادة تدريب
تبحث الدراسة فيما إذا كان بإمكان نموذج لغوي كبير توظيف مهارة رمزية أساسية — إنشاء قاعدة بيانات SQL من المستندات المصدرية — للاستدلال على المصدر دون إشراف عند كشف الهلوسات. ويحقق هذا المسار العصبي الرمزي على مجموعتي RAGTruth وDiaHalu دقة أعلى من التنبؤ المباشر، ويضاهي أحدث الأساليب دون الحاجة إلى ضبط دقيق بحسب المجال.
9 نوفمبر 2026
MathAdv: ما الذي تخفيه الدقة النهائية للبراهين الآلية
تقيّم مجموعة مهام تشخيصية تغطي 13 فرعًا جامعيًا ودراسات عليا في الرياضيات أنظمة البرهنة الآلية في Lean 4، ليس من حيث النتيجة النهائية فحسب، بل أيضًا من حيث الإلمام بالمادة وجودة الاستدلال غير الرسمي والقدرة على التعامل مع إعادة صياغة الشروط. ويُظهر التحليل التفصيلي أن تحويل المسألة إلى صيغة رسمية لا يزال العقبة الأبرز، وأن النجاح يعتمد بشدة على فرع الرياضيات وطريقة صياغة المسألة.
9 نوفمبر 2026