
تتحكم النماذج الحركية VLA بإشارات المرور: نموذج VLALight يستنبط الأفعال مباشرةً من فيديو كاميرات الطرق
يقدّم الباحثون VLALight، وهو نموذج شامل من فئة «الرؤية واللغة والفعل» يحوّل تسجيلات متعددة المناظير من كاميرات التقاطعات مباشرةً إلى تبديلات إشارات المرور، متجاوزًا الحالات المُعرّفة يدويًا لتدفّق حركة المرور. ويرتكز على الإدراك المشترك المراعي لطوبولوجيا التقاطع، والتعلّم المعزّز على مستوى شبكة المدينة، والاختيار التكيّفي بين الاستدلال السريع والعميق؛ وقد تفوّق الحل على خطوط الأساس المعتمدة على نماذج حركة المرور والتعلّم المعزّز وLLM/VLM، في سبع مجموعات بيانات واقعية من ثلاث مدن.
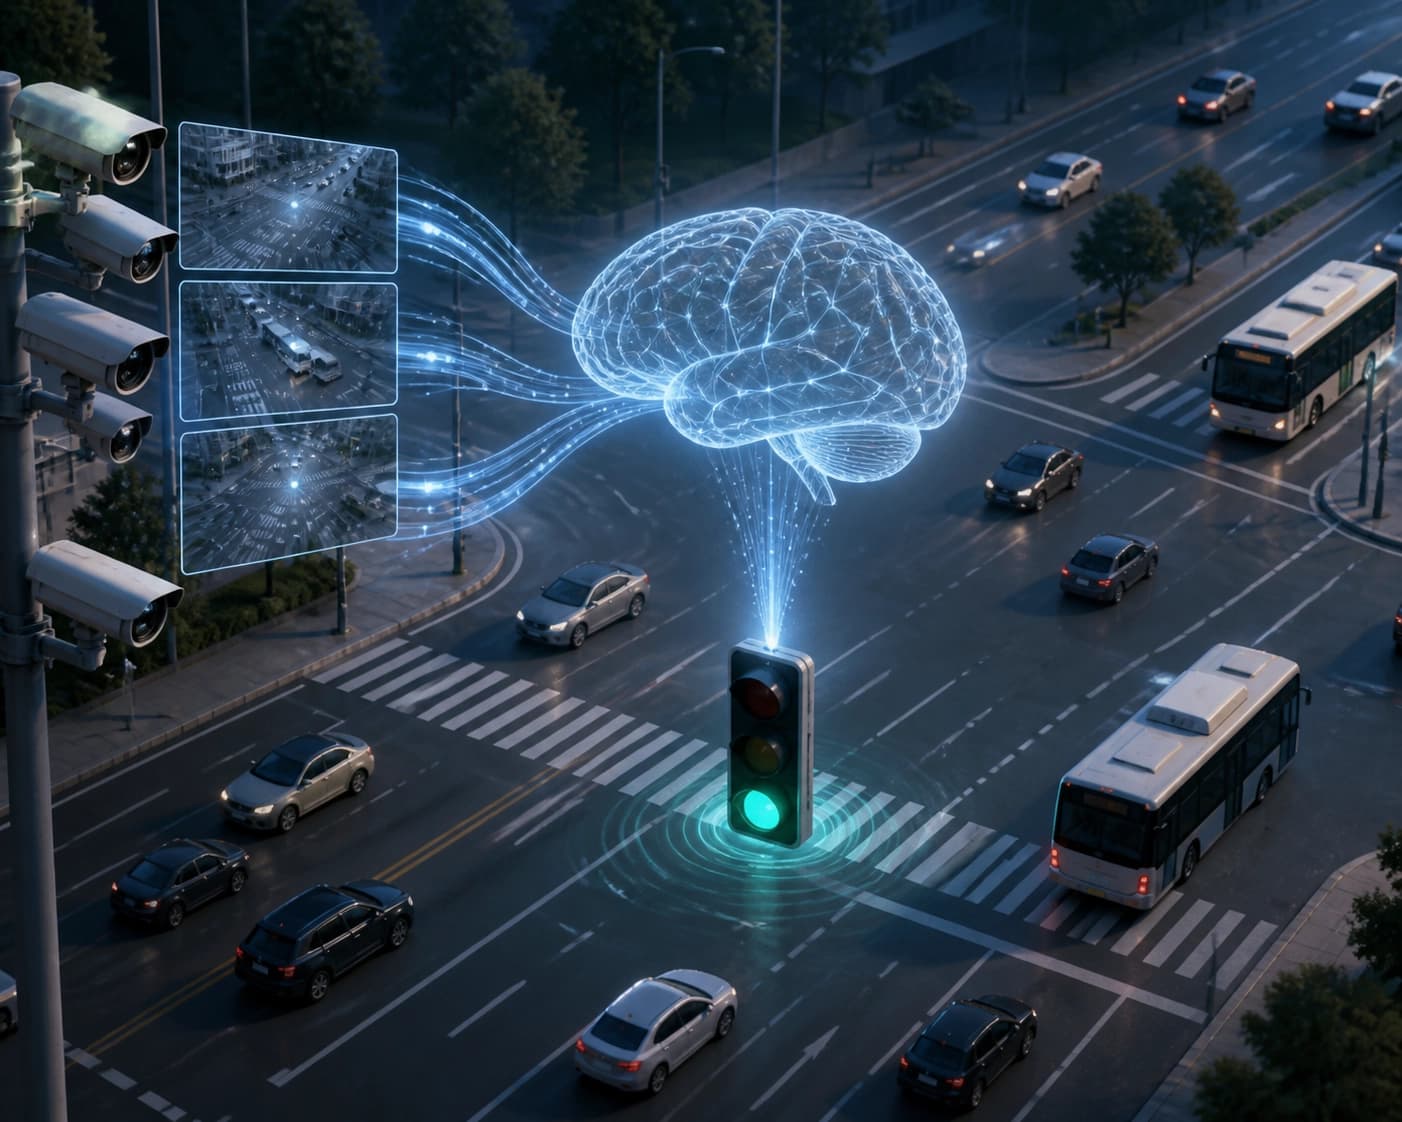
ما نموذج VLA للتحكم في إشارات المرور
VLALight هو نموذج للرؤية واللغة والفعل للتحكم في إشارات المرور. المؤلفون: Pan Zhang وSiqi Lai وKemu Dong وHao Liu. قُدّمت الورقة في 29 سبتمبر 2026. وهو أول نموذج VLA للتحكم الشامل في إشارات المرور استنادًا إلى فيديو متعدد المناظير من كاميرات على جوانب الطرق.
يحوّل النموذج الملاحظات البصرية مباشرةً إلى إجراءات متناسقة لإشارات المرور. ويستخدم الاستدلال المكاني والزماني بشأن أهداف متعددة. كما يراعي طوبولوجيًا الإدراك المشترك عند التقاطعات.
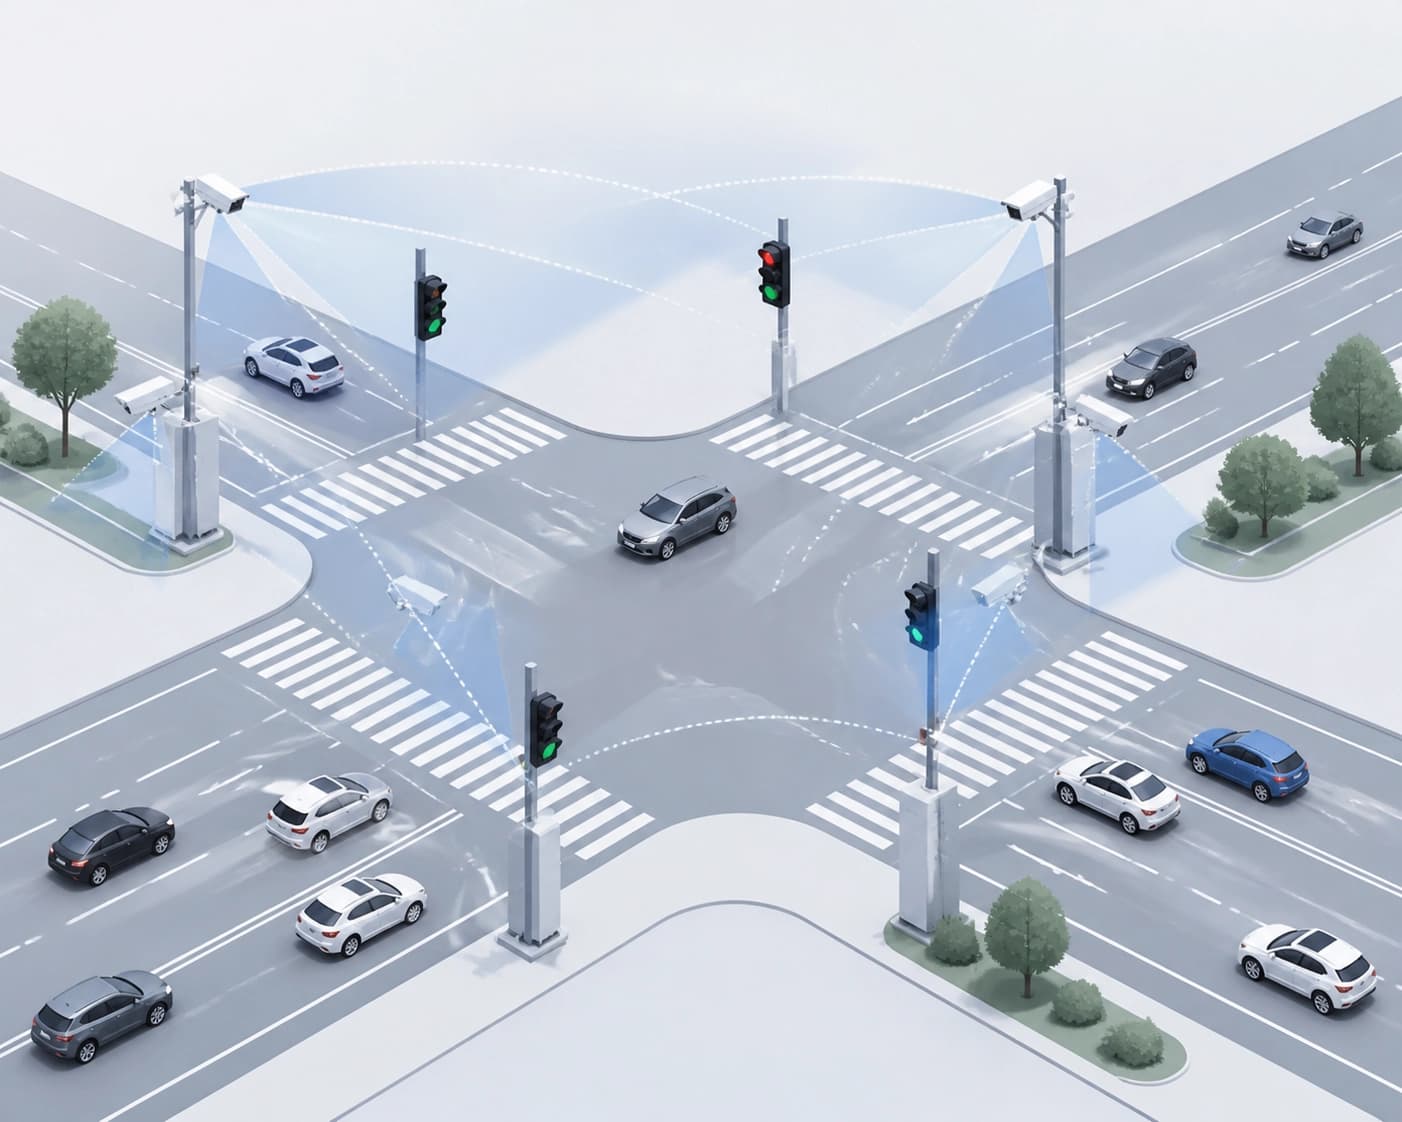
الخصائص الرئيسية للنهج:
- الاستدلال الشامل: تتحول الملاحظات البصرية إلى إجراءات لإشارات المرور.
- فيديو متعدد المناظير: تأتي البيانات من كاميرات على جوانب الطرق.
- الاستدلال المكاني والزماني: يراعي النموذج أهدافًا متعددة.
- المراعاة الطوبولوجية: الإدراك المشترك عند التقاطعات.
معيار الاختيار: يجمع نهج VLA بين الإدراك والتحكم في نموذج واحد. وهذا ما يميّزه عن الأساليب التي تفصل بين هاتين المهمتين. ويُعد الربط الشامل بين الفيديو والإجراءات المعيار الرئيسي.
كيفية تدريب VLALight: مرحلتان
يشمل تدريب VLALight استراتيجية من مرحلتين. أولًا، يُطبَّق supervised cold-start، وهو يطوّر الفهم البصري لمشهد الطريق واتخاذ القرارات بشأن الإشارات. ثم يبدأ cooperative agentic reinforcement learning.
تحسّن المرحلة الثانية التحكم المحلي وكفاءة شبكة النقل ككل بصورة مشتركة. وتُعنى المرحلة الأولى بفهم المشهد والإشارات. أما المرحلة الثانية فتحسّن التحكم المحلي والشبكة.
| المرحلة | المهمة | ما الذي تحسّنه |
|---|---|---|
| Supervised cold-start | الفهم البصري لمشهد الطريق واتخاذ القرارات بشأن الإشارات | المهارات الأولية للنموذج |
| Cooperative agentic reinforcement learning | التحسين المشترك | التحكم المحلي وكفاءة الشبكة |
معيار الاختيار: التحقق مما إذا كان النهج يتضمن تحسينًا مشتركًا على مستوى الشبكة. فالقرارات المحلية دون سياق الشبكة تحدّ من الأثر. ويفصل التدريب على مرحلتين بين تعلّم الإدراك وضبط التفاعل.
أنماط الاستدلال التكيفية وتكلفة الاستدلال
يستخدم VLALight أنماطًا تكيفية للاستدلال السريع والبطيء. ولا يُستخدم الاستدلال الأعمق إلا عندما يحقق فائدة كافية للتحكم. ويستخدم النموذج mode-aware rollouts متوازنة وrelative advantage optimization. ويتعلم النموذج إيجاد توازن بين جودة القرارات وتكلفة الاستدلال.
| النمط | شرط التفعيل | الأثر |
|---|---|---|
| سريع | لا يحقق الاستدلال الأعمق فائدة كافية | تكلفة استدلال أقل |
| بطيء | يحقق الاستدلال الأعمق فائدة كافية | قرارات أفضل جودة |
معيار الاختيار: التوازن بين جودة القرارات وتكلفة الاستدلال. ينبغي أن يتغير النمط بحسب فائدته للتحكم. فالعمل باستمرار بأقصى عمق يزيد التكلفة.
ما الذي أظهرته التجارب
أُجريت التجارب على سبع مجموعات بيانات لتدفق حركة المرور في العالم الحقيقي. وهي تغطي ثلاث شبكات حضرية. وتفوّق VLALight على الأساليب الأساسية، ومنها نماذج النقل والتعلّم المعزز وLLM/VLM.
| فئة الأساليب الأساسية | دورها في المقارنة |
|---|---|
| نماذج النقل | خط أساس |
| التعلّم المعزز | خط أساس |
| LLM/VLM | خط أساس |
أكدت دراسات الاستئصال فعالية الإدراك المشترك والتحسين على مستوى الشبكة والاستدلال التكيفي. ويشير المؤلفون إلى إمكانات نماذج VLA في التحكم بأنظمة النقل المادية في العالم الحقيقي.
معيار الاختيار: التحقق من فئات الأساليب الأساسية ووجود دراسات الاستئصال. تغطي التجارب تدفقًا مروريًا حقيقيًا وثلاث شبكات حضرية. وينبغي التحقق من مساهمة كل مكوّن على حدة.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
وسم الصور الهجين: تُسرّع الأتمتة تدريب نماذج الرؤية الحاسوبية
توضح المقالة كيف تُقلّل الوسوم الأولية التي تضعها الخوارزميات من العمل اليدوي وتحسّن جودة مجموعات بيانات التدريب، ولماذا يظل التحقق البشري الانتقائي ضروريًا. كما تستعرض حدود هذه الطريقة في ظروف التصوير الصعبة وعند التعامل مع أنواع الأجسام النادرة.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026