
كيفية تدريب تجزئة اللغة في الموجات فوق الصوتية عندما تكون البيانات المصنفة شبه معدومة
اقترح الباحثون طريقة لتكييف النموذج مع مجموعة جديدة من صور الموجات فوق الصوتية دون الوصول إلى البيانات الأصلية: فهي تجمع بين تحسين التوسيم شبه التلقائي، ومراقبة جودة الخطوط، والتوليد الاصطناعي للصور بأسلوب المجال المستهدف. يحسّن هذا النهج دقة التقسيم بشكل ملحوظ حتى عند البدء بخمسة إطارات موسومة فقط.
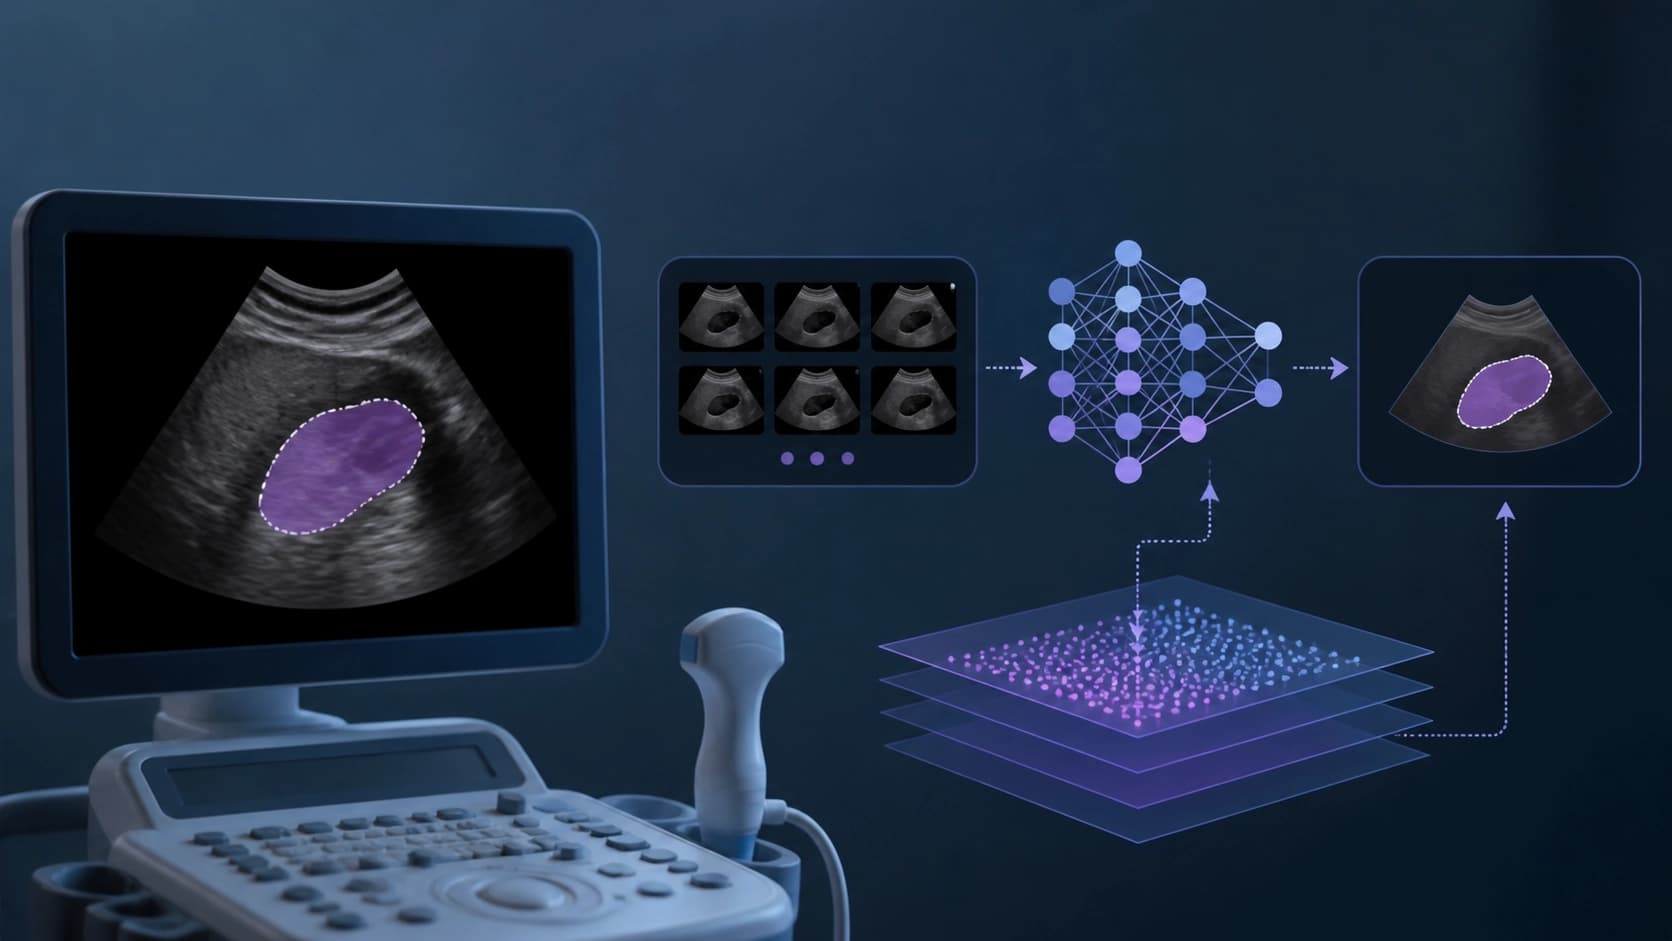
تجزئة الصور فوق الصوتية للسان ضرورية لتحليل النطق وتشخيص اضطرابات الكلام، لكن جمع البيانات المصنّفة أمر صعب: يتطلب خبراء، والصور نفسها تختلف كثيراً من جهاز لآخر. عندما تكون المواد المصنّفة شبه معدومة، لا يعمل التدريب القياسي للشبكة العصبية: النموذج يحفظ خصائص مصدر معين ولا يعمّم على الظروف الجديدة.
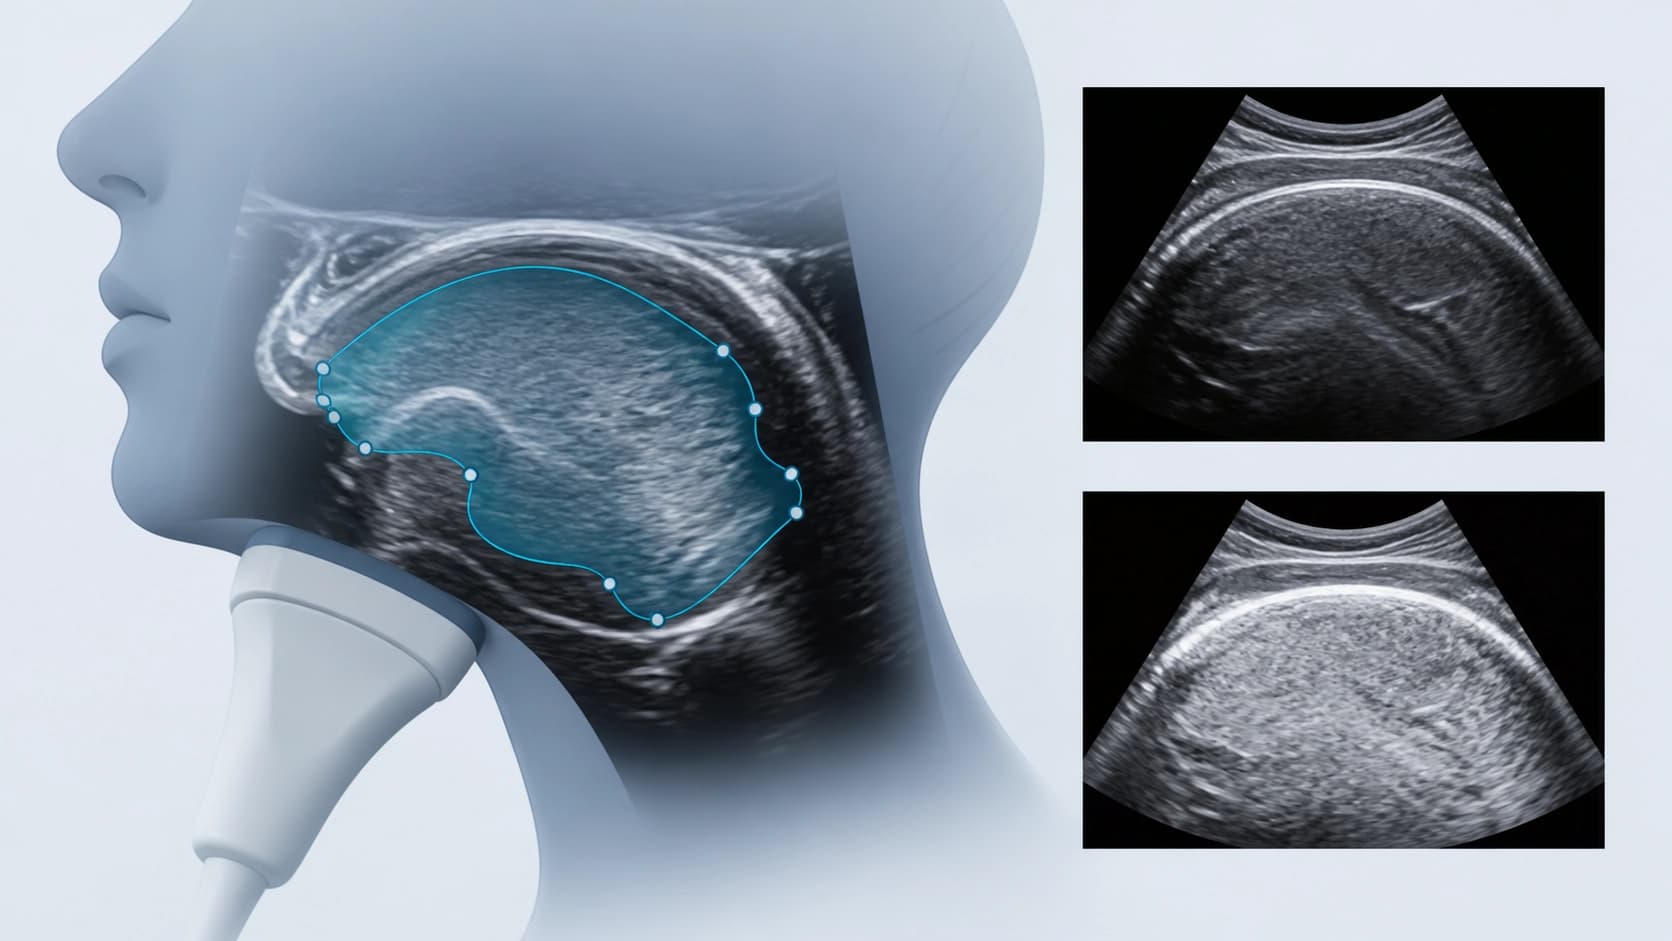
لماذا هذا صعب
المشكلة ليست فقط في قلة التسميات التوضيحية. بيانات الموجات فوق الصوتية للسان تُجمع بأجهزة استشعار مختلفة، وبإعدادات مختلفة، ومن أشخاص مختلفين، لذا فإن توزيع الصور في كل مجموعة جديدة يختلف. هذا يُسمى انزياح النطاق (domain shift). إذا درّبت نموذجاً على مجموعة واحدة وطبّقته على أخرى، تنخفض جودة التجزئة بشكل حاد. الطرق الكلاسيكية للتكيف تتطلب الوصول إلى بيانات مصنّفة من النطاق المصدر، لكن في المهمة الحقيقية غالباً ما يتوفر فقط نموذج مُدرَّب مسبقاً وصور غير مصنّفة من النطاق الجديد.
الفكرة: تكيّف بدون مصدر (source-free adaptation)
يقترح مؤلفو دراسة حديثة إطار عمل يكيّف النموذج مع نطاق جديد تماماً دون بيانات مصنّفة ودون الوصول إلى الصور الأصلية. الأساس هو عمود فقري خفيف UltraUNet، مُدرَّب مسبقاً على خمس صور مصنّفة فقط. هذه نقطة بداية ضعيفة عمداً — تحاكي حالة يكون فيها النموذج غير مكتمل التدريب بسبب نقص البيانات. بعد ذلك يحدث التكيف مع النطاق المستهدف، حيث لا توجد أمثلة مصنّفة إطلاقاً.
تسميات شبه-مصنّفة مع فلترة
أولاً، يقوم النموذج بعمل تنبؤات على الصور المستهدفة. هذه الأقنعة التقريبية تُسمى تسميات شبه-مصنّفة (pseudo-labels). لكن لا يمكن الوثوق بها جميعاً: جزء من الخطوط سيكون غير دقيق أو خاطئ تماماً. لذلك يستخدم الإطار وحدة خاصة لمراقبة جودة الخطوط، تقوم باستبعاد الأقنعة غير الموثوقة. التسميات شبه-المصنّفة النظيفة المتبقية تُستخدم في التدريب. تتكرر العملية بشكل تكراري — مع كل دورة تتحسن جودة التسميات، ويتكيف النموذج بشكل أفضل مع النطاق المستهدف.
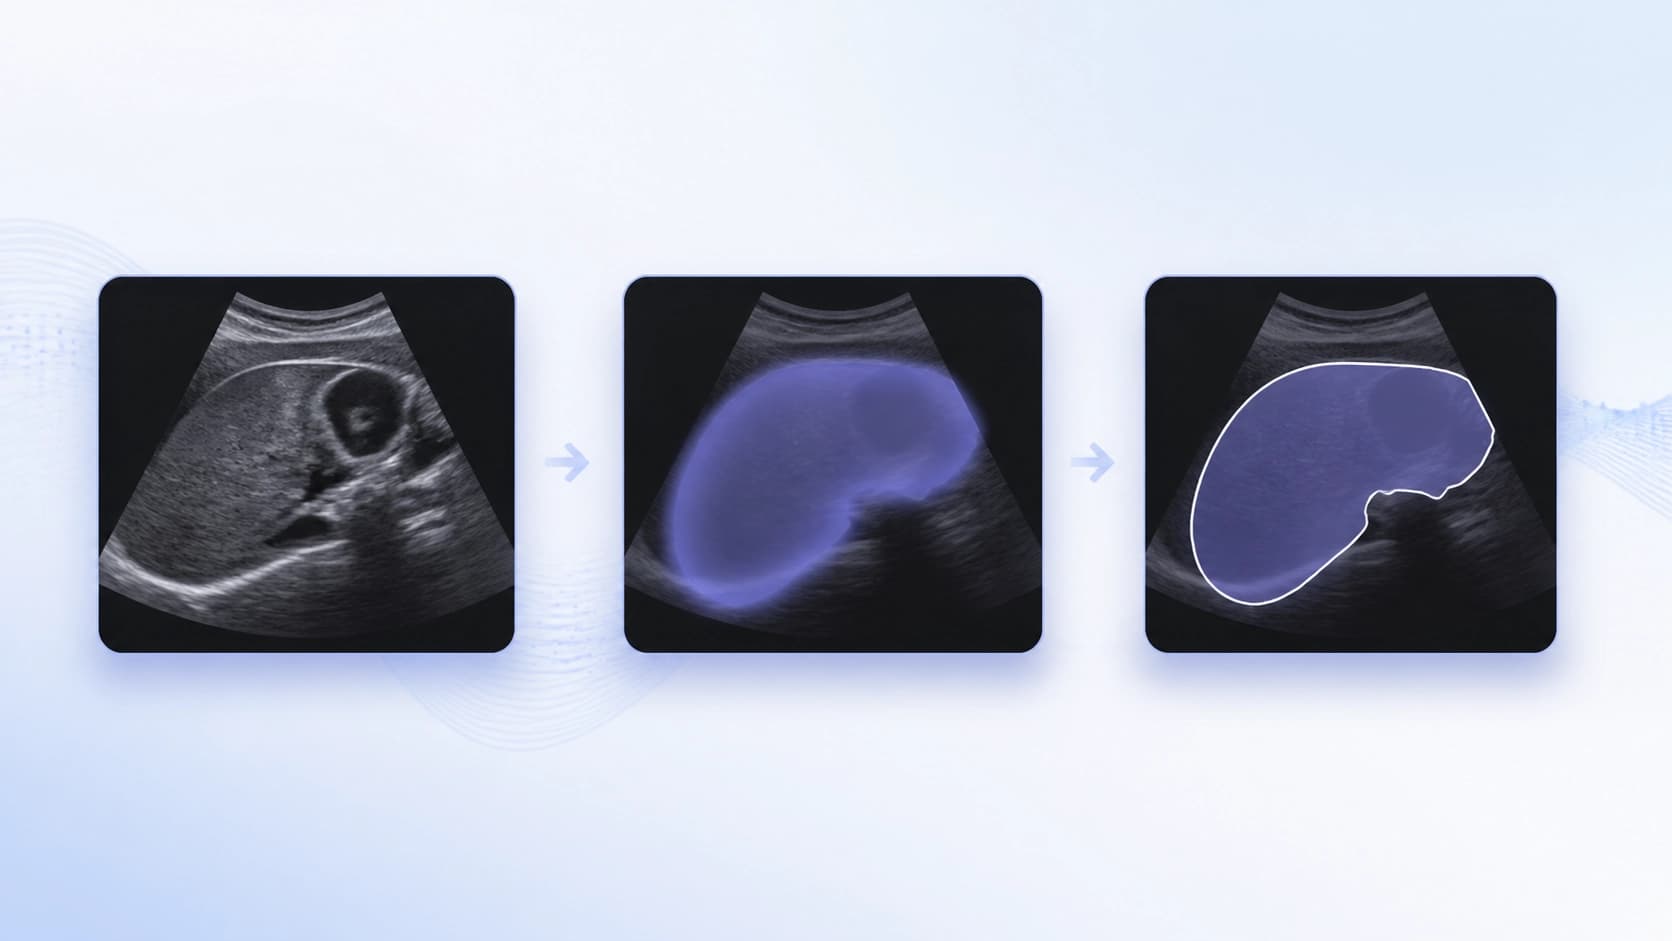
بيانات اصطناعية بأسلوب النطاق المستهدف
بالإضافة إلى ذلك، تُستخدم شبكة GAN شرطية موجهة بالتجزئة لتوليد أزواج اصطناعية «صورة-قناع» بأسلوب النطاق المستهدف. هذا يشبه التوسيع (augmentation)، لكن البيانات تُنشأ ليس بتحولات عشوائية، بل خصيصاً لأسلوب النطاق الجديد. يتم تدريب النموذج الطالب على مزيج من ثلاثة مصادر: الصور المستهدفة ذات التسميات شبه-المصنّفة النظيفة، والتسميات شبه-المصنّفة المزعجة مع تنظيم الاتساق، والعينات الاصطناعية المولّدة. هذا المزيج يجعل النموذج مقاومة للأخطاء ويساعدها على عدم الإفراط في التكيف مع الضوضاء.
النتائج
تم اختبار الطريقة على 12 زوجاً «مصدر-هدف»، مكوّنة من ثماني مجموعات بيانات للموجات فوق الصوتية للسان. في جميع التجارب، تفوق الإطار المقترح على الأساليب الأساسية، بما في ذلك التدريب الخاضع للإشراف العادي على بيانات محدودة. تحسّن كل من تداخل التجزئة (overlap) ودقة الخطوط. يستنتج المؤلفون أن تحسين التسميات شبه-المصنّفة والتوسيع الاصطناعي بأسلوب النطاق المستهدف هما المكوّنان الأساسيان اللذان يسمحان بالتكيف شبه دون تصنيف.
هذا النهج يفتح مساراً عملياً: يكفي تدريب نموذج مرة واحدة على مجموعة صغيرة، ثم تكييفه تدريجياً مع الظروف الجديدة — جهاز استشعار جديد، أو وضع مختلف للمستشعر، أو فئات مختلفة من المرضى — دون الحاجة إلى تصنيف يدوي شاق.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
OpenCollab: تنسيق قابل للبرمجة للوكلاء، وبيئة تنفيذ خاضعة للرقابة، ومقياس للامتثال للوائح
يجمع إطار العمل بين تحديد بنية تفاعل الوكلاء، وبيئة مشتركة للتجارب، والتتبّع التفصيلي للأحداث، فيما يعكس مقياس Adherence المستحدث مدى توافق التنفيذ الفعلي مع المخطط المعلن. في الاختبارات المعيارية، يرتقي إعداد Duo إلى مستوى جديد من SOTA، بينما يتميز البديل أحادي الوكيل بأقل استهلاك للرموز.
11 نوفمبر 2026
Toollery: اختيار الأدوات لوكلاء LLM من بين عشرات الآلاف من الخيارات دون إعادة تدريب
ينشئ Toollery فهرسًا للبحث في أوصاف المهارات والأدوات، وعند تلقي طلب يمرّر إلى النموذج مجموعة محدودة فقط من الخيارات المرشحة. في تجارب على مكتبات تضم ما يصل إلى عشرات الآلاف من الوظائف، يتيح هذا النهج الحفاظ على جودة الاختيار عند قيمة top-K ثابتة، مع أن الأثر النهائي يعتمد على نمط عبء العمل والتخزين المؤقت لدى مزوّد الخدمة.
11 نوفمبر 2026
التشخيص التدريجي لوكلاء واجهة المستخدم الرسومية أثناء تحليل لوحات المعلومات: معيار DashAct
يقدّم DashAct معيارًا مرجعيًا يضم 348 مسارًا راجعها بشر، ويحلّل عمل وكلاء واجهات المستخدم الرسومية مع لوحات التحكم التفاعلية إلى ثلاث مراحل وأربعة شروط بصرية. وتُظهر النتائج مشكلات مستمرة في التنبؤ بالإجراءات وربطها بالأهداف البصرية، فضلًا عن اعتماد استجابة الوكلاء على الدعم السياقي والمكاني.
11 نوفمبر 2026