
SPARSEUP من Linkup: مُرمِّز متناثر يضم 149 مليون مُعلمة
تتناول المقالة بنية SPARSEUP ونتائجها: 56,4 nDCG@10 على BEIR-13، إلى جانب استدعاء يتجاوز 97% عند استخدامه مع فهرس Seismic في نحو 380 ميكروثانية لكل استعلام. ويشمل التحليل التقنيات التي تحافظ على تباعد المتجهات، ومقارنتها بنماذج أخرى، وشروط التوزيع بموجب Apache 2.0.
ما هذا النموذج وكيفية الوصول إليه
SPARSEUP هو مُرمِّز متفرق مفتوح من Linkup Research، يضم 149 مليون مُعامل. يعتمد على ModernBERT، ومرخّص بموجب Apache 2.0.
الأوزان متاحة على Hugging Face. يمكن تحميل النموذج عبر Transformers أو Sentence Transformers، مع تحديد trust_remote_code=True.
تصف Linkup النموذج بأنه أقوى مُرمِّز متفرق قائم على المفردات تعرفه الشركة، ضمن النماذج التي يقل عدد معاملاتها عن 150 مليونًا.
كيف تعمل التمثيلات المتفرقة
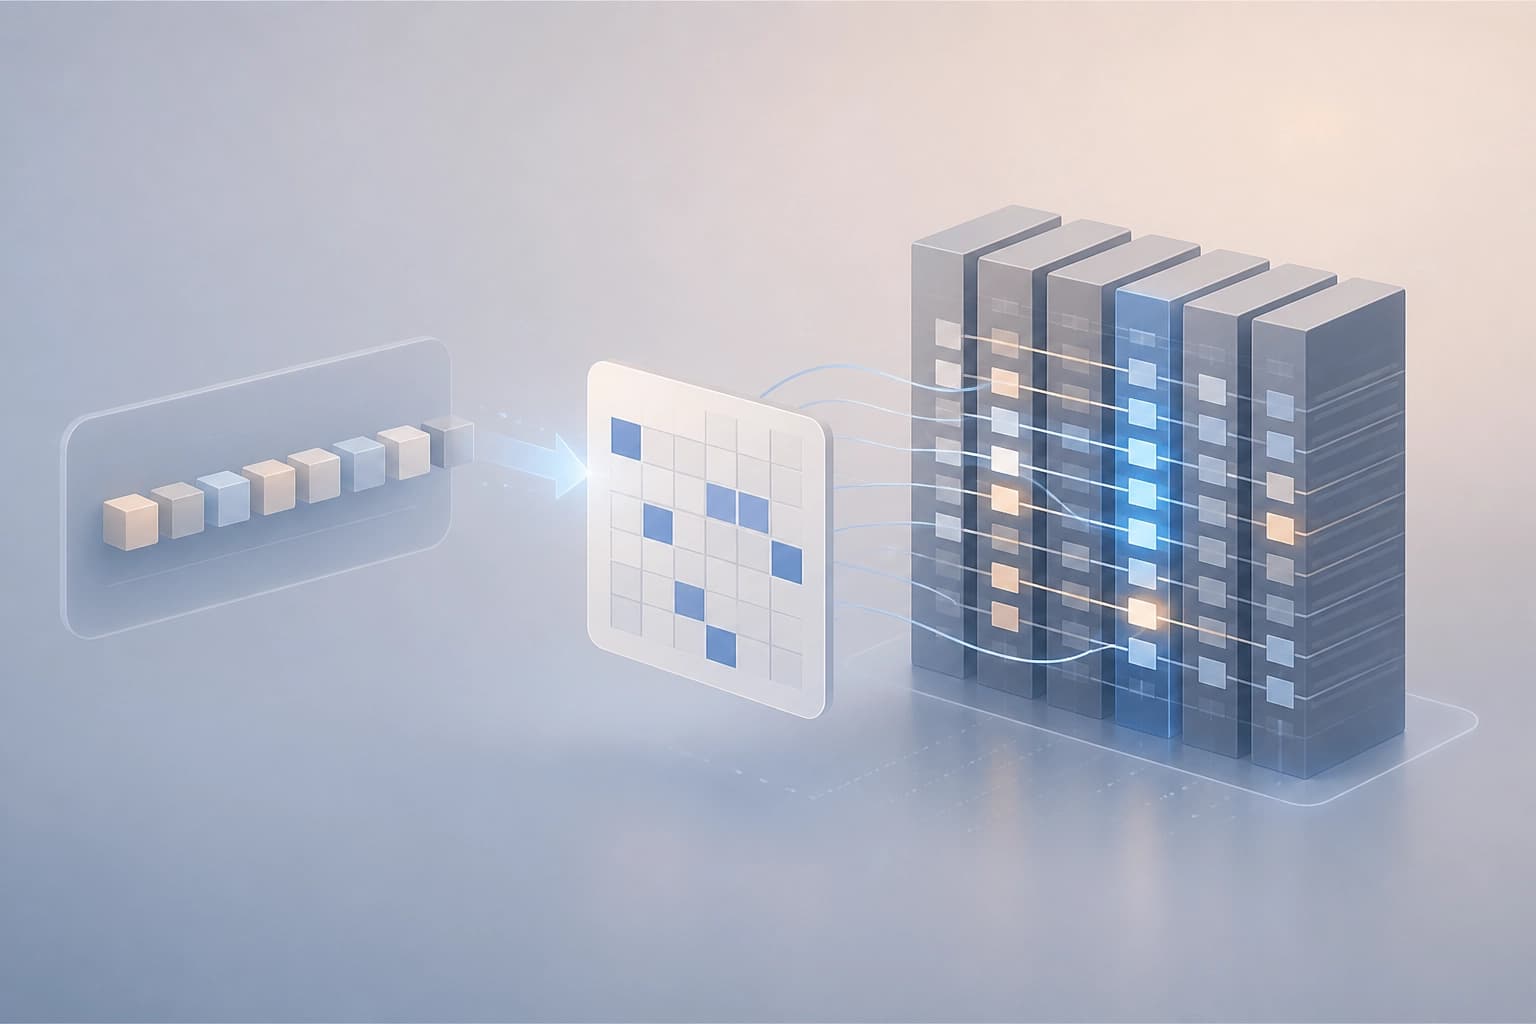
في SPARSEUP، يتوافق كل بُعد في المتجه مع رمز من المفردات. وتناسب هذه المتجهات الفهارس المعكوسة، كما أنها تطابق الكلمات النادرة على نحو أفضل.
يحسب النموذج التنشيطات باستخدام الصيغة log(1 + ReLU(x - 15)). ثم يحتفظ بأقوى 12 بُعدًا لكل رمز إدخال قبل تطبيق max pooling.
يحد ذلك من عدد الأبعاد النشطة لكل رمز، لا من الحجم الإجمالي للمتجه. ويجمع طيّ حالة الأحرف بين صيغ Byte-level BPE، مثل heat وHeat وĠheat وĠHeat، مع الاحتفاظ بأعلى وزن.
بعد الدمج، ينخفض عدد أبعاد المخرجات من نحو 50 ألفًا إلى 34 ألفًا. وتُضاف البادئتان [Q] و[D] إلى الاستعلامات والمستندات؛ ويُحسب التقييم باستخدام الضرب النقطي.
يبلغ الحد الأقصى للطول أثناء التقييم 128 رمزًا للاستعلام و512 رمزًا للمستند. ومن المهم مراعاة هذه الحدود عند ضبط معالجة المدخلات.
كيف دُرّب النموذج
بدأ تدريب SPARSEUP من نقطة التحقق LateOn-unsupervised. وأعاد الفريق رأس MLM الأصلي لـ ModernBERT.
واستخدم الفريق مزيجًا من بيانات LightOn للضبط الدقيق، مع الاقتصار على التدريب التبايني. واختيرت لكل استعلام سبعة أمثلة سلبية صعبة من مجموعة تضم 50 مثالًا، إلى جانب استخدام الأمثلة السلبية داخل الدفعة.
لم يستخدم الفريق تقطير cross-encoder. واكتمل التدريب على وحدة H100 واحدة.
ما الذي تُظهره المقارنات
يبلغ متوسط نتيجة SPARSEUP على BEIR-13، من دون MS MARCO، 56,4 nDCG@10. وتورد بطاقة النموذج النتائج التالية للمُرمِّزات المتفرقة:
| النموذج | BEIR-13، nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
سجّل LACONIC-1B نتيجة 58,7، لكنه ينتمي إلى فئة حجم مختلفة، إذ يضم النموذج مليار مُعامل.
في مقارنة مضبوطة باستخدام العمود الفقري والبيانات نفسيهما، سجّل LateOn نتيجة 58,9، وDenseOn نتيجة 57,9، وSPARSEUP نتيجة 56,4. وتذكر خلاصة الورقة البحثية أن الفارق عن DenseOn يبلغ 1,52 نقطة، وعن LateOn يبلغ 2,5 نقطة.
تفوّق SPARSEUP على DenseOn في ArguAna وHotpotQA، وكان أداؤه أفضل في Touché. لكنه يتأخر على مجموعات البيانات ذات الاستعلامات الأكثر دلالية؛ ويبرز ذلك خصوصًا في FiQA. كما أُشير إلى DBPedia بوصفه نقطة ضعف.
في BEIR بعد إزالة البيانات المتداخلة، ينخفض الفارق عن DenseOn إلى 0,17 نقطة. وبالنسبة إلى NQ وMS MARCO بعد إزالة البيانات المتداخلة، استُخدم 21 و46 استعلامًا فقط على التوالي، لذا تحذّر Linkup من أن النتائج مشوبة بالضوضاء.
التناثر ومعايير الاختيار
على MS MARCO، يستخدم SPARSEUP في المتوسط 47 مصطلحًا غير صفري لكل استعلام و190 لكل مستند. أما SPLADE-v3، فتبلغ الأعداد المذكورة 25 مصطلحًا لكل استعلام و170 لكل مستند.
باستخدام الفهرس المعكوس Seismic، يحقق النموذج أكثر من 97% من recall مقارنةً بالبحث الدقيق، في نحو 380 ميكروثانية لكل استعلام ضمن مسار واحد.
يجدر النظر في SPARSEUP عندما يكون التمثيل المتفرق والبحث عبر فهرس معكوس من الأولويات. وينبغي أيضًا مراعاة نتائجه على مجموعات البيانات المطلوبة عند التقييم: فالنموذج أضعف مع الاستعلامات الدلالية، وعلى FiQA وDBPedia.
ترى Linkup أن زيادة حجم المتجه قد تضيف من 1 إلى 2 نقطة على BEIR. لكن الفريق قرر الحفاظ على تناثر النموذج.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التحقق من المرشحين أغلى من توليدهم: طُعوم لمواجهة البحث عن الثغرات باستخدام النماذج اللغوية الكبيرة
يتناول العمل عدم التكافؤ في تكلفة البحث الوكيلي عن العيوب: فتوليد النسخ رخيص، بينما يتطلب تأكيدها عبر تحليل إمكانية الوصول والتنفيذ وإثبات المفهوم الجزء الأكبر من الميزانية، ما يجعل التحقق هدفًا دفاعيًا مستقلًا. وقد خفّض RedHerring المقترح — وهو طُعم قابل للتكيّف مع المستودع ومزوّد بشهادة مخفية — عدد الثغرات الحقيقية المكتشفة بنسبة 38,7–60,4% في 33 مشروعًا ضمن OSS-Fuzz، مع تساوي التكاليف؛ وحتى بعد تحذير الوكيل، ظل الانخفاض عند 37,2%.
9 نوفمبر 2026
التحقق من هلوسات LLM عبر عرض المصادر باستخدام SQL، دون إعادة تدريب
تبحث الدراسة فيما إذا كان بإمكان نموذج لغوي كبير توظيف مهارة رمزية أساسية — إنشاء قاعدة بيانات SQL من المستندات المصدرية — للاستدلال على المصدر دون إشراف عند كشف الهلوسات. ويحقق هذا المسار العصبي الرمزي على مجموعتي RAGTruth وDiaHalu دقة أعلى من التنبؤ المباشر، ويضاهي أحدث الأساليب دون الحاجة إلى ضبط دقيق بحسب المجال.
9 نوفمبر 2026
MathAdv: ما الذي تخفيه الدقة النهائية للبراهين الآلية
تقيّم مجموعة مهام تشخيصية تغطي 13 فرعًا جامعيًا ودراسات عليا في الرياضيات أنظمة البرهنة الآلية في Lean 4، ليس من حيث النتيجة النهائية فحسب، بل أيضًا من حيث الإلمام بالمادة وجودة الاستدلال غير الرسمي والقدرة على التعامل مع إعادة صياغة الشروط. ويُظهر التحليل التفصيلي أن تحويل المسألة إلى صيغة رسمية لا يزال العقبة الأبرز، وأن النجاح يعتمد بشدة على فرع الرياضيات وطريقة صياغة المسألة.
9 نوفمبر 2026