
معيار SemComp-Bench الجديد يتحقق من قدرة نماذج الفيديو على إتمام المهمة حتى النتيجة
قدّم الباحثون مجموعة بيانات ومنهجية لتقييم توليد الفيديو بناءً على تنفيذ المهام دلاليًا: يجب على النموذج ألا يكتفي بإنشاء مقطع فيديو واقعي فحسب، بل يحقق النتيجة المطلوبة ويحافظ على الارتباط الدلالي بالمرجع. تُظهر التجارب الأولية أن هذه لا تزال مهمة صعبة بالنسبة لنماذج الفيديو الحديثة.
القيام بالمهمة دلاليًا: نظرة جديدة على توليد الفيديو
نماذج توليد الفيديو الحديثة تتعامل بشكل ممتاز مع الاستعلامات القصيرة مثل «قطة تلعب بكرة من الصوف» — والنتيجة جميلة وقريبة من الواقع. لكن هل تفهم هذه الأنظمة حقًا النتيجة التي يريدها المستخدم؟ باحثون من الصين اقترحوا معيارًا باسم SemComp-Bench، الذي لا يختبر الجودة البصرية فحسب، بل يتحقق من إنجاز المهمة من حيث المعنى.
مجموعة المؤلفين بقيادة Keyu Tu (ثمانية باحثين إجمالًا) قدّمت على arXiv مقالًا يصف SemComp-Bench. نُشر العمل في 18 أغسطس 2026، وينتمي إلى مجالي الرؤية الحاسوبية والذكاء الاصطناعي. يُقدَّم مفهوم جديد — Semantic Task Completion Video Generation، أي توليد الفيديو مع الإنجاز الدلالي للمهمة. النجاح هنا لا يُحدد بمدى سلاسة حركة الأجسام ولا بالتطابق مع المرجع إطارًا بإطار، بل بتحقيق النتيجة المطلوبة والحفاظ على الارتباط الدلالي بالنموذج المرجعي.
الفكرة الأساسية — «الارتباط الدلالي» (semantic grounding). يجب على النموذج ألا يكتفي بنسخ الصورة، بل أن يفهم المعنى عالي المستوى للمهمة: على سبيل المثال، إذا كانت الصورة المرجعية تُظهر طاولة مُجهزة، والتعليمة تطلب «إضافة إبريق شاي»، فيجب أن يظهر إبريق الشاي على الطاولة في الفيديو النهائي. لا يُشترط عرض كل خطوة وسيطة أو إنشاء نسخة مطابقة إطارًا بإطار من النموذج — المهم فقط هو المشهد النهائي ومدى مطابقته للمهمة.
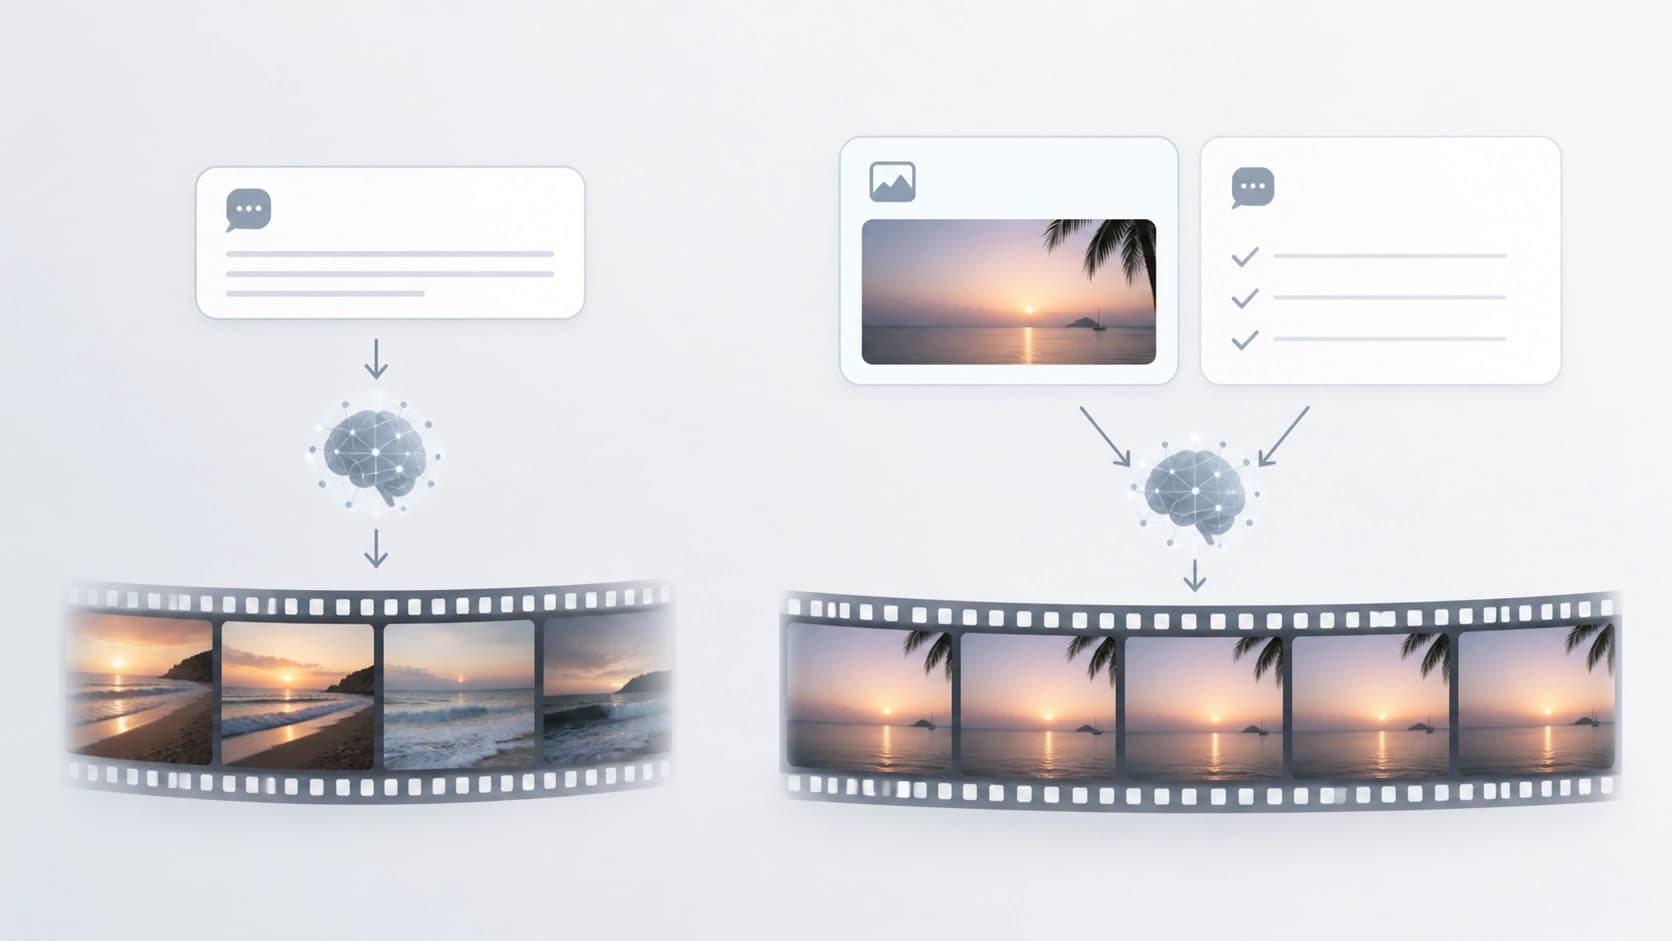
كيف صُممت بيانات SemComp-Bench وتقييمه
لإجراء اختبار منهجي، أنشأ المؤلفون مجموعة بيانات باسم SemComp-Data. تضمنت أمثلة من ستة مجالات مختلفة — وبهذا حاول المؤلفون تغطية أوسع نطاق ممكن من السيناريوهات. يحتوي كل عنصر في مجموعة البيانات على:
- صورة مرجعية (ما يجب أن تكون عليه النتيجة النهائية)؛
- تعليمة مفصّلة مع التفاصيل؛
- تعليمة مختصرة — وهي النسخة الأقرب لما قد يظهر في استعلام حقيقي؛
- مقطع فيديو نهائي يُظهر النتيجة المتوقعة.
لإعداد البيانات، بنى الباحثون خط أنابيب من أربع مراحل. يحوّل الفيديوهات الخام إلى أمثلة موحّدة ضمن SemComp-Data. هذا التشغيل الآلي سمح بتوسيع مجموعة البيانات دون الحاجة إلى وضع علامات يدويًا على كل مقطع.
التقييم في SemComp-Bench مبني حول نموذج لغة-رؤية (VLM). يجيب النموذج على أسئلة ثنائية منظمة — أي أن لكل سؤال إجابة واضحة بـ«نعم» أو «لا». هذا يجعل التحقق شفافًا وقابلًا للتكرار. بناءً على النتائج، يُحتسب مؤشران:
- درجة OA (تحقيق النتيجة) — هل تم تحقيق النتيجة المطلوبة؛
- درجة GR (موثوقية التوليد) — مدى موثوقية النموذج في إعادة إنتاج الحل مع الحفاظ على الارتباط بالصورة المرجعية.
باختصار، المؤشر الأول يجيب على سؤال «هل تم ما طُلب»، والثاني — «هل تم ذلك في سياق المثال تحديدًا».
ماذا أظهرت الاختبارات الأولى
مرّر المؤلفون عدة نماذج تمثيلية لتوليد الفيديو عبر المعيار. تبيّن أن مهمة إتمام الدلالة حتى النهاية لا تزال مفتوحة. حتى الأنظمة الحديثة كثيرًا ما تُنتج مقطعًا يبدو عالي الجودة لكنه لا يطابق جوهر الطلب: إبريق الشاي لا يظهر، الجسم يتحول إلى شيء مشابه، والنتيجة لا تشبه المتوقع إلا عن بُعد.
يصعب على النماذج بشكل خاص الحفاظ على الارتباط بالصورة المرجعية عندما تكون التعليمة قصيرة ولا تحتوي على كل التفاصيل. درجتا OA وGR تكونان منخفضتين، أي أن النموذج «لا يفهم» المهمة على مستوى المعنى. هذا يؤكد أن توليد الفيديو اليوم أقرب إلى «صورة جميلة» منه إلى تنفيذ مهمة.
ظهور SemComp-Bench يغيّر التركيز في اختبار نماذج الفيديو: بدلًا من تقييم مدى واقعية الإطارات — التحقق من نتيجة ذات أهمية للمستخدم. إذا كانت المعايير السابقة تسأل «هل الفيديو يشبه الواقع»، فإن السؤال الآن يُطرح بشكل مختلف: «هل أُنجزت المهمة». هذه خطوة نحو جعل الفيديوهات التوليدية ليست مجرد عروض، بل أداة لحل المهام العملية.
نشر المؤلفون العمل على منصة arXiv تحت الرقم 2608.17426، DOI: https://doi.org/10.48550/arXiv.2608.17426. المواد متاحة للاطلاع، والمنهجية نفسها في التقييم قد تشكل أساسًا لأجيال قادمة من مولّدات الفيديو.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
Toollery: اختيار الأدوات لوكلاء LLM من بين عشرات الآلاف من الخيارات دون إعادة تدريب
ينشئ Toollery فهرسًا للبحث في أوصاف المهارات والأدوات، وعند تلقي طلب يمرّر إلى النموذج مجموعة محدودة فقط من الخيارات المرشحة. في تجارب على مكتبات تضم ما يصل إلى عشرات الآلاف من الوظائف، يتيح هذا النهج الحفاظ على جودة الاختيار عند قيمة top-K ثابتة، مع أن الأثر النهائي يعتمد على نمط عبء العمل والتخزين المؤقت لدى مزوّد الخدمة.
11 نوفمبر 2026
التشخيص التدريجي لوكلاء واجهة المستخدم الرسومية أثناء تحليل لوحات المعلومات: معيار DashAct
يقدّم DashAct معيارًا مرجعيًا يضم 348 مسارًا راجعها بشر، ويحلّل عمل وكلاء واجهات المستخدم الرسومية مع لوحات التحكم التفاعلية إلى ثلاث مراحل وأربعة شروط بصرية. وتُظهر النتائج مشكلات مستمرة في التنبؤ بالإجراءات وربطها بالأهداف البصرية، فضلًا عن اعتماد استجابة الوكلاء على الدعم السياقي والمكاني.
11 نوفمبر 2026
WILSON: دمج مستويات التكبير وشرائح المريض للتحليل الباثومورفولوجي وإعداد التقارير
تقدّم هذه الورقة البحثية الأولية نموذج WILSON، وهو نموذج للرؤية واللغة يرمّز صور الشرائح الكاملة وسلاسل العينات لمريض واحد عند درجات تكبير مختلفة، بدلًا من الاقتصار على شريحة منفردة «أفضل». ومن دون ضبط دقيق للمهمة، يتفوّق على نماذج الشرائح المتخصصة والأكبر حجمًا في عدد من المقاييس، مع عبء حوسبي أقل بكثير، كما حصلت أوصافه التشخيصية على تقييمات أعلى من اختصاصيي علم الأمراض.
11 نوفمبر 2026