
المشكلة: كود يعمل لكنه يفعل شيئًا آخر
أصبحت الوكلاء المبنية على النماذج اللغوية الكبيرة قادرة بالفعل على أخذ ورقة بحثية وإنتاج مستودع برمجي عامل بناءً عليها. المشكلة أن «عامل» و«قابل لإعادة الإنتاج» ليسا مترادفين. قد ينجح السكربت في اجتياز جميع الاختبارات، وتدريب النموذج، وطباعة مقياس جميل، بينما يكون داخله قد استُبدل ترتيب الخطوات دون أن يلاحظ أحد، أو فُقد مُعامل في دالة الخسارة، أو وُضع بديل شكلي مكان مرحلة غير بديهية.
هذا النمط من الفشل تحديدًا هو ما يسميه مؤلفو العمل الجديد الانحراف الدلالي (semantic drift): الكود المُولَّد يتباعد بصمت عمّا هو موصوف في مواصفات الورقة. الخطأ لا يلفت الانتباه — فهو يعيش في التفاصيل التي لا يتحقق منها أحد تلقائيًا. والنتيجة إعادة إنتاج تحققت شكليًا، لكنها لا تؤكد شيئًا علميًا.
ما هو SA-Bench
لقياس الانحراف، لا بد أولًا من جعله قابلًا للملاحظة. هذا ما يتولاه SemanticAlign-Bench، ويُختصر إلى SA-Bench — وهو معيار تشخيصي موصوف في الورقة arXiv:2608.24252 (مقبولة في Findings of EMNLP 2026، والمؤلفون هم Xue Hu وZewei Pan وZeli Su وZhou Liu وWentao Zhang).
تغطي المادة 30 عملًا من مؤتمرات ICLR وICML وNeurIPS لعام 2025، وموزعة على خمسة مجالات في تعلّم الآلة. ولا تُقيَّم «الانطباعات» عن الكود، بل مجموعة من الادعاءات القابلة للتحقق. ويضم المعيار في مجموعه 1,491 ادعاءً من هذا النوع.
Semantic Alignment Units: ذرّات المواصفات
الفكرة المنهجية الأساسية هي تفكيك وصف الورقة إلى أصغر العناصر التي يمكن التحقق منها يدويًا مقابل المستودع. تُسمى هذه العناصر Semantic Alignment Units (SAU). وكل وحدة هي ادعاء منفصل عن التنفيذ: معامل فائق محدد، أو صيغة، أو ترتيب العمليات، أو شرط توقف، أو مخطط تقسيم البيانات.
هذا النهج الدقيق مهم لأنه يجرّد التقييم من ثنائية «نجح / لم ينجح». فبدلًا من علامة واحدة لكل ورقة، تظهر مئة سؤال صغير، ويصبح واضحًا أين تحديدًا أخفق التنفيذ.
أربعة أبعاد للانحراف
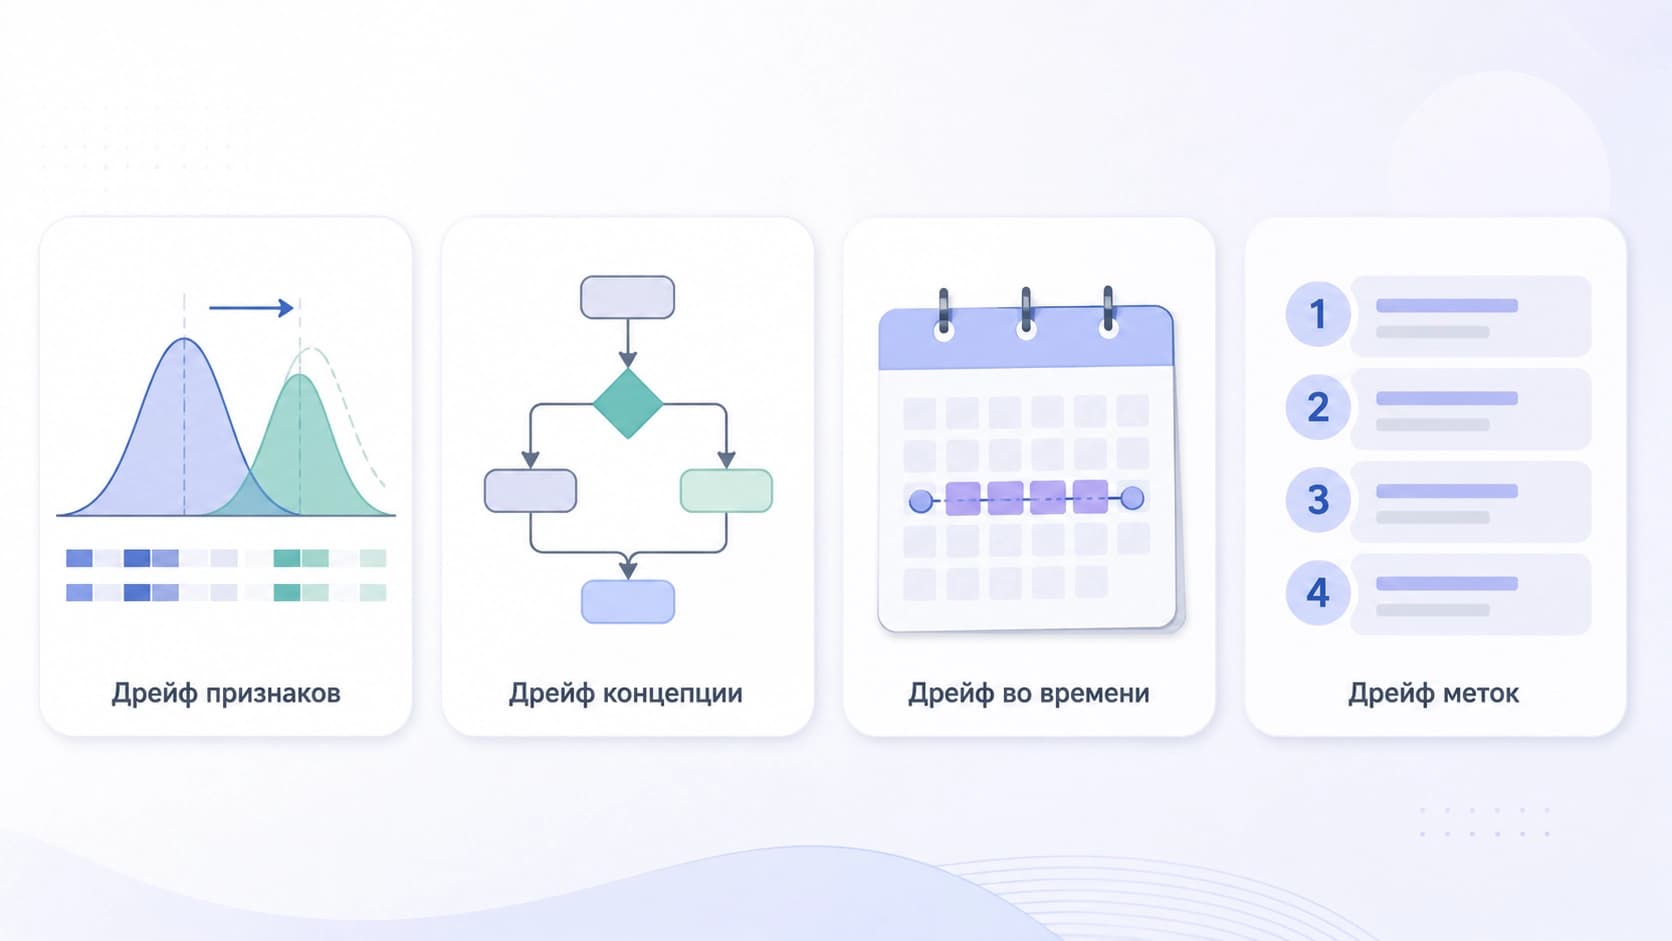
يُقيَّم كل مستودع على أربعة محاور تشخيصية:
- الانحراف الرقمي — قيم المعاملات والأبعاد والعتبات وغيرها من الكميات لا تطابق المواصفات؛
- الانحراف المنهجي — إجراء التدريب أو الحساب نفسه مبني بشكل مختلف عمّا هو مقصود في العمل؛
- الانحراف البروتوكولي — مخطط التجربة مخالف: تقسيم العينة، شروط المقارنة، لائحة التقييم؛
- انحراف الترتيب — الخطوات نُفِّذت بتسلسل خاطئ، وهذا يغيّر النتيجة.
الفصل بين المحاور له فائدة عملية: يرى المطوّر ليس «جودة منخفضة» مجردة، بل نوع العطل المحدد.
النتائج: 0.301 كسقف أعلى
شغّل المؤلفون 12 تهيئة للمولّدات — أربعة نماذج بالاقتران مع ثلاثة سقالات (scaffolds). وقيس كل تقييم بأجزاء من الواحد.
جاءت الأرقام موقظة. أفضل نتيجة حققتها توليفة Claude وPaperCoder — بمتوسط 0.301 نقطة SAU من 1.0 ممكنة. والمتوسط العام عبر جميع التقييمات الـ360 هو 0.221.
بعبارة أخرى، حتى أقوى تهيئة تنفّذ بشكل صحيح أقل من ثلث ما تتطلبه المواصفات. ومع ذلك لا تتجاهل النماذج المتطلبات: يُظهر تصنيف حالات الفشل أن الوكلاء عادةً يحاولون تغطية معظم البنود، لكنهم ينفّذونها بشكل خاطئ. والكتلة الأساسية من الادعاءات المُصفَّرة تأتي من سيناريوهين — عدم تطابق التنفيذ مع المقصود (implementation mismatch) والبدائل الشكلية (stubs)، أي المواضع التي تُركت فيها صيغة فارغة بدلًا من المنطق الحقيقي.
هذا النمط من الأخطاء يقول شيئًا مهمًا: المسألة ليست في كسل الوكيل ولا في أنه «لم يُكمل قراءة» الورقة. المسألة أنه يعيد إنتاج نسخة معقولة لكنها خاطئة بثقة تامة.
القابلية للتنفيذ لا تساوي الأمانة العلمية
ثمة استنتاج منفصل في العمل يتعلق بكيفية بناء السقالات الحديثة. تلك المُحسَّنة من أجل القابلية للتنفيذ — لكي يعمل الكود فقط ولا ينهار — تقدّم مكسبًا محدودًا لإعادة الإنتاج العلمي. وهذا منطقي: التشغيل الناجح يتحقق من الصياغة ووجود التبعيات، لكنه لا يقول شيئًا عن مدى تطابق المنطق مع مقصود المؤلفين.
ولتقليص الفجوة، نحتاج إلى سقالات من فئة أخرى — تلك التي تضع التحقق من المواصفات الدلالية في المقام الأول. وبعبارة أبسط، لا يحتاج الوكيل إلى كتابة الكود وتشغيله فحسب، بل إلى مطابقة كل خطوة من خطواته مع ادعاء من الورقة، وأن يكون قادرًا على إثبات وجود التطابق.
ما الذي يغيّره هذا عمليًا
SA-Bench ليس مسابقة بين النماذج، بل أداة تشخيصية. وقيمته في أنه ينقل النقاش حول قابلية إعادة الإنتاج من مستوى «يعمل / لا يعمل» إلى مستوى «إلى أي مدى يطابق بدقة». المعيار والترشيحات وخط أنابيب التقييم متاحة في الوصول المفتوح، لذا يمكن تطبيق المنهجية على مهامك الخاصة أيضًا — مثلًا للتحقق من خطوط أنابيب توليد الكود الداخلية وفق المواصفات الفنية، وليس وفق الأوراق العلمية فقط.
أما لمن يبنون الوكلاء، فالاستنتاج هو: زيادة «ذكاء» المولّد دون طبقة تحقق منفصلة تصطدم بسقف. الانحراف الدلالي ليس عيبًا في نموذج بعينه، بل خاصية لنهج لا يتحقق فيه أحد من التطابق الدلالي. وما دامت هذه الطبقة غائبة، ستبقى إعادة إنتاج كود البحث مهمة لا يزال على الإنسان فيها قراءة كل سطر.


