
RLTLDR: يستخلص الوكيل بنفسه درسًا من الإخفاق ويأخذه في الحسبان في المحاولة التالية
بعد الإخفاق، يُعرض على الوكيل تنبيه المُتحقِّق ويُطلب منه اختزاله إلى تلميح واحد؛ ويجري التدريب على أزواج «المهمة — التلميح»، من دون معلّم أو حلول نموذجية. في مجموعات البيانات الصعبة للبرمجة واستخدام الأدوات، ترفع الطريقة معدل Pass@1 من 0–1% لدى GRPO إلى 12–31%، ويأتي الإسهام الحاسم تحديدًا من استيعاب هذا الزوج.
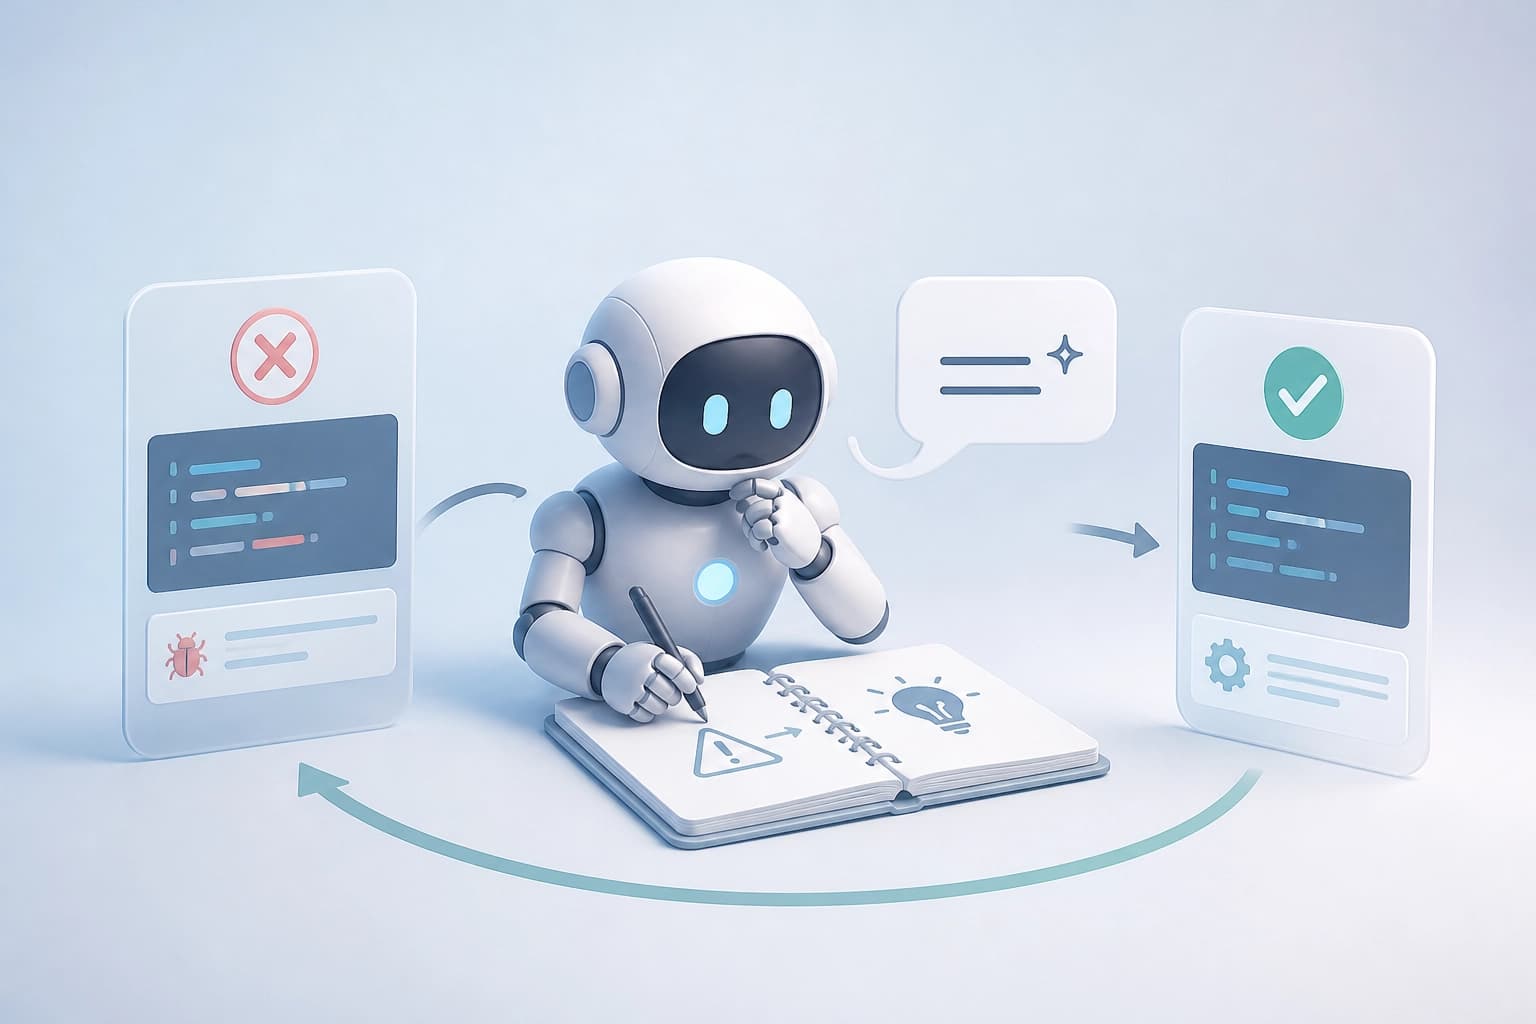
RLTLDR — طريقة للتحسين الذاتي للوكيل في المهام التي يصعب النجاح فيها. بعد محاولة فاشلة، يرى الوكيل مخرجات أداة التحقق ويصوغ بنفسه استنتاجًا موجزًا واحدًا — خلاصة موجزة (TL;DR insight). تراعي المحاولة التالية جميع الاستنتاجات السابقة. يصف عمل Michael Kirchhof وEleonora Gualdoni وAndrew Szot وآخرين هذا النهج. قُدّمت النسخة الأولى في 29 سبتمبر 2026. وآخر تعديل كان في 19 أكتوبر 2026.
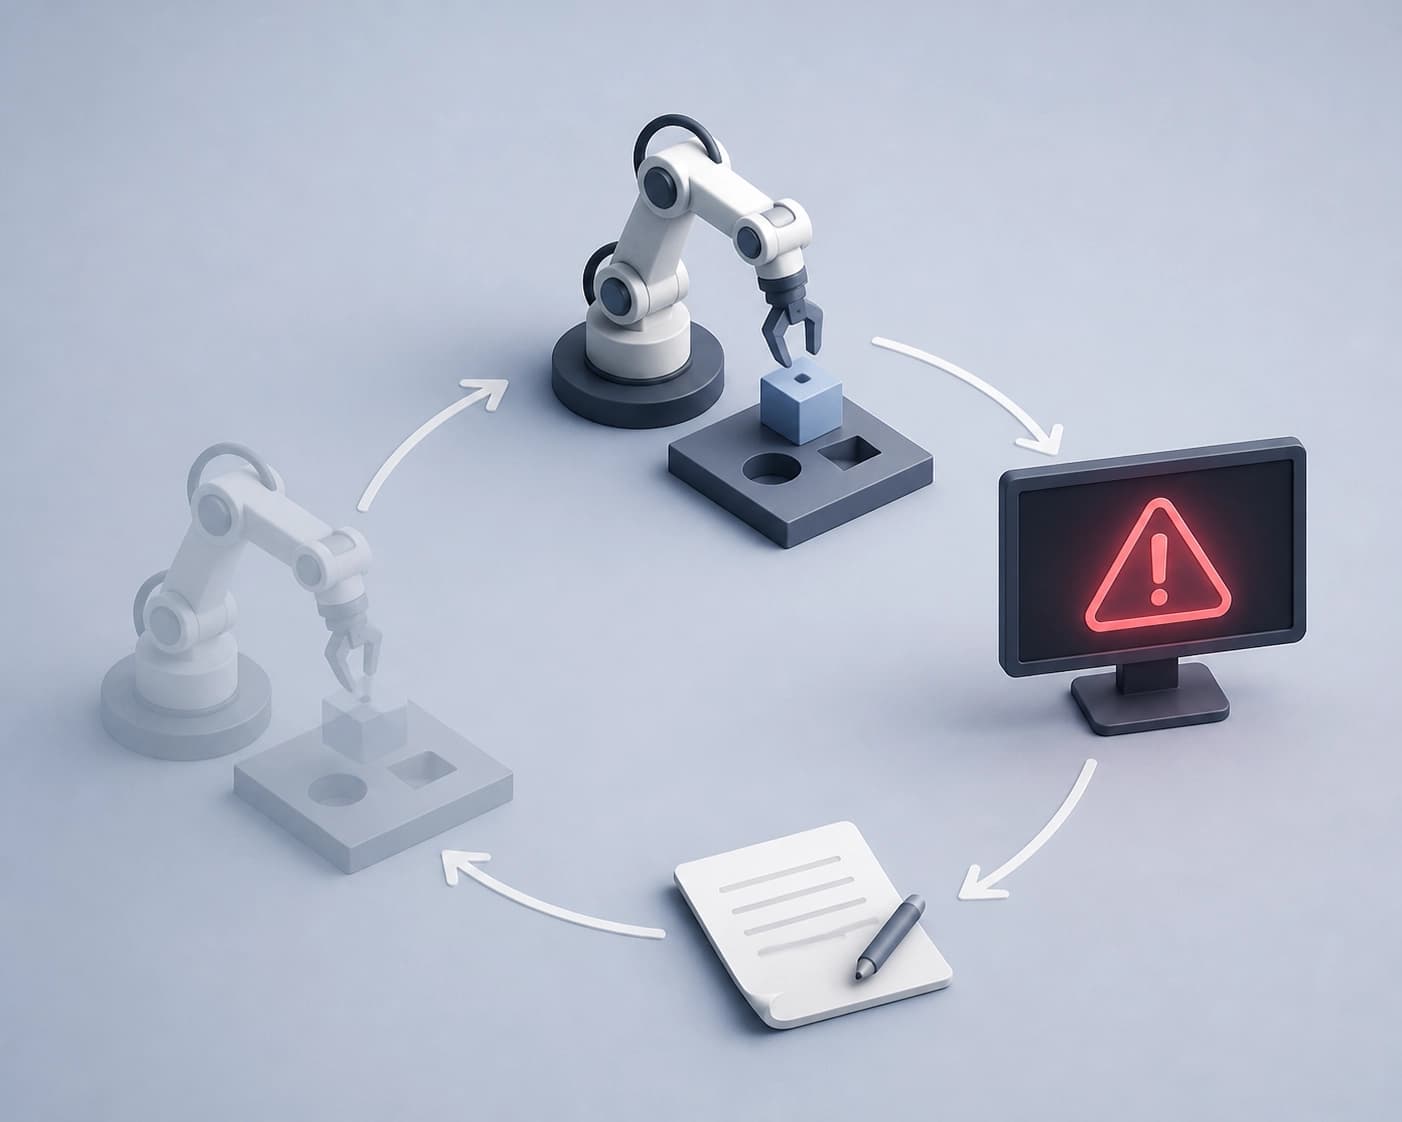
المشكلة التي يعالجها RLTLDR
يستهدف RLTLDR التحسين الذاتي للوكيل. يصعب على الوكيل النجاح في مثل هذه المهام. ولا تتوفر نماذج معلّمين أو أمثلة لحلول يمكن استخدامها في التقطير. لذلك يصبح الفشل ومخرجات أداة التحقق مصدرًا للتغذية الراجعة.
شروط المهمة:
- لا تتوفر نماذج معلّمين؛
- لا تتوفر أمثلة لحلول يمكن استخدامها في التقطير؛
- يصعب على الوكيل النجاح؛
- تتوفر مخرجات أداة التحقق بعد الفشل.
الخلاصة: يُستخدم RLTLDR عندما لا تتوفر حلول جاهزة أو معلّم، لكن يتوفر فشل يمكن التحقق منه. والمعيار العملي هو وجود أداة تحقق يمكن تمرير مخرجاتها إلى الوكيل.
آلية عمل الدورة
تتمحور دورة RLTLDR حول محاولات متتابعة. ويوفر كل فشل مادةً للخطوة التالية.
المراحل:
- ينفذ الوكيل rollout ويفشل.
- يرى الوكيل مخرجات أداة التحقق.
- يصوغ الوكيل تغذية راجعة من عنده — خلاصة موجزة واحدة (TL;DR insight).
- يراعي rollout التالي جميع الاستنتاجات السابقة.
- تتتابع عمليات rollout حتى يُعثر على حل.
- يعلّم التدريب باستخدام backpropagation على الاستنتاجات في السياق العلاقة «المهمة → الاستنتاج».
الخلاصة: لا تقتصر قيمة الدورة على تقديم تلميح للمحاولة التالية. فالعامل الأساسي هو تعلّم العلاقة بين المهمة والاستنتاج.
النتائج في المهام الصعبة
أُجريت الاختبارات على مجموعات بيانات صعبة لاستدعاء الأدوات والبرمجة. واختار المؤلفون مجموعات البيانات وفق شرط Pass@128=0. وأُجريت المقارنة باستخدام سياسة Qwen 3.5 9B Thinking.
| النهج | شروط التقييم | Pass@1 |
|---|---|---|
| تدريب GRPO القياسي | من دون دورة الاستنتاجات الموصوفة | 0–1% |
| RLTLDR | الاستنتاجات موجودة في السياق أثناء التدريب | 14–31% |
| RLTLDR | الاستنتاجات غير موجودة في السياق أثناء التقييم | 12–13% |
يبقى التدريب القياسي باستخدام GRPO عند مستوى Pass@1 يتراوح بين 0% و1%. ويحقق RLTLDR نسبة تتراوح بين 14% و31% عند وجود الاستنتاجات في السياق أثناء التدريب. أما عند غيابها عن السياق أثناء التقييم، فتبلغ النتيجة 12–13%. ويشير المؤلفون إلى تعلّم العلاقة «المهمة → الاستنتاج» بوصفه العامل الأساسي.
الخلاصة: يرفع وجود الاستنتاجات في السياق قيمة Pass@1. وللتحقق من حدوث التعلّم، ينبغي تقييم الطريقة مع الاستنتاجات في السياق ومن دونها.
SFTLDR: التدريب على أزواج «المهمة — الاستنتاج»
SFTLDR خيار تدريبي موجز. ويتعلم من أزواج (المهمة، الاستنتاج) فقط. ولا يستخدم عمليات rollout أو backpropagation عليها.
ما هو معروف عن SFTLDR:
- يقتصر التدريب على أزواج (المهمة، الاستنتاج)؛
- لا يعرض SFTLDR عمليات rollout؛
- لا يستخدم SFTLDR backpropagation على عمليات rollout؛
- يعيد التدريب على 4k من هذه الأزواج أداء RLTLDR شبه الكامل؛
- يكاد SFTLDR يحقق أداء التدريب التقليدي باستخدام SFT على عمليات rollout الكاملة؛
- يصف المؤلفون النهج بأنه نموذج تدريبي موجز: «للمهام من هذا النوع، تذكّر أمورًا من هذا النوع».
الخلاصة: SFTLDR خيار للتدريب الموجز. والمعيار هو اختباره في الحالات التي يمكن فيها جمع أزواج «المهمة — الاستنتاج».
معايير الملاءمة
يتطلب RLTLDR تغذية راجعة قابلة للتحقق ومحاولات متتابعة. ومن دون هذه الشروط، لا يمكن بناء الدورة. وتساعد المعايير أدناه على تقييم مدى الملاءمة.
المعايير:
- تسمح المهمة بمحاولات فاشلة وعمليات rollout متكررة؛
- تتوفر أداة تحقق يمكن عرض مخرجاتها على الوكيل؛
- يستطيع الوكيل صياغة استنتاج موجز واحد؛
- تراعي المحاولة التالية جميع الاستنتاجات السابقة؛
- يشمل التقييم وضعًا لا توجد فيه استنتاجات في السياق، إذا كان التحقق من حدوث التعلّم مهمًا.
الخلاصة: يُختار RLTLDR للمهام التي تتوفر فيها أداة تحقق ويصعب النجاح فيها. ويُختار SFTLDR عند الحاجة إلى وضع تدريبي موجز يعتمد على أزواج «المهمة — الاستنتاج».
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التصحيح الاحتمالي لتنبؤات الأمواج: يربط BridgeCast النماذج الفيزيائية بإعادة التحليل عبر المطابقة المتدفقة
تُقدَّم طريقة هجينة تحوّل مخرجات النماذج الفيزيائية للأمواج إلى حقول قريبة من إعادة التحليل، وذلك باستخدام المطابقة التدفقية الشرطية وبنية المحوّلات وسمات الغلاف الجوي الخارجية. ويشير المؤلفون إلى تفوّق ثابت على أفضل الحلول الأساسية السابقة عبر مدد استباقية مختلفة ومناطق متعددة.
12 نوفمبر 2026
OpenCollab: تنسيق قابل للبرمجة للوكلاء، وبيئة تنفيذ خاضعة للرقابة، ومقياس للامتثال للوائح
يجمع إطار العمل بين تحديد بنية تفاعل الوكلاء، وبيئة مشتركة للتجارب، والتتبّع التفصيلي للأحداث، فيما يعكس مقياس Adherence المستحدث مدى توافق التنفيذ الفعلي مع المخطط المعلن. في الاختبارات المعيارية، يرتقي إعداد Duo إلى مستوى جديد من SOTA، بينما يتميز البديل أحادي الوكيل بأقل استهلاك للرموز.
11 نوفمبر 2026
Toollery: اختيار الأدوات لوكلاء LLM من بين عشرات الآلاف من الخيارات دون إعادة تدريب
ينشئ Toollery فهرسًا للبحث في أوصاف المهارات والأدوات، وعند تلقي طلب يمرّر إلى النموذج مجموعة محدودة فقط من الخيارات المرشحة. في تجارب على مكتبات تضم ما يصل إلى عشرات الآلاف من الوظائف، يتيح هذا النهج الحفاظ على جودة الاختيار عند قيمة top-K ثابتة، مع أن الأثر النهائي يعتمد على نمط عبء العمل والتخزين المؤقت لدى مزوّد الخدمة.
11 نوفمبر 2026