
سلسلة استدلال قصيرة — ليست دائمًا الأفضل
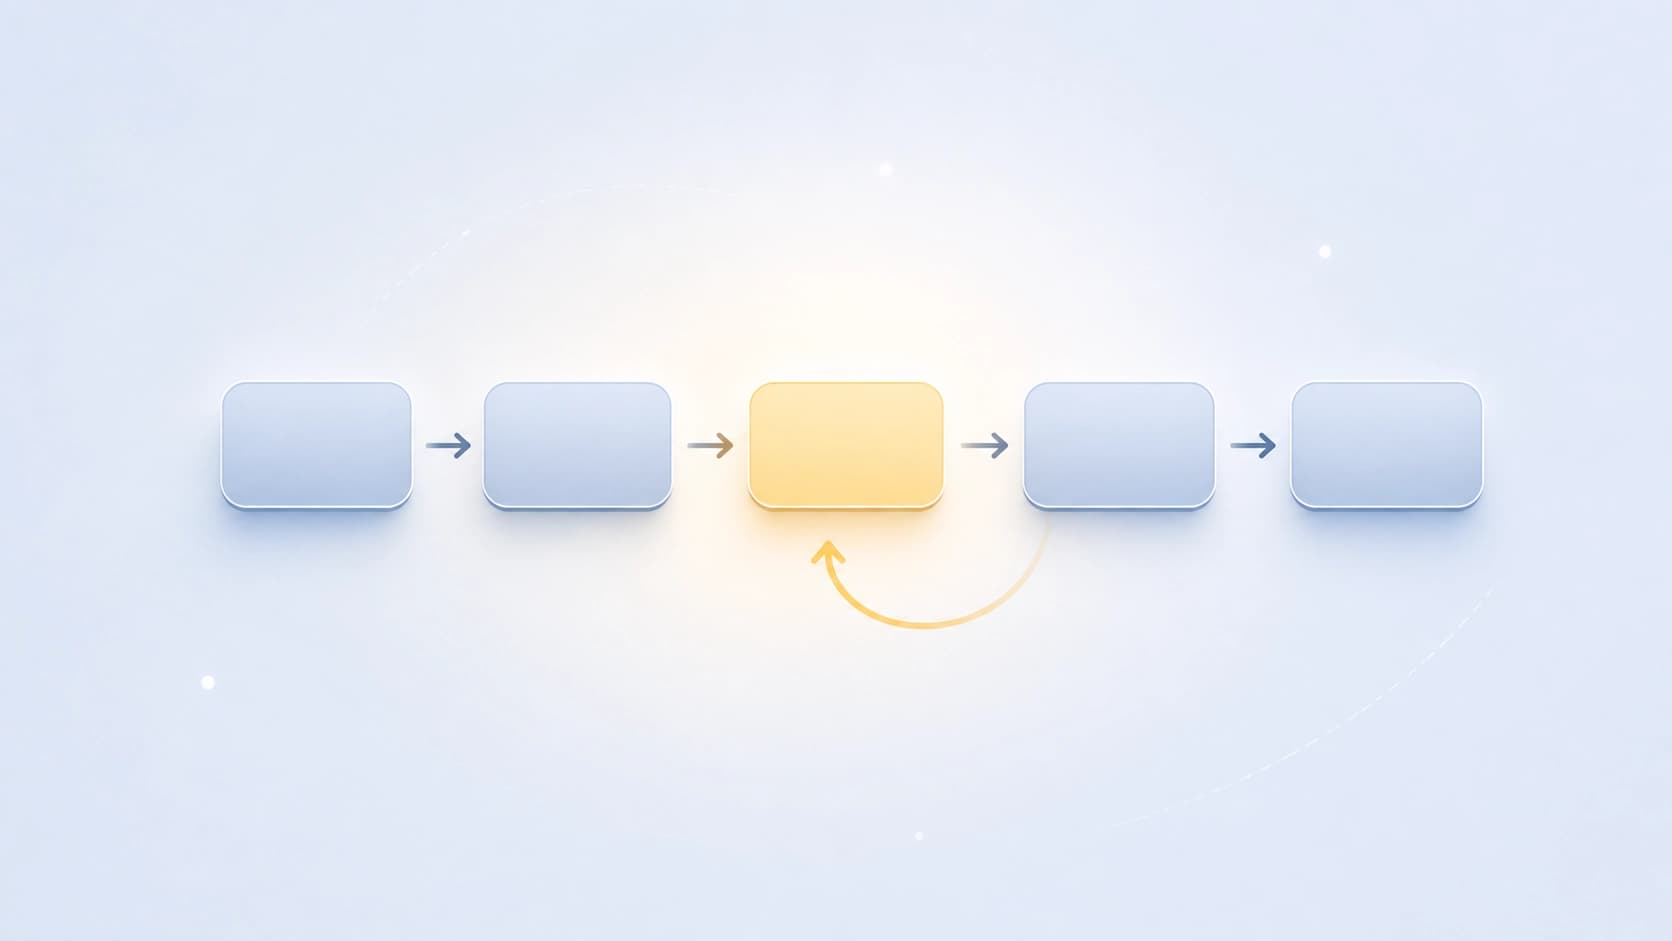
النماذج الكبيرة المدرَّبة على «التفكير بصوت مسموع» تتفوق بفضل سلاسل الاستدلال الطويلة. وكلما زاد تعقيد المهمة، كتب النموذج خطوات وسيطة أكثر قبل أن يقدّم إجابته. ومن الآليات التي يُعتبر عادةً أنها محورية لهذه الجودة آلية الاستبطان الذاتي: القدرة على الالتفات إلى الخطوات التي أُنجزت بالفعل، ورصد الخطأ، وإعادة كتابة مسار الحل.
المشكلة أن هذه القدرة لها ثمن. فكل عملية مراجعة تعني رموزًا إضافية عند الاستدلال، أي مالًا ووقتًا وموارد حوسبة. ومع ذلك، لم يشرح أحد حتى وقت قريب شرحًا وافيًا ما الذي يحكم تحديدًا قرار النموذج بـ«التوقف وإعادة التحقق من نفسه». كان الاستبطان الذاتي أشبه بصندوق أسود داخل صندوق أسود: نعرف أنه يعمل، لكن لا نفهم كيف.
يتناول عمل Ge Yan وChung-En Sun وLinbo Liu وTsui-Wei Weng (arXiv:2512.13979، مقبول في COLM 2026) المسألة من زاوية غير متوقعة — لا عبر المطالبات (prompts) ولا عبر الضبط الدقيق، بل عبر التمثيلات الكامنة للنموذج.
اتجاه الاستبطان داخل النموذج
ما الذي بحثوا عنه وما الذي وجدوه
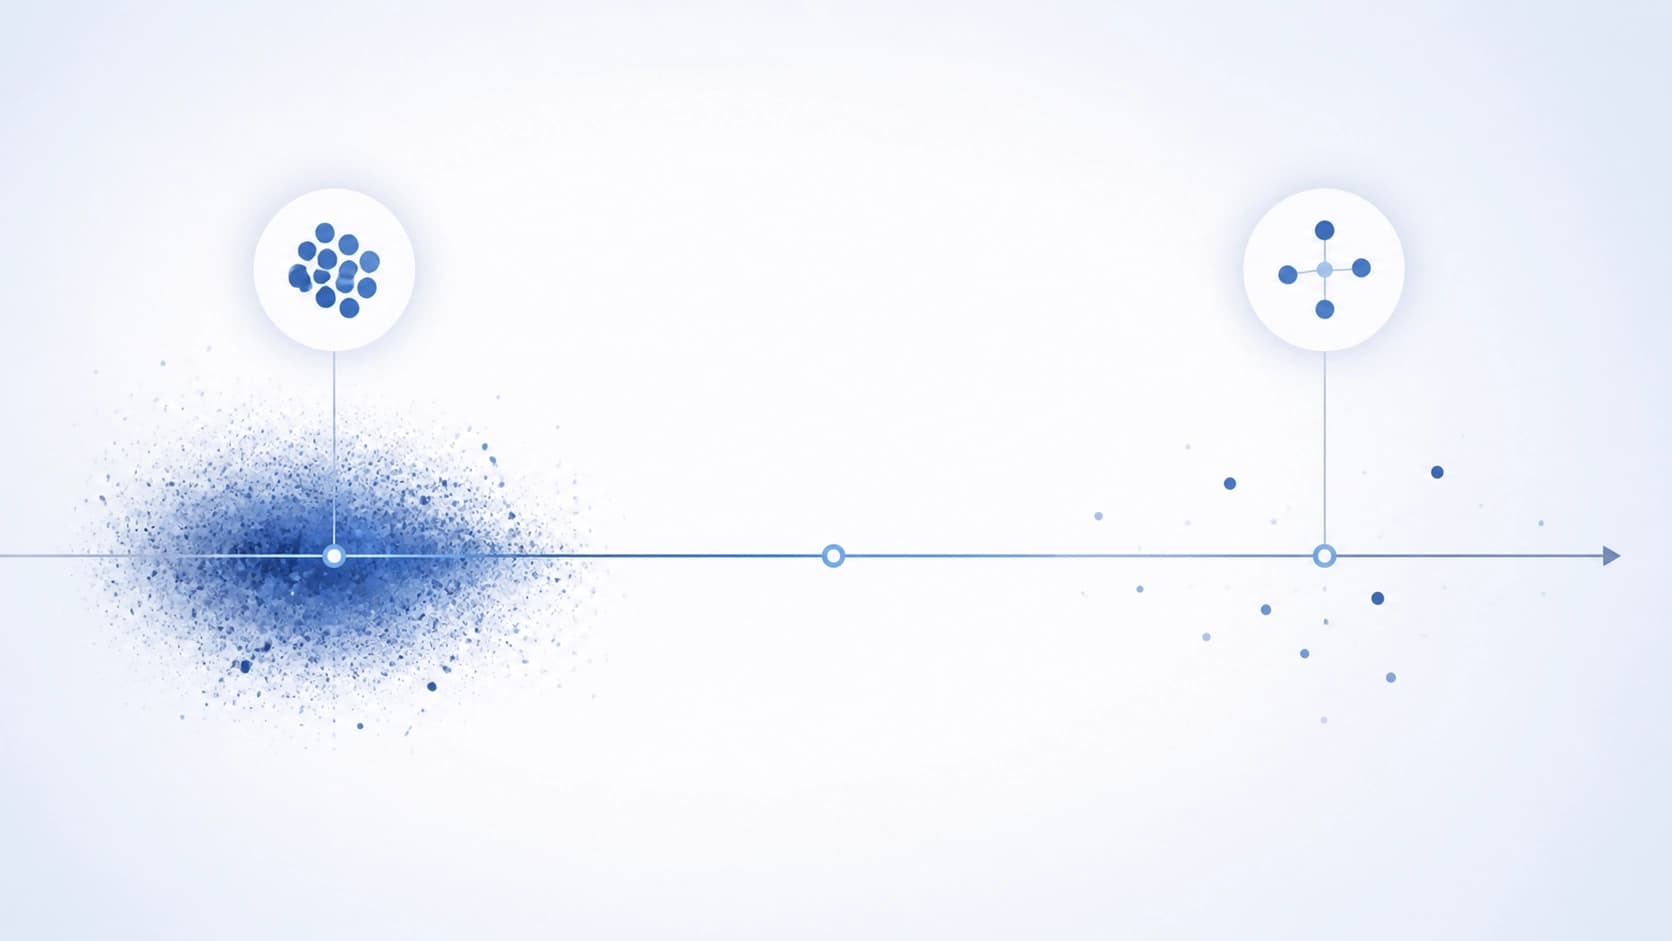
طبّق الباحثون على الاستبطان الذاتي أدوات هندسة التمثيلات (representation engineering) — وهو مجال يدرس التنشيطات الداخلية للنموذج لا نصوصه الناتجة. والمنطق بسيط: إذا كان النموذج «يقرر» أن يستبطن، فهذا القرار منعكس في مكان ما في تمثيلاته. إذن يمكن العثور عليه ووصفه — والأهم — استخدامه.
وهذا ما حدث بالفعل. فقد ظهر في الفضاء الكامن اتجاه محدَّد تنفصل على طوله الخطوات المتضمّنة استبطانًا عن الخطوات الخالية منه. وهو في جوهره محور «إعادة التحقق / عدم إعادة التحقق»، وموضع النقطة على هذا المحور يميّز بثبات بين نوعي الخطوات.
الاستبطان يحكمه عدم اليقين
أكثر ملاحظة مثيرة في الورقة: إن مقدار التنشيط على طول الاتجاه المكتشف يتنبأ جيدًا بما إذا كانت الإجابة النهائية ستكون صحيحة. وبعبارة أخرى، لا يُشغَّل الاستبطان عشوائيًا ولا وفق جدول — بل يرتبط بعدم اليقين الداخلي للنموذج. فعندما «يشعر» النموذج أن الأرض زلقة، يتباطأ ويعيد النظر؛ وعندما يكون كل شيء واضحًا، يمضي قدمًا.
هذا تحوّل مهم في الصورة الذهنية. فلم يعد الاستبطان قدرة منفصلة ينبغي تنميتها، بل صار أقرب إلى إشارة — مؤشر على أن النموذج نفسه يشك في خطوته.
كيف يعمل ReflCtrl
إذا كان قرار الاستبطان يقيم في التنشيطات، فيمكن التأثير عليه مباشرة — بالتدخل في التمثيلات لا بإعادة كتابة المطالبة. وعلى هذا يقوم ReflCtrl: إطار عمل يدير الاستبطان الذاتي عبر التوجيه (steering) — أي إزاحة التنشيطات على طول الاتجاه المكتشف.
التفصيل الجوهري — متى بالضبط يتم التدخل
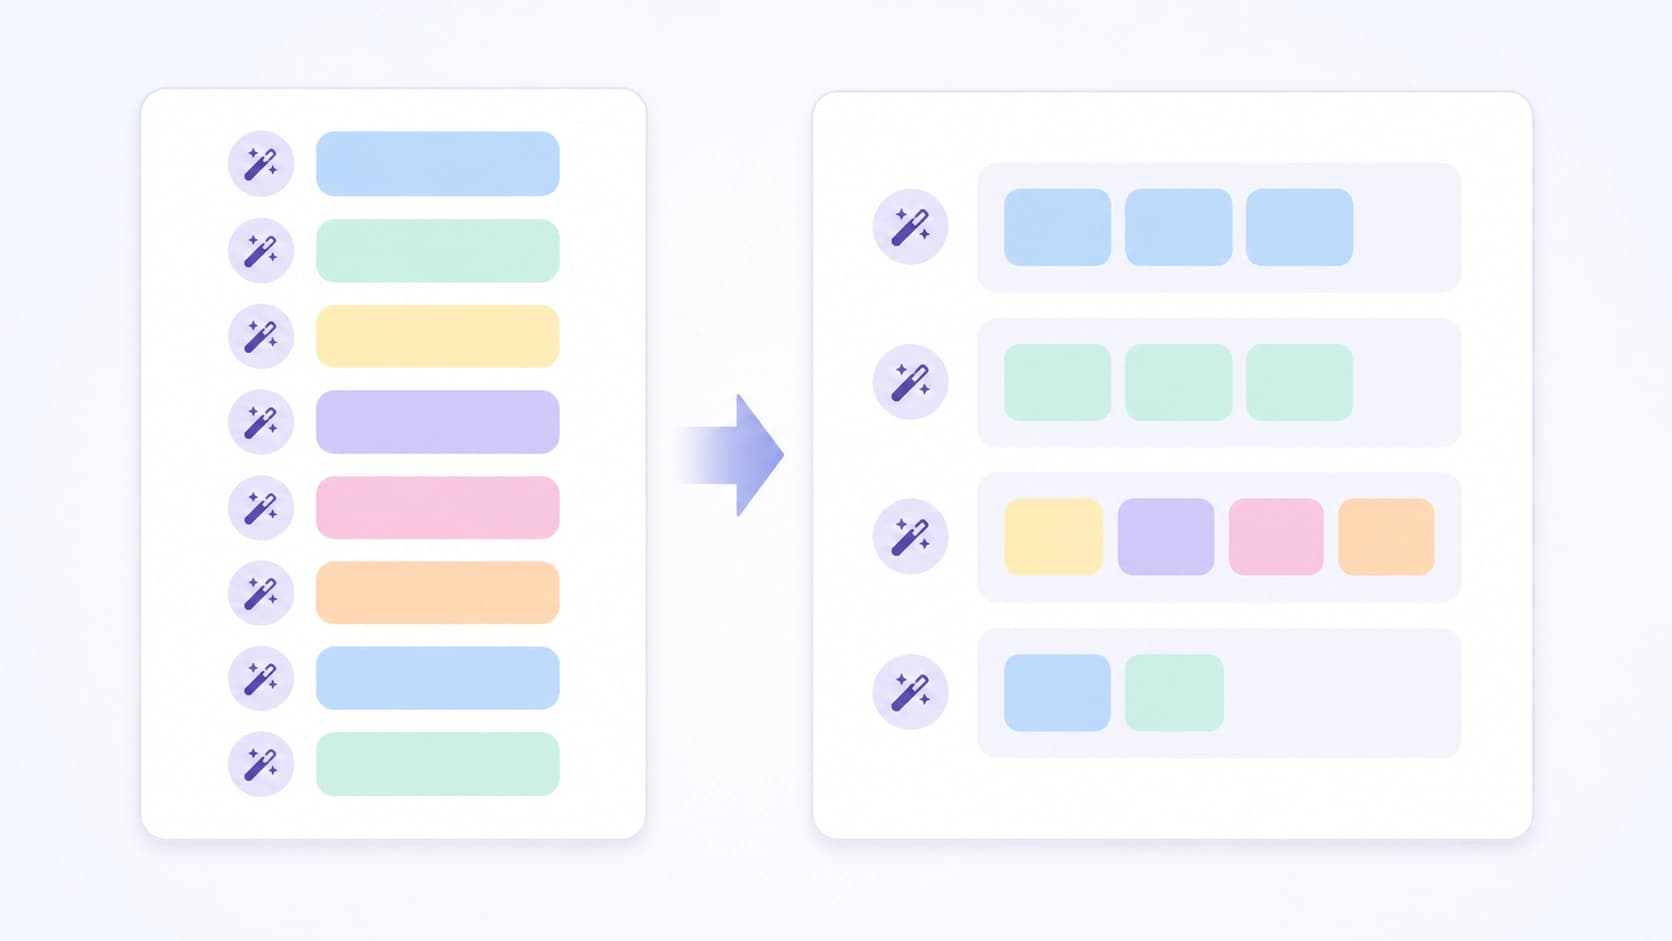
النهج الساذج بديهي: إضافة الإزاحة المطلوبة عند كل رمز يُولَّد. وكان هذا أول ما يخطر على البال — وهو بالضبط ما يعمل بشكل سيئ. فالضغط المستمر على التمثيلات يطمس جودة التوليد: يفقد النموذج تماسكه، لأن التدخل يحدث أيضًا حيث لا معنى له.
يقترح المؤلفون نسخة على مستوى الخطوة (step-level). يُطبَّق التدخل مرة واحدة بالضبط — في بداية كل خطوة استدلال جديدة. بعد ذلك يولّد النموذج رموز هذه الخطوة بحرية، دون عوائق. والنتيجة ضبط دقيق: يتغير معدل الاستبطان، بينما يبقى مسار التفكير داخل الخطوة نفسه دون مساس.
وهذا المزيج بالتحديد — تدخل نادر وموجَّه بدلًا من تدخل متواصل — هو ما يحقق المكسب الأساسي.
ما الذي أظهرته التجارب
أُجريت الاختبارات على معايير تقييم للاستدلال الرياضي والعام. وتتجمّع النتائج في استنتاج غير مريح إلى حد كبير للقطاع: الاستبطان غالبًا زائد عن الحاجة.
- يمكن تقليص عدد رموز الاستدلال بما يصل إلى 43.2% من الحجم الأصلي — مع الحفاظ على الدقة.
- يظهر الأثر بشكل أوضح على النماذج الأقوى: فكلما كان النموذج أفضل، زادت إعادة تحققه من نفسه دون داعٍ.
- يتفوق التوجيه على مستوى الخطوة بشكل ملموس على التوجيه التقليدي على مستوى الرمز عند ميزانيات رموز متقاربة.
النقطتان الثانية والثالثة مترابطتان. فالنموذج القوي أكثر ثقة بخطواته، لذا يغدو استبطانُه في كثير من الأحيان حركة بلا طائل — والتوجيه على مستوى الرمز هو بالضبط ما يعاني من عجزه عن التوقف في الوقت المناسب.
لماذا يهم هذا خارج المختبر
اقتصاد الاستدلال ليس تجريدًا. فالسلاسل الطويلة تنفخ فواتير الاستدلال، وتزيد زمن الاستجابة، وتحدّ من عدد الطلبات التي يمكن تمريرها أصلًا عبر العتاد المتاح. وإذا كان بالإمكان إزالة ما يقارب نصف «التفكير» دون خسارة في الجودة، فهذا توفير مباشر على نطاق واسع.
وهناك طبقة أقل وضوحًا. يُظهر العمل أنه يمكن ضبط سلوك النموذج على مستوى التمثيلات — بلطف ودقة أكبر من المطالبات، وبكلفة أقل من الضبط الدقيق. وهكذا تصبح القابلية للتحكم بُعدًا هندسيًا قائمًا بذاته: لا «ماذا نكتب في التعليمات»، بل «إلى أين نزيح التنشيط وفي أي لحظة».
وأخيرًا، هذا إسهام في قابلية التفسير. فنحن نفهم على نحو متزايد ما يحدث بالضبط في الداخل عندما يتوقف النموذج ويقول لنفسه «دعني أعيد النظر».
أسئلة مفتوحة
لا تزال حدود قابلية التطبيق غير مرسومة بالكامل. فالتوجيه على طول اتجاه واحد أداة ضيقة: يلتقط جيدًا محور الاستبطان المكتشف، لكن ما الذي ينبغي فعله مع أنواع أخرى من التصحيح الذاتي — غير واضح. ويبقى أيضًا سؤال مدى قابلية الاتجاه المكتشف للنقل بين المعماريات: فلكل نموذج تمثيلاته الخاصة، وليس مؤكدًا أن متجهًا ينجح مع نموذج ما سيفيد مع آخر.
كما أن المقايضة بين التوفير والموثوقية في المهام التي يكون فيها الخطأ باهظ التكلفة ليست واضحة تمامًا. فتقليص 43.2% من الرموز مع الحفاظ على متوسط الدقة نتيجة قوية، لكن متوسط الدقة لا يعني غياب الإخفاقات الكارثية النادرة. والبحث عن كيفية التمييز بين الاستبطان «الزائد» وذاك الوحيد الذي ينقذ الإجابة هو — على الأرجح — المهمة التالية في هذا الخط من البحث.


