
الضبط الدقيق لنماذج توليد الصور: مراعاة التفضيلات والفئات معًا
تصف المقالة أسلوبًا للمواءمة اللاحقة للتدريب لنماذج تحويل النص إلى صورة في النطاق المفتوح، حيث تُستكمل إشارة التفضيلات البشرية بفحوص قائمة على معايير للتحقق من مدى مطابقة النتائج للمطالبات والخصائص المطلوبة. وتُظهر النتائج أن المتوسط المرجّح للمكافآت يحقق أداءً أدنى من المنهج المقترح، وأن Flux2dev وIdeogram-4 بعد الضبط الدقيق يحققان ارتفاعًا ملحوظًا في تصنيف Elo وفق لقطة Arena.
المهمة: المجال المفتوح وإشارتان
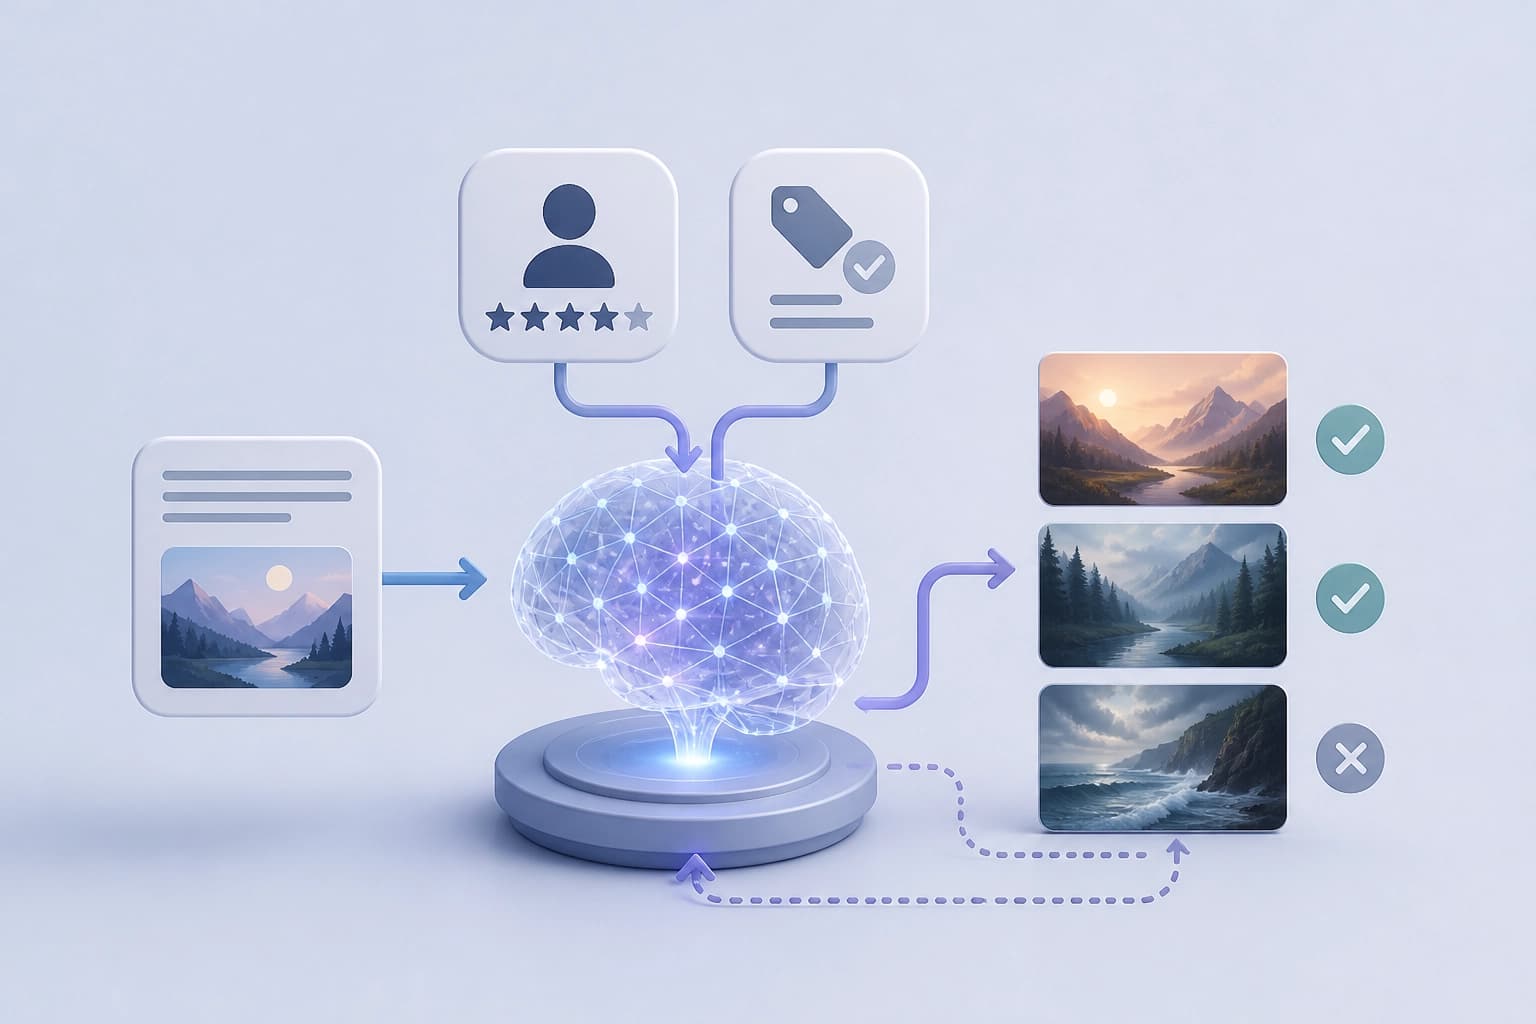
يتطلب توليد الصور من النص في المجال المفتوح مراعاة متطلبات مختلفة، منها التوافق مع الموجّه والتفضيلات البشرية. ولا تكفي إشارة مكافأة واحدة لتغطية كلا النوعين من المتطلبات. يقترح العمل «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» إجراء تدريب لاحق باستخدام مزيج من إشارات متكاملة.
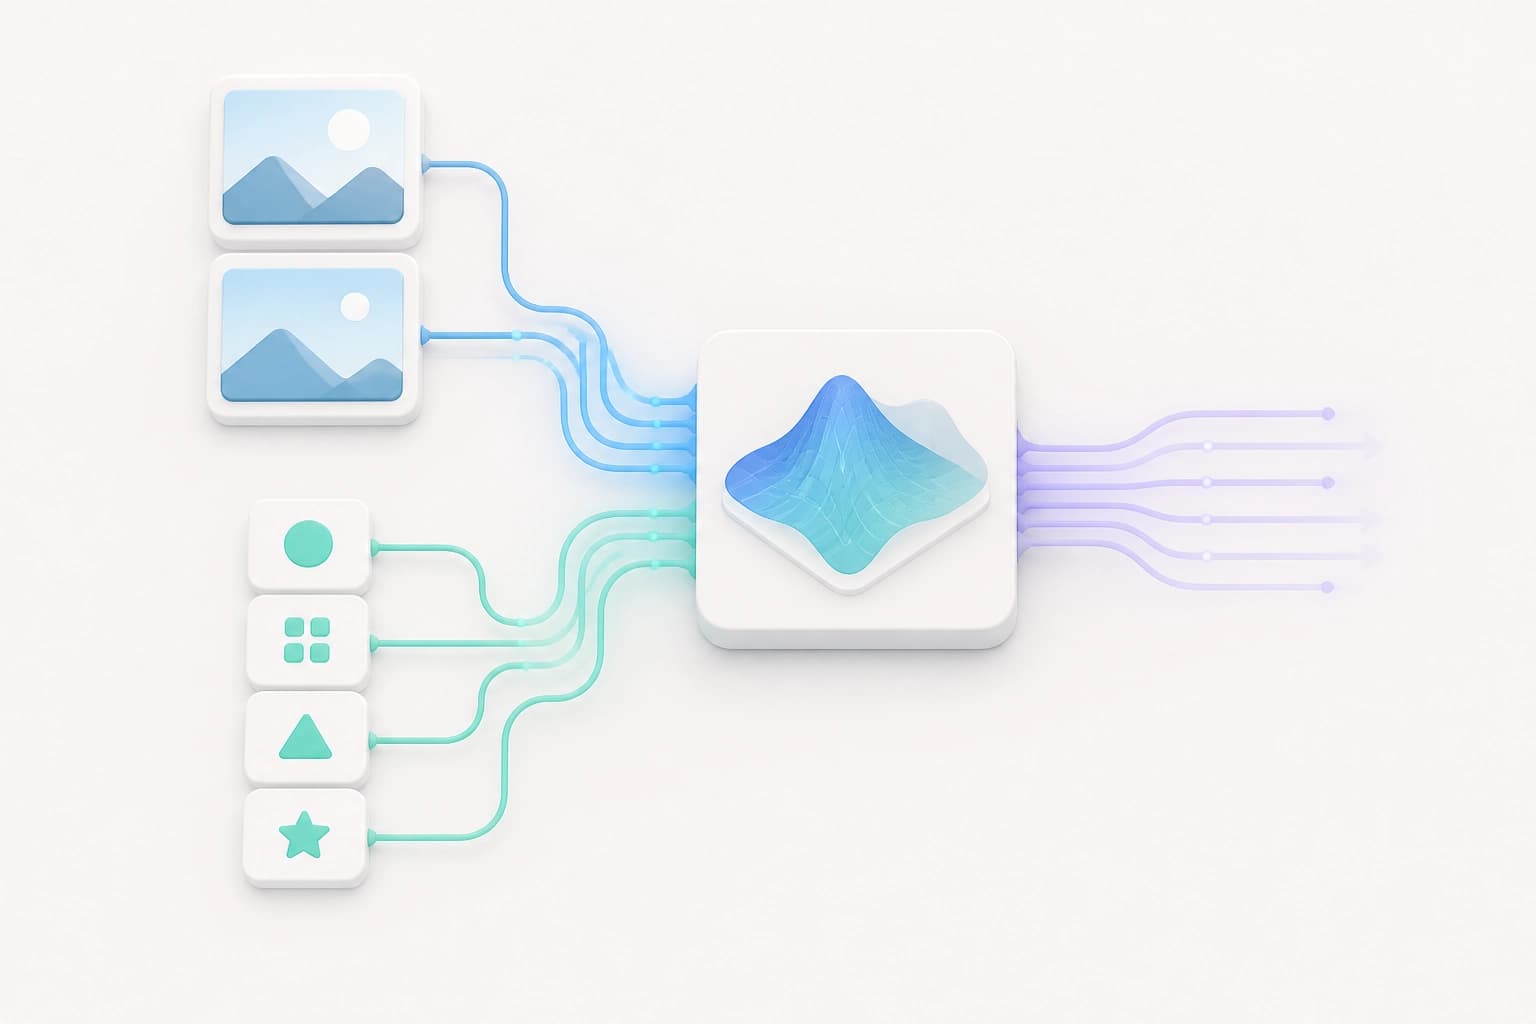
تجمع الطريقة بين المكافأة على التفضيلات والمكافآت القائمة على معايير التقييم. تعكس الإشارة الأولى التفضيلات البشرية. أما الثانية فتتحقق من التوافق مع الموجّه وخصائص أخرى مرغوبة. ويغطي هذا المزيج جوانب مختلفة من الطلب. الخلاصة: في المجال المفتوح، معيار الاختيار هو وجود إشارات متكاملة، لا إشارة واحدة. وينبغي أن تغطي الاختيار الذاتي وتنفيذ المهمة.
بنية نظام المكافآت
يتضمن النظام مكوّنين أساسيين. تُدرَّب المكافأة على التفضيلات باستخدام بيانات واسعة النطاق للتفضيلات البشرية. ويُستخدم Bradley-Terry objective في التدريب. وتعكس هذه الإشارة اختيارات الأشخاص.
تقيّم معايير التقييم التوافق مع الموجّه وخصائص أخرى مرغوبة. كما توفر حماية من reward hacking. ويؤدي المكوّنان مهمتين مختلفتين ويكمل أحدهما الآخر.
| المكوّن | ما يستند إليه | ما يتحقق منه | الدور |
|---|---|---|---|
| المكافأة على التفضيلات | بيانات واسعة النطاق للتفضيلات البشرية، Bradley-Terry objective | اختيارات الأشخاص عند مقارنة النتائج | تحسين التفضيلات |
| المكافآت القائمة على معايير التقييم | معايير تقييم تتضمن معايير محددة | التوافق مع الموجّه وخصائص أخرى مرغوبة | الحماية من reward hacking |
يحدد المؤلفون متطلبات المكافآت الفعّالة. إذ ينبغي أن تغطي نوايا المستخدمين على نطاق واسع، وأن تكون مقاومة للاستغلال أثناء التحسين.
الخلاصة: معيار الاختيار هو أن تكمل معايير التقييم التفضيلات، لا أن تحل محلها. فالنظام الذي يخلو من معايير التقييم يفقد الحماية من reward hacking. أما النظام الذي يخلو من التفضيلات فلا يستند إلى اختيارات البشر.
الجمع بدلًا من المتوسط البسيط
يفيد المؤلفون بوجود مشكلة في المتوسط المرجّح الساذج. إذ يؤدي هذا المتوسط أثناء التحسين إلى سلوك غير أمثل. ويقترح العمل استراتيجية للجمع بين المكافآت، تحقق توازنًا أكثر فاعلية بين تحسين التفضيلات وتنفيذ معايير التقييم.
| النهج | ما يحدث أثناء التحسين |
|---|---|
| المتوسط المرجّح الساذج | يصبح السلوك غير أمثل |
| استراتيجية الجمع | يتحقق توازن أكثر فاعلية بين تحسين التفضيلات وتنفيذ معايير التقييم |
تصبح استراتيجية الجمع جزءًا مستقلًا من الطريقة. الخلاصة: معيار الاختيار هو وجود استراتيجية للجمع، لا مجرد مجموعة من المكافآت. فالأوزان المخصصة للإشارات لا تضمن السلوك المطلوب من دون استراتيجية.
النتائج في تصنيف Arena text-to-image
في تصنيف Arena text-to-image، حصل نموذج Flux2dev على درجة Elo أعلى من النموذج الأساسي بـ69 نقطة. وخضع النموذج للتدريب بالتعلّم المعزّز. أما نموذج Ideogram-4، فتفوّق بعد التدريب اللاحق على جميع النماذج مفتوحة المصدر. وبلغت درجة Elo لديه 1223.5.
تُظهر هذه البيانات أثر التدريب اللاحق ضمن التصنيف، ولا تصف سيناريوهات استخدام أخرى.
| النموذج | النتيجة | المقارنة مع |
|---|---|---|
| Flux2dev المدرَّب بالتعلّم المعزّز | درجة Elo أعلى بـ69 نقطة | النموذج الأساسي |
| Ideogram-4 بعد التدريب اللاحق | درجة Elo تبلغ 1223.5 | جميع النماذج مفتوحة المصدر |
الخلاصة: معيار التقييم هو النظر إلى النموذج الأساسي وظروف التدريب. ويعرض المؤلفون بالنسبة إلى Flux2dev مقدار التحسن مقارنةً بالنموذج الأساسي. أما بالنسبة إلى Ideogram-4، فيحددون موقعه بين النماذج مفتوحة المصدر.
حدود لقطة التصنيف والبيانات
تتعلق الادعاءات بشأن النتائج المتقدمة بلقطة Arena بتاريخ 4 سبتمبر 2026. وتوثّق اللقطة حالة التصنيف في ذلك التاريخ. وأصدر المؤلفون Arena-T2I-Training، وهي مجموعة فرعية من بيانات التدريب حجمها 1K.
تتيح هذه المجموعة إعادة إنتاج جزء من التحسينات التي حققها التدريب الكامل، فيما يبقى جزء منها خارج نطاق المجموعة الفرعية. وللتحقق من الطريقة، من المهم التمييز بين النتيجة الكاملة والجزء القابل لإعادة الإنتاج.
الخلاصة: معيار الاختيار هو مراعاة تاريخ اللقطة وحدود قابلية إعادة الإنتاج. فالادعاء من دون هذه القيود يظل غير مكتمل.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
معيار Zero2Repo: حدود إنشاء مشروع بشكل مستقل من مجلد فارغ
تقترح الدراسة تقييم وكلاء البرمجة من خلال بناء المستودع كاملًا: المدخلات هي المواصفات وعقد الواجهة وبيئة فارغة، أما التقييم فيعتمد على اختبارات مخفية دون حكم من نموذج لغوي كبير. ونادرًا ما يجتاز حتى الوكلاء الرائدون جميع الاختبارات، إذ تعود النسبة الأكبر من الإخفاقات إلى نقاط منفردة من المتطلبات لم تُنفَّذ.
13 نوفمبر 2026
FedSocket: نماذج قابلة للتبادل مع اشتراط إمكانية تنفيذها لدى المستلِم في ظل التباين متعدد الوسائط
يُقدَّم FedSocket بوصفه نهجًا يشترط أن يكون النموذج المتبادل قابلًا للتشغيل على جهة المستلِم، ويربط بين النماذج الخاصة المتباينة واجهةُ تنبؤات مشتركة تُسمى Q. وتصف المقالة التجميع مع مراعاة الانتماء، وإرسال معلمات Q وحدها إلى جانب العدّادات، وتجارب على ست مجموعات بيانات تُظهر تحسن الدقة عند غياب بعض الوسائط وتفوّق الاستدلال المشترك (Joint) على التجميعات المستقلة.
13 نوفمبر 2026
CyberArena: مواجهات ثنائية بين وكلاء الذكاء الاصطناعي تكشف حدود المعايير السيبرانية الثابتة
يضع المعيار وكيلين في بيئات معزولة تضم خدمات تتغير باستمرار، ثم يحوّل أفعالهما على مدار سلسلة من الجولات إلى درجات متعددة الأبعاد للمهارات الهجومية والدفاعية. وفي 466 مباراة شملت 12 نموذجًا متطورًا، ميّز بين القدرات في الحالات التي تبلغ فيها الاختبارات أحادية الجانب سقفها، بما في ذلك التخطيط لعدة خطوات وإنشاء الأبواب الخلفية.
13 نوفمبر 2026