لماذا احتاج الوكلاء إلى قياس آخر
تجيب معظم معايير تقييم الوكلاء عن أسئلة واضحة: هل اختار النموذج الأداة الصحيحة، وهل جمع الوسائط بشكل صحيح، وهل وصل إلى النتيجة المطلوبة. وتقوم جميع هذه القياسات تقريبًا على التنفيذ التسلسلي — استدعاء تلو الآخر، دون عجلة أو تنافس على الموارد.
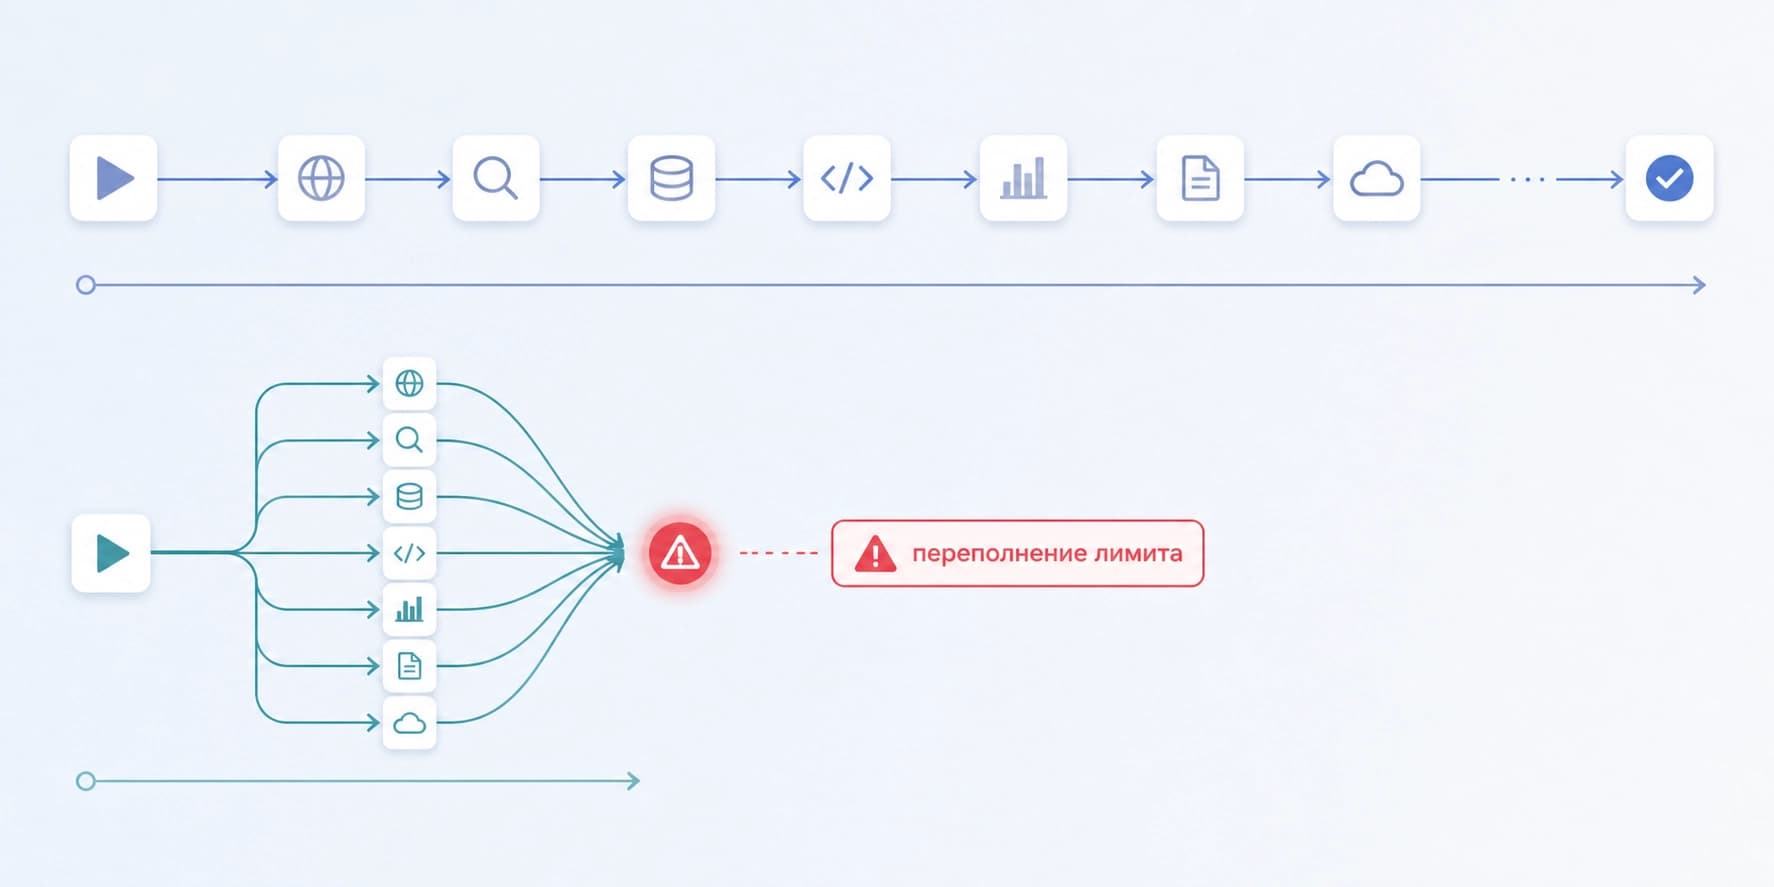
لكن التشغيل الفعلي يبدو مختلفًا. فلكي يبقى الوكيل ضمن زمن استجابة مقبول، عليه تشغيل الاستدعاءات المستقلة بالتوازي. لكن التوازي دون مراعاة للحدود يصطدم بحائط آخر: حصص مستنفدة، وذاكرة ممتلئة، وخدمة خارجية متوقفة.
يتناول PeakBench هذه المنطقة العمياء تحديدًا. ويصفها المؤلفون Zhi-Kai Chen وXu-Xiang Zhong وSong-Yan Li وDe-Chuan Zhan وHan-Jia Ye في مسودة على arXiv:2608.24509 (الإصدار الأول بتاريخ 25 أغسطس 2026، ضمن تصنيفي cs.AI وcs.SE)؛ ويعدون بنشر الشيفرة مع الورقة.
الفكرة المحورية التي ينبع منها العمل كله: لدى الوكيل طريقتان للفشل، وهما متعارضتان. التنفيذ التسلسلي آمن لكنه بطيء — فلا تُتجاوز الحدود لمجرد أن شيئًا لا يجري في الوقت نفسه. أما التوازي دون مراعاة للموارد فسريع، لكنه يؤدي إلى تجاوزات كان يمكن تفاديها بسهولة. وبين هذين الطرفين يقع ما لم يقسه أحد على نحو جدي.
ما هو هذا المعيار
بدلًا من المهام الساكنة ذات الإجابات المرجعية، تُستخدم هنا مسارات عمل قابلة للتنفيذ ومتعددة الأدوات. ولكل منها إضافتان مهمتان: تعليقات التبعيات التي تُظهر أي الخطوات مرتبطة فعلًا ببعضها، وملفات الموارد المقيسة — كم من الذاكرة أو الوقت أو الحصة يستهلكه استدعاء معيّن.
هذا البناء يغيّر موضوع التقييم نفسه. فيتراجع سؤال «هل جاءت الإجابة صحيحة» إلى الخلفية، ويتقدم إلى الواجهة سؤال «كيف وزّع الوكيل العمل عبر الزمن، وهل تجاوز الميزانية».
التخطيط المنطقي مقابل التخطيط الفعلي
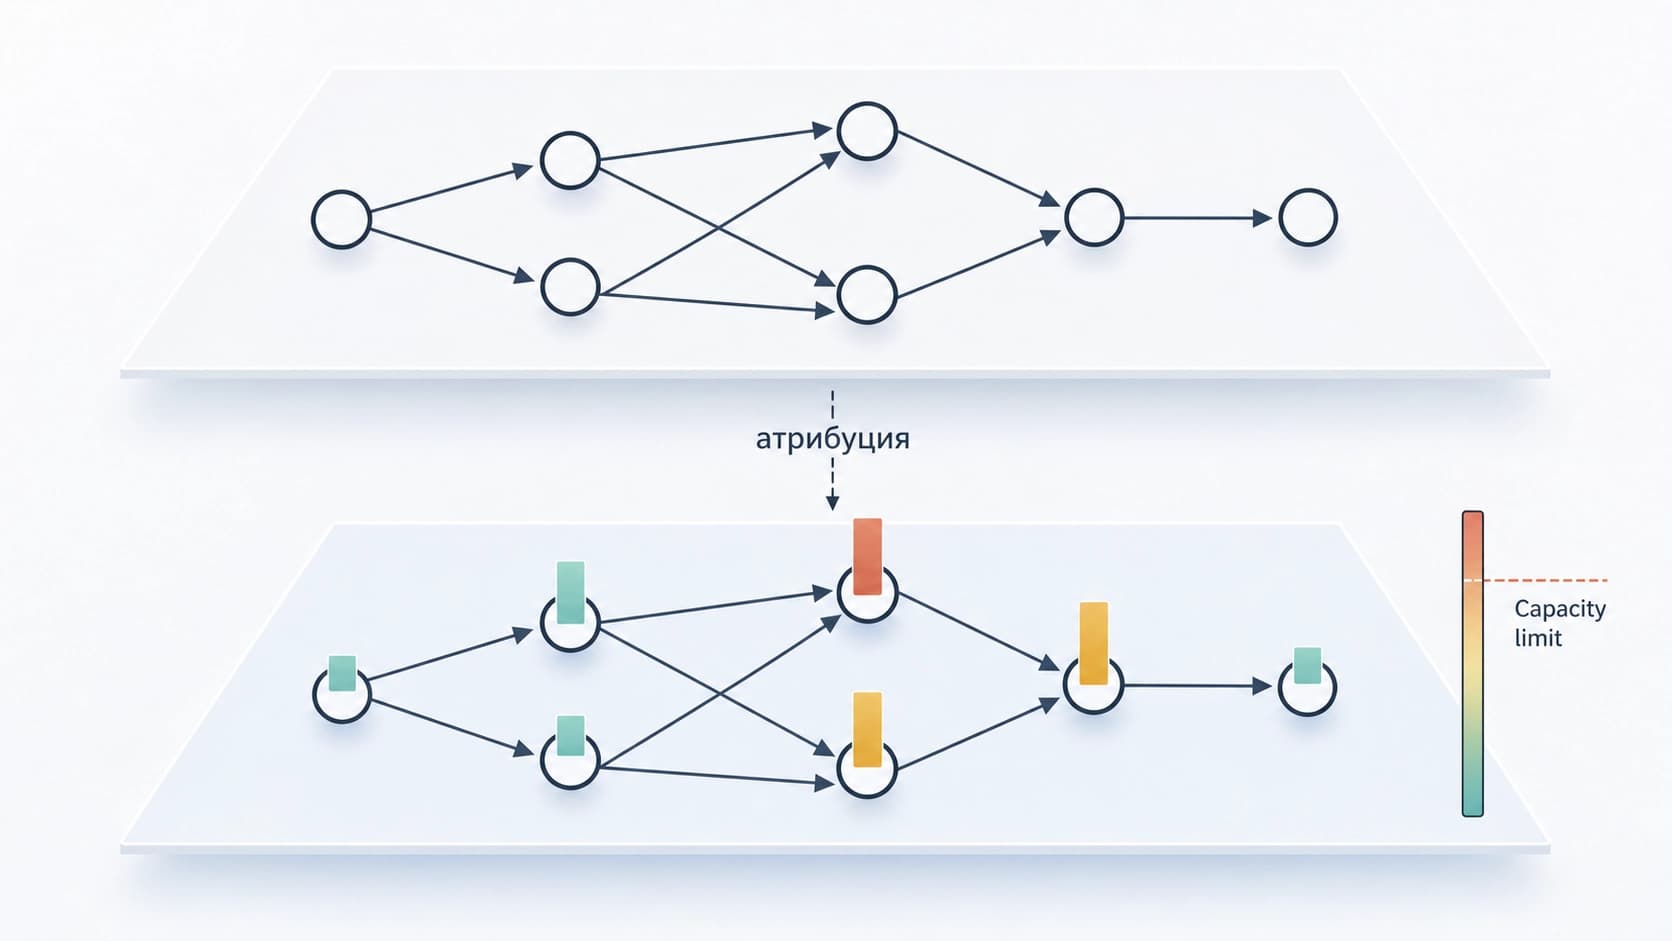
تكمن الصعوبة المركزية في تقييم مثل هذه المسارات في الإسناد. فعندما ينهار تشغيل ما، لا يتضح ما المسؤول بالضبط: هل أخطأ الوكيل في تحليل التبعيات، أم حلّلها بشكل صحيح لكنه لم يحسب الموارد المتاحة، أم الاثنان معًا. وحشر كل شيء في مقياس نجاح واحد يعني فقدان أنفع ما في الأمر.
لذلك قُسّم التقييم إلى جزأين. يقيس أحدهما التخطيط المنطقي: ترتيب الخطوات، وصحة التبعيات، وغياب روابط مختلقة. ويقيس الآخر التخطيط الفعلي، أي الجدولة مع مراعاة القيود الحقيقية. ولكل من هذين البُعدين مقاييسه الخاصة، فلا يخفي الفشل في أحدهما النجاح في الآخر.
الترتيب الخاطئ والميزانية الخاطئة — مرضان مختلفان
لا يُقصد بالمخطط الثنائي تصنيف أنيق، بل تشخيص دقيق. فإذا أخطأ الوكيل على مستوى المنطق، فلا جدوى من إخباره بحجم الحصة — فهو لم يفهم ما يعتمد على ما. وإذا كان المنطق سليمًا لكن التنفيذ ينهار، فالمشكلة في المجدول أو في طريقة إبلاغ الوكيل بالموارد المتاحة.
والخلاصة العملية لمن يبنون أنظمة الوكلاء: قبل إصلاح أي شيء، يجدر فهم الطبقة التي ينتمي إليها العطل. فهندسة الأوامر، والتدريب على المسارات، وتعديل الأدوات — كلها تعالج أعطالًا مختلفة تمامًا.
النتيجة الرئيسية: المنطق المتقن لا يحمي من الإفراط في التحميل
أكثر ما يزعج في نتائج العمل هو هذا: التخطيط المنطقي القوي لا يضمن تنفيذًا آمنًا ولا فعّالًا في ظل قيود الموارد. فقد يبني الوكيل رسم التبعيات بإتقان تام — ومع ذلك يُسقط النظام بتشغيل كل ما لا تربطه به حواف دفعة واحدة.
الإفصاح عن الموارد يقلل عدد التجاوزات القابلة للتفادي
الملاحظة الثانية: إذا مُنح الوكيل معلومات عن الموارد المتاحة، انخفض عدد التجاوزات القابلة للتفادي وارتفع معدل الاستفادة. وهذا ليس سحرًا ولا معمارية جديدة — بل مجرد إدخال الميزانيات التي يجب الالتزام بها إلى السياق، إلى جانب أوصاف الأدوات.
ومن المهم هنا ألا نبالغ في تقدير الأثر. فالحديث عن أن الشفافية في الموارد تدخّل رخيص وفعّال، لا عن أنها تحل المشكلة بالكامل: إذ يبقى على الوكيل أن يستعمل هذه المعلومات ببراعة.
لمن يفيد هذا
صُمّم هذا المعيار ليكون منصة لتشخيص سلوك الوكلاء الواعين بالموارد، وهذا غايته الأساسية. فهو لا يمنح درجة نهائية بقدر ما يُظهر أين ينكسر النموذج تحديدًا: في فهم التبعيات أم في انضباط الإنفاق.
ومن هنا تبرز عدة سيناريوهات للاستخدام. لمطوّري أطر الوكلاء — وسيلة لاختبار المجدول قبل الإنتاج لا بعد وقوع حادث. وللباحثين — إطار قابل لإعادة الإنتاج لتجارب الميزانيات في السياق. ولمن يختارون نموذجًا لمهمة ذات حدود صارمة — فرصة لرؤية الفرق بين النماذج، وهو فرق لا تُظهره اختبارات النجاح العادية.
ما يجدر وضعه في الاعتبار
لهذا المنهج كلفة دخول واضحة: يجب قياس ملفات الموارد، ووسم التبعيات. وفي الأنظمة الحقيقية تشوّش الحدود، وتغيّر الخدمات الخارجية سلوكها تحت الحمل، وليست كلفة الاستدعاء معروفة دائمًا مسبقًا. فالدقة المخبرية هنا أعلى منها في الميدان، ولا يجدر نقل الاستنتاجات كما هي إلى بيئة الإنتاج.
لكن الإطار نفسه مفيد حتى دون المعيار. فالسؤالان — «هل فهم الوكيل بشكل صحيح ما يعتمد على ما» و«هل التزم بالميزانية» — من المنطقي طرحهما على أي نظام وكلاء، حتى لو لم تتوفر منصة جاهزة لاختبارهما.