
نهج OWP: إعادة توزيع الأدلة والإشارات القبلية في Omni-LLM
يقدّم إطار Omni-Woodpecker، الذي لا يتطلب تدريبًا، طريقةً لاكتشاف التعارضات بين الأنماط، ويعيد ضبط التوازن بين بيانات السياق والانحيازات المكتسبة في الحالات الكامنة قبل فك الترميز. وعلى Qwen2.5-Omni-7B وVideoLLaMA2-AV، يعزّز الأسلوب المتانة في مواجهة الأخطاء السمعية البصرية على CMM وAVHBench، ويحقق تحسنًا معتدلًا على معايير الاستدلال العامة.
ما هو OWP وما المشكلة التي يعالجها
Omni-Woodpecker (OWP) إطار عمل لا يتطلب التدريب لتصحيح الهلوسات متعددة الوسائط لدى نماذج Omni LLMs. ينقل هذا المنهج التصحيح من مستوى المخرجات إلى إعادة موازنة التمثيلات الناجمة عن تعارض الوسائط. قدّم المؤلفون الورقة في 19 أكتوبر 2026: Zijian Liu، وChaoyou Fu، وYan Yang، وCaifeng Shan، وRan He.
يعالج التصحيح التقليدي الإجابة الجاهزة. أما OWP فيتدخل في التمثيلات الداخلية قبل فك الترميز. وهذا يغيّر موضع تطبيق المنهج.
الخلاصة: يغيّر OWP موضع التصحيح، ولا يعدّل الإجابة الجاهزة.
مراحل إعادة توزيع الأدلة والإشارات المسبقة
ينفّذ OWP إعادة الموازنة على مراحل عدة. يبدأ المنهج بتحديد التعارضات متعددة الوسائط استنادًا إلى التمثيلات الإضافية للوسائط المنفردة.
- تحديد التعارضات متعددة الوسائط استنادًا إلى التمثيلات الإضافية للوسائط المنفردة.
- التحليل المتعامد للحالات الكامنة لفصل أدلة الإرساء عن التقديرات المسبقة المنافسة.
- إعادة الموازنة التكيفية للتمثيلات المدمجة: كبح التقديرات المسبقة المضللة واستعادة الأدلة التي جرى تجاهلها.
- تمرير التمثيلات المصححة إلى فك الترميز.
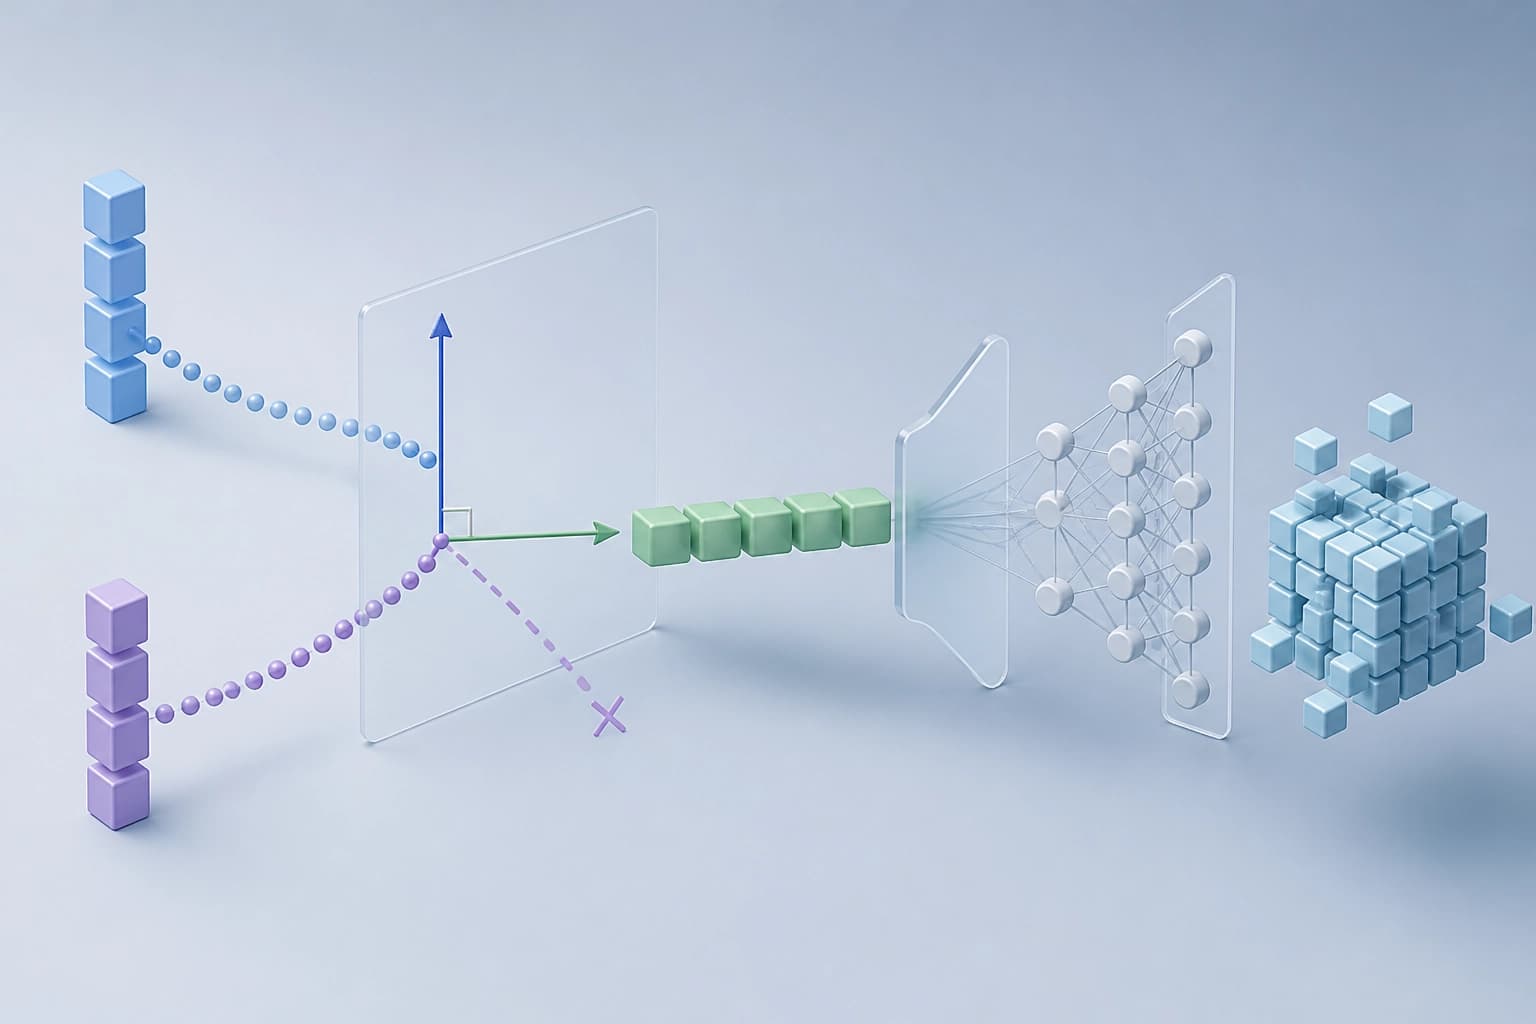
لا يغيّر المنهج أوزان النموذج. بل يصحح التمثيلات قبل التوليد.
الخلاصة: لا يتطلب OWP تدريبًا أو تعديلات على الأوزان. فهو يؤثر في الحالات الكامنة قبل فك الترميز.
النتائج: تحسّن الأداء في المعايير المرجعية وقابلية النقل
على Qwen2.5-Omni-7B، يرفع OWP النتائج بمقدار 12,9 و8,6 نقطة في CMM وAVHBench. وعلى أربعة معايير مرجعية عامة للاستدلال لدى OLLM، يتراوح التحسن بين 0,67 و2,25 نقطة.
| النموذج | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 نقطة | +8,6 نقطة |
| VideoLLaMA2-AV | +4,6 نقطة | +3,9 نقطة |
أظهر المنهج قابلية للنقل إلى VideoLLaMA2-AV، مع تحسن قدره 4,6 و3,9 نقطة في CMM وAVHBench. ويذكر المؤلفون أن المنهج فعّال وقابل للنقل بين البنى المعمارية. الشيفرة متاحة للجمهور.
الخلاصة: يعتمد مقدار التحسن على النموذج والمعيار المرجعي. المعيار العملي: يُستحسن اختبار OWP على البنية المعمارية ومجموعة المهام المستهدفتين قبل اعتماده.
معايير عملية لاختيار OWP
يناسب OWP حالات تتوافر فيها عدة شروط. يعمل المنهج دون تدريب ودون تغيير أوزان النموذج.
- الحاجة إلى تصحيح الهلوسات متعددة الوسائط دون تدريب.
- توافر الحالات الكامنة والتمثيلات الخاصة بالوسائط المنفردة.
- الحاجة إلى التدخل قبل فك الترميز، بدلًا من المعالجة اللاحقة للإجابة.
- إمكانية إعادة تطبيق المنهج: الشيفرة متاحة للجمهور.
OWP طريقة لا تتطلب التدريب لإعادة موازنة الأدلة والإشارات المسبقة. ويذكر المؤلفون أنها قابلة للنقل بين البنى المعمارية. ويظل اختبارها على نموذج محدد خطوة ضرورية.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
LightCRS: مخطط مدمج متعدد المجالات للتوصيات الحوارية دون نموذج VLM منفصل لكل فئة
يقدّم المؤلفون نظامًا تُستخرج فيه السمات متعددة الوسائط للمنتجات مسبقًا دون اتصال باستخدام مُرمِّزات مجمّدة، ثم تعالجها أثناء الحوار وحدة مشتركة بين جميع المجالات تضم 5.3 مليون مُعامل، وتستخدم انتباهًا متقاطعًا يعتمد على الاستعلام. وعلى معيار قياس يضم 25 مجالًا، يحسّن هذا النهج متوسط مقاييس الترتيب، ويقلّل زمن الاستجابة بشكل ملحوظ، ويُظهر أن التدريب المشترك يحقق مكاسب مقارنةً بالنماذج المنفصلة أحادية المجال.
16 نوفمبر 2026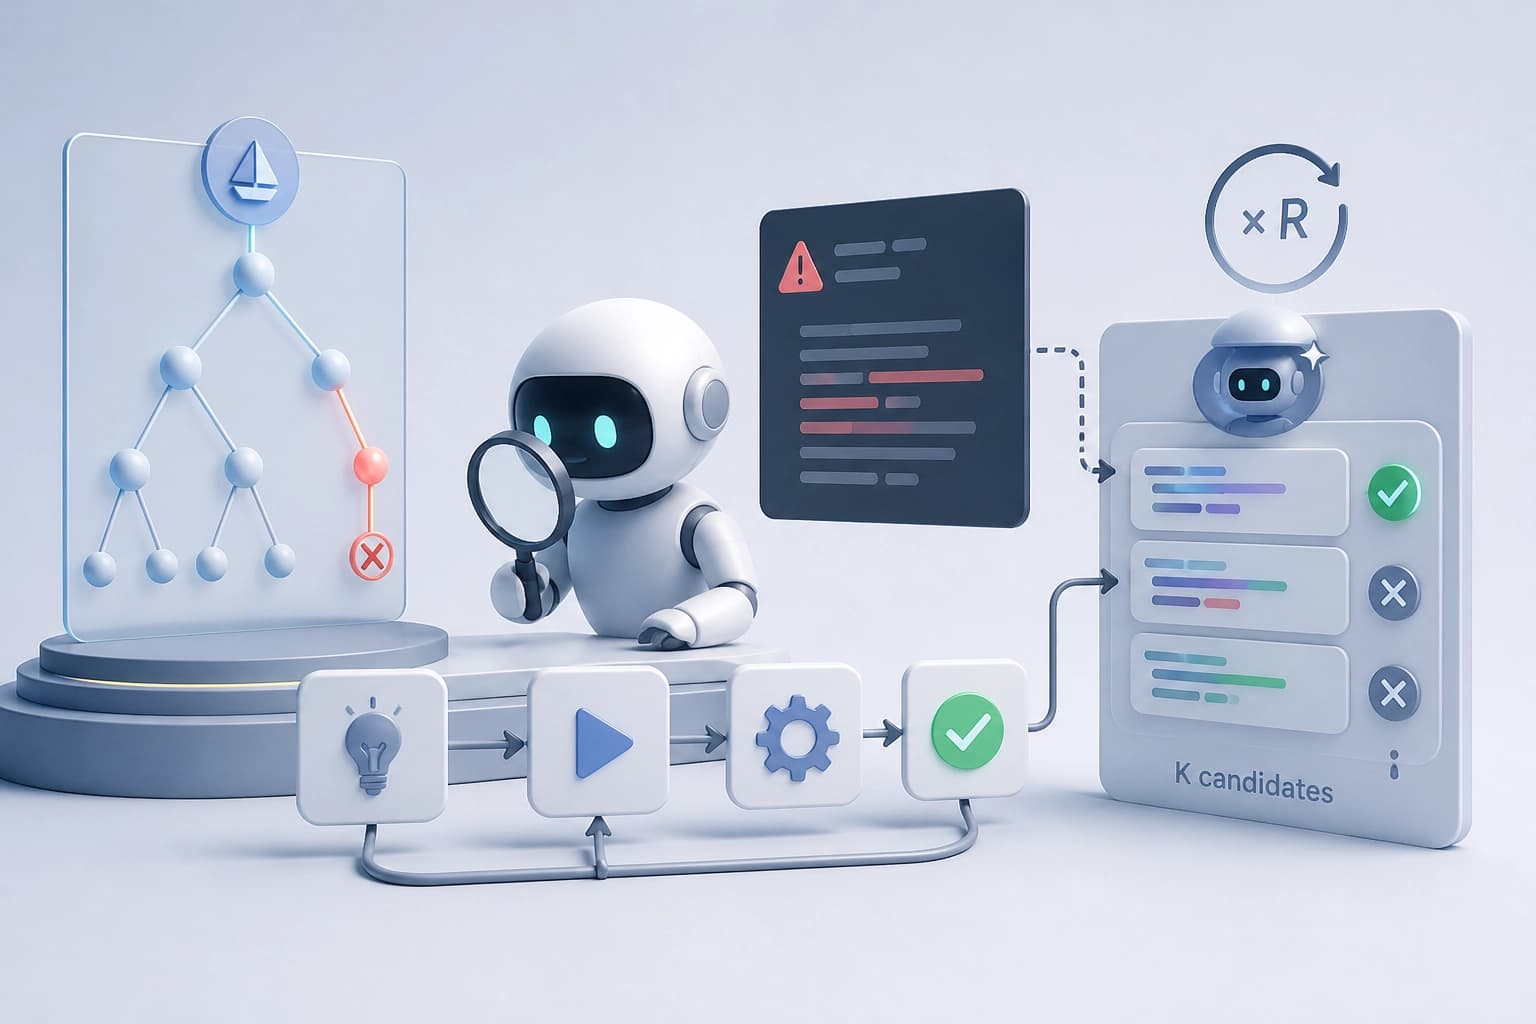
إصلاح محدود للتكتيكات في Lean 4 بالاستناد إلى تشخيصات المترجم
يُقدَّم مكوّنٌ تدريجي لا يتخلّص من التكتيك المرفوض، بل يكلّف نموذجًا مصحِّحًا بإصلاحه استنادًا إلى خطأ Lean حتى R مرات؛ ومع وجود K مرشحين، يرفع ذلك نسبة المسائل المحلولة. وتُظهر التجارب على LeanDojo وLean Workbook أن التحسّن يعود أساسًا إلى حالات الإخفاق السطحي أثناء التنفيذ، على حساب زيادة زمن البحث.
16 نوفمبر 2026
طريقة Genesis Steering: توجيه التنشيطات باستخدام البيانات المستخدمة في الضبط الدقيق
تستخلص الطريقة متجه التحكم من أمثلة متباينة موجودة في بيانات الضبط الدقيق، وعند تعذّر الوصول إليها، تنتقي عينات التدريب المرجّحة عبر استدلال العضوية وتكوّن مجموعة بيانات بديلة. يصف الجزء النظري الإزاحة المثلى نحو حدّ القرار والتقدير بالاستناد إلى البيانات البديلة؛ وتُظهر البيانات الداخلية لـ Tülu-3-8B أثرًا أوضح تجريبيًا من المجموعات الخارجية، في حين أن فائدة البيانات البديلة المستخلصة عبر MIA على Llama-3.1-8B-Instruct محدودة بسبب نسبة إزاحات الاتجاه.
16 نوفمبر 2026