
تعد OpenAI: شريحتها Jalapeño ستكون أسرع وأكثر اقتصادية من حلول المنافسين
تدّعي الشركة أن المعالج المخصص للاستدلال، الذي طُوّر بالتعاون مع Broadcom، يتفوق على مسرعات Nvidia من حيث كفاءة الطاقة وسرعة الاستجابة في اختبارات على عدة نماذج ذكاء اصطناعي. وتخطط لنشر الرقائق بكميات صغيرة قبل نهاية العام، لكنها لا تعتزم استبدال أسطول Nvidia بالكامل.
تستثمر OpenAI في شريحة Jalapeño: أسرع، وأكثر اقتصادية، وعلى وشك الوصول إلى السوق
عندما يتعلق الأمر بنشر نماذج لغوية كبيرة، يضطر المهندسون باستمرار إلى البحث عن حل وسط: إما أن يستجيب النظام بسرعة كبيرة، لكنه يجد صعوبة في تحمل تدفق الطلبات، أو أنه قادر على استيعاب أحمال هائلة، ولكن على حساب تأخيرات ملحوظة. في OpenAI، هم واثقون من أنهم وجدوا الحل الذي يزيل هذا التناقض. الشريحة الخاصة بالشركة، التي تحمل اسم Jalapeño، وفقًا لتصريحات المطورين، تُظهر في الوقت نفسه زمن استجابة منخفضًا وإنتاجية عالية. وفقًا لنائب رئيس OpenAI للأجهزة، ريتشارد هو، تقدم الجديدة "أفضل ما في العالمين".
Jalapeño ليس معالجًا عامًا، بل دائرة متكاملة مخصصة (ASIC)، تم إنشاؤها بالشراكة مع Broadcom. الشريحة مصممة خصيصًا لمهمة محددة — وهي الاستدلال (inference)، أي التشغيل المباشر للنماذج المدربة لتنفيذ المهام وعمل الوكلاء. تم الإعلان عنها في يونيو الماضي، وهي الآن تحصل لأول مرة على نتائج اختبارات رسمية، والتي لا تتردد الشركة في وصفها بالثورية.
ما الذي أظهرته اختبارات الأداء
لتقييم قدرات الشريحة، استخدمت OpenAI منصة القياس الخاصة بها InferenceX. كمعيار للمقارنة، تم أخذ أفضل النتائج المسجلة على الرقاقات الفائقة Nvidia GB200 وGB300. أُجريت الاختبارات على ثلاثة نماذج شائعة: GPT-OSS 120B وDeepSeek R1 وKimi K2.5 1T.
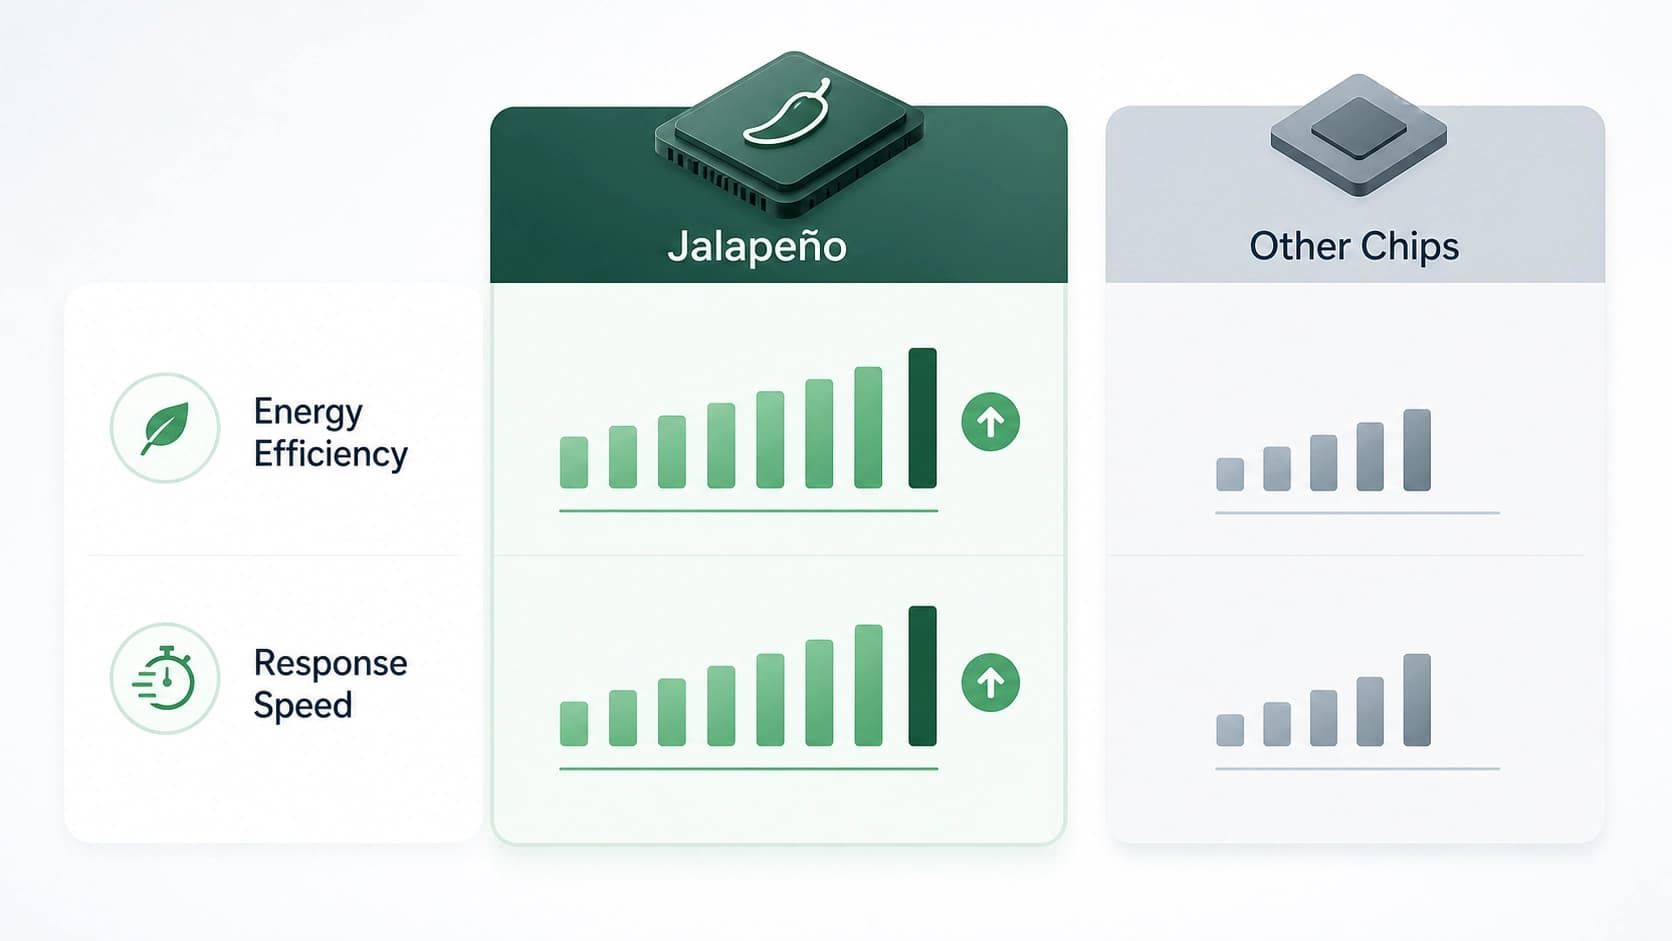
تدّعي الشركة أن النتائج كانت مثيرة للإعجاب. اعتمادًا على النموذج، أظهر Jalapeño زيادة في الحسابات لكل واط تتراوح بين 1.5 إلى 1.9 مرة مقارنة بأنظمة المنافسين. ببساطة، هذا يعني أنه مقابل كل كيلوواط من الطاقة المستهلكة، تقوم الشريحة الجديدة بقدر أكبر بكثير من العمل المفيد. هذا أمر بالغ الأهمية في عصر أصبحت فيه فواتير الكهرباء لمراكز البيانات واحدة من بنود الإنفاق الرئيسية.
الفارق في سرعة الاستجابة أكثر وضوحًا. كان زمن الاستجابة الشامل على النماذج الثلاثة المختبرة أقل بمقدار 1.7 إلى 3.6 مرة مقارنة بالأنظمة المرجعية القائمة على رقاقات Nvidia. عمليًا، يترجم هذا إلى استجابات أسرع من المساعدين، وإجراءات أكثر استجابة لوكلاء الذكاء الاصطناعي، ووصولًا مستقرًا إلى الخدمات حتى في أوقات الذروة. كلما أسرع النموذج في معالجة الطلب، قلّ اضطرار المستخدم إلى النظر إلى مؤشر "الكتابة" الخاص بالرد.
الاستراتيجية: ليست بديلاً، بل إضافة
على الرغم من هذه المؤشرات الممتازة، لا تنوي OpenAI التخلي عن التعاون مع Nvidia. يؤكد ريتشارد هو أن استراتيجية الحوسبة الشاملة للشركة تفترض استخدام مجموعة واسعة من الشركاء، وتبقى Nvidia واحدة من الشركاء الرئيسيين. لن يحل Jalapeño محل أسطول الرقاقات الحالي، بل سيصبح عنصرًا مهمًا في توسيع نطاق البنية التحتية.
يُخطط لنشر الجيل الأول من الشريحة "بكميات صغيرة" قبل نهاية العام الحالي. سيبدأ التوسع الكامل في القدرات في عام 2027. تتعمد الشركة عدم الكشف عن العدد الدقيق للرقاقات التي تخطط لاستخدامها في العام المقبل. في الوقت نفسه، يجري العمل بالفعل على الجيلين الثاني والثالث من Jalapeño، مما يشير إلى الطبيعة طويلة الأمد لهذا الاتجاه — على عكس العديد من التجارب التي لا تصل أبدًا إلى المرحلة العملية.
يمكن أن يؤدي نجاح هذا المشروع إلى تقليل اعتماد مشغلي نماذج الذكاء الاصطناعي الكبيرة على عدد محدود من موردي الرقاقات بشكل كبير. تسمح دوائر ASIC المخصصة بمواءمة البنية بشكل أكثر دقة مع الخوارزميات وأحمال العمل المحددة لشركة OpenAI، مما يوفر الموارد ويسرع طرح منتجات جديدة في السوق.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
الثوابت كثيرة الحدود القانونية في تشخيص أعطال محاكيات التعلم المعزز: أين تكون مفيدة حقًا
تبحث الدراسة مدى جدوى إدراج القوانين الفيزيائية في نماذج الديناميكيات المتعلَّمة: فالثوابت المستخلصة من المسارات والمحوَّلة إلى صيغة معيارية باستخدام قواعد غروبينر تحقق تحسناً متواضعاً في التنبؤات، لكنها فعّالة في التشخيص، إذ تتيح تحديد موضع القيد المنتهك والكشف عن المعلمة الخاطئة بعينها.
10 نوفمبر 2026
AURA-Eval: كيفية التحقق من أن وكيل LLM قد أدرك المخاطر وغيّر خطوته التالية
يقيّم هذا الإطار سلوك وكلاء LLM لا استنادًا إلى الحكم النهائي، بل إلى استجابتهم للمخاطر عند نقاط محورية: إذ تُقطع مسارات استدعاء الأدوات، ثم يُطلب من النموذج مواصلة الاستدلال والتصرف، بينما تحلل لجنة من محكّمي LLM رصد المخاطر وطبيعة الخطوة ومدى أمانها. وفي 1249 مهمة جُمعت من 157 مسارًا لـ R-Judge، ازداد تواتر التصرفات غير الآمنة لدى 20 نموذجًا عند غياب مسار آمن، كما أدى رفع الإشراف قبل التنفيذ إلى تحويل 52,3% من الحالات الآمنة في الأصل إلى حالات غير آمنة.
10 نوفمبر 2026
ذاكرة خزان تشيرن-سايمونز: ديناميكيات الترابط الذاتية ونقل الكثافة
تتناول المقالة كيفية احتفاظ الخزان بتاريخ الإشارات الواردة في كلٍّ من توزيع الكثافة ودرجات الحرية الهندسية. وتُظهر مقارنة أربعة آليات أن التيار ينشئ مكوّنًا منفصلًا من مكوّنات الاتصال، يغيّر استجابة الكثافة لاحقًا، وأن أخذ جميع السمات المقاسة في الحسبان يحقق تحسنًا طفيفًا في فك ترميز ترتيب النبضات.
10 نوفمبر 2026