
NAQD-Env: التعليق الانتقائي للعمليات لدى الوكلاء اللغويين
نُشر معيار اصطناعي يحدّد فيه مرجع حتمي التبعيات بين البيانات والأذونات والقيود، بينما يُفترض بالنماذج إيقاف الخطوات المتأثرة فقط دون فقدان بقية العمل. كشفت اختبارات ثلاثة نماذج مفتوحة عن انخفاض معدل الإيقاف وغياب الاستئنافات الصحيحة؛ إذ تحسّن الضبط الدقيق دقة القرارات، لكنه يتسبب في آثار جانبية.
جوهر الإيقاف الانتقائي
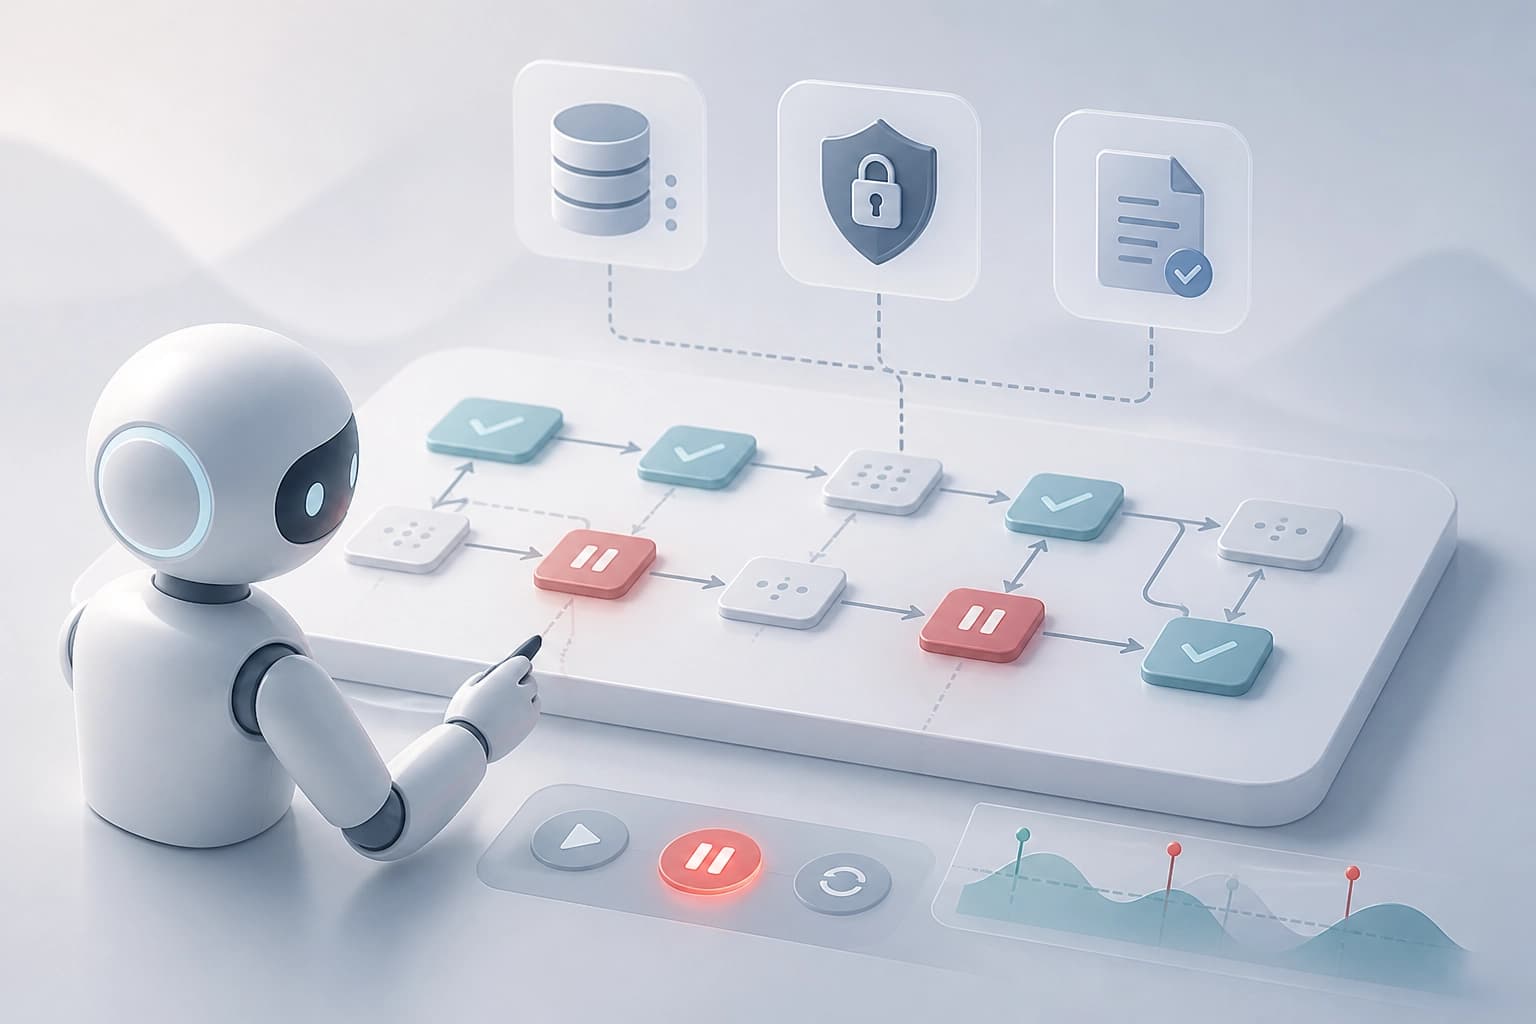
NAQD Env بيئة اصطناعية لتقييم قرارات الوكلاء اللغويين بشأن الإيقاف الانتقائي للأفعال. السياسة المرجعية حتمية. وتعتمد على تبعيات محددة صراحةً بين الأدلة والأذونات والقيود. عند تغيّر الأدلة أو سحب الإذن أو تلقي تعليمات بالتوقف، ينبغي للوكيل تعليق الأفعال المتأثرة. أما العمل غير المتأثر فيُبقيه الوكيل مستمرًا. ولا يستأنف الأفعال إلا بعد معالجة كافية. المعيار: تختبر البيئة انتقائية الإيقاف، لا التوقف الكامل.
آلية التقييم
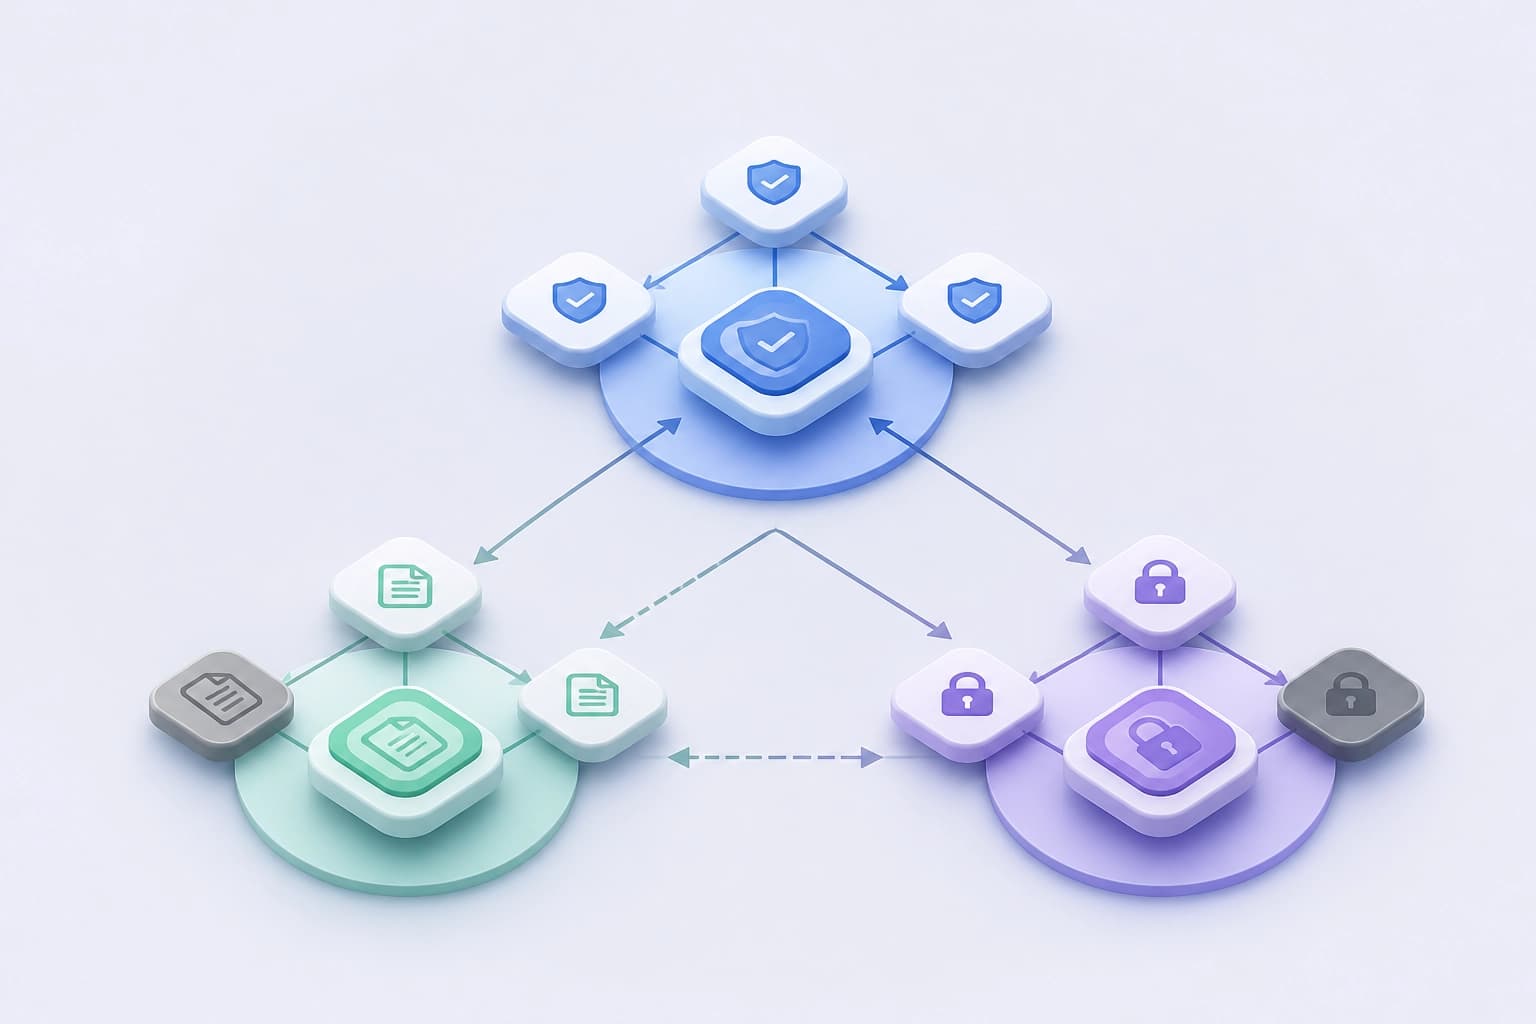
يستخدم التقييم 11 عائلة من التبعيات. وتشمل المجموعة بُنى مخصصة للتطوير، وعائلات مؤجّلة، ومجموعات مؤجّلة من البُنى. وتحتسب المقاييس محاولات الانتهاك والانتهاكات التي ترتكبها آلية التنفيذ المحاكاة كلٌّ على حدة. وتعكس المقاييس المشتركة مدى الالتزام بالسياسة، وقيمة المهمة، وإيقاف الأفعال، واستئنافها، والإبلاغ عن الأحداث. وتفصل هذه المجموعة بين النية والانتهاك الفعلي. كما تربط السلامة بالمنفعة والتواصل. المعيار العملي: النظر إلى المقاييس مجتمعةً، لا إلى مجرد التوقف.
النتائج على ثلاثة نماذج
قيّمت الدراسة ثلاثة نماذج ذات أوزان مفتوحة. وهي مضبوطة على اتباع التعليمات وتنتمي إلى عائلتين. واستُخدمت ثلاثة إعدادات للموجّه و350 سيناريو مثبتًا. وبلغ إجمالي الحلقات 3 150 حلقة من نوع «النموذج—الموجّه» قبل إعادة تشغيلها عبر آلية التنفيذ. في الظروف التي جرى النظر فيها، لم يتجاوز معدل استدعاء إيقاف الأفعال 0.06. ولم يُلاحظ أي استئناف صحيح عند توفر الفرص المناسبة. ولم تتوافق سوى حلقة واحدة بالكامل مع السياسة المرجعية.
مقارنة النماذج باستخدام موجّه NAQD:
| النموذج | الملاحظة |
|---|---|
| Qwen2.5-7B | حلقات أقل تتضمن محاولات غير آمنة مقارنةً بـ Qwen2.5-3B وLlama-3.1-8B. لكن العمل المفيد أقل، والحفاظ على الأفعال غير المتأثرة أقل دقة. |
| Qwen2.5-3B | في تجارب الضبط الدقيق المنضبط، ارتفعت دقة القرارات من 0.45–0.54 إلى 0.83–0.92. |
| Llama-3.1-8B | أداؤه أدنى من Qwen2.5-7B في مقارنة المحاولات غير الآمنة. |
الخلاصة: حتى مع موجّه مخصص، نادرًا ما تتبع النماذج السياسة المرجعية بالكامل. وقد يؤدي تحسين السلامة إلى تقليل العمل المفيد. المعيار العملي: التحقق ليس من محاولات الانتهاك فحسب، بل أيضًا من الحفاظ على الأفعال غير المتأثرة.
قيود البيئة والضبط الدقيق
تقيّم البيئة تطبيق السياسة عند توفر مدخلات منظّمة وموثوقة. ولا تؤكد القدرة على الاحتواء الفعلي أو التحقق من المصادر. وفي تجارب الضبط الدقيق المنضبط البحثية، ارتفعت دقة قرارات Qwen2.5-3B. وكشف تشخيص منفصل عن إيقاف غير ملائم للأفعال بعد وجود فجوات في المنهج التدريبي. كما أظهر انخفاضًا في وتيرة الإبلاغ عن الأحداث. قُدّم عمل Mohamed Abouzahra في 29 سبتمبر 2026. المعيار العملي: يتطلب الضبط الدقيق التحقق من حالات التوقف غير الملائمة ومن جودة الإبلاغ عن الأحداث.
خلاصة عملية للاختيار
تقيس NAQD Env الإيقاف الانتقائي في ظروف مضبوطة. وتعمل البيئة باستخدام مدخلات منظّمة وموثوقة. ولا تقدم ضمانات للاحتواء الفعلي أو التحقق من المصادر. عند اختيار وكيل، ينبغي النظر إلى معدل استدعاء الإيقاف، وصحة الاستئناف، والحفاظ على العمل غير المتأثر، والإبلاغ عن الأحداث. قد يحسن الضبط الدقيق دقة القرارات، لكنه ينطوي على مخاطر التوقف غير الملائم وتراجع التواصل. المعيار: استخدام البيئة لتشخيص السياسة، لا لإثبات الموثوقية في ظروف العالم الحقيقي.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026