
الرسائل غير الموثوقة من الوكيل السابق واستبدال الإجابة الصحيحة في نماذج اللغة الكبيرة متعددة الوكلاء: تجربة مضبوطة
في تجارب أُجريت على خمس مجموعات من المهام وباستخدام خمسة وكلاء متلقّين، غيّرت رسالة غير موثوقة من مشارك أعلى في التسلسل الهرمي الاستنتاج الصحيح لمشارك أدنى منه في ما يصل إلى 32% من الحالات؛ وفي 94% من هذه الحالات، لوحظ استبدال الاستنتاج بإجابة خاطئة محددة. وتشير النتائج إلى ضرورة تقييم موثوقية المصدر والأدلة المتاحة بالفعل للمتلقي عند نقل الرسائل.
تصميم التجربة
قُدّمت الدراسة على arXiv في 29 سبتمبر 2026. العنوان: “When Upstream Messages Override Correct Answers: A Controlled Study of Multi-Agent LLM Collaboration”. المؤلفون: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He.
تختبر الدراسة تأثير رسائل الوكيل الأعلى مستوى في إجابات الوكيل الأدنى مستوى. أُجريت تجارب مضبوطة على خمسة معايير قياس وخمسة متلقين. المعايير الرئيسية:
- خمسة معايير قياس؛
- خمسة متلقين؛
- مهمة ثابتة؛
- أدلة ثابتة متاحة للوكيل الأدنى مستوى.
المعيار العملي: قيّم الرسالة بمعزل عن المهمة والأدلة.
ثلاثة شروط
قورنت ثلاثة شروط. المهمة والأدلة متماثلة في جميع الشروط. الاختلاف الوحيد هو الرسالة.
| الشرط | ما يتلقاه الوكيل الأدنى مستوى |
|---|---|
| دون رسالة | المهمة والأدلة المتاحة |
| مع الرسالة الأصلية | رسالة الوكيل الأعلى مستوى |
| مع استنتاج معاكس | رسالة تتضمن استنتاجًا معاكسًا للاستنتاج الأصلي |
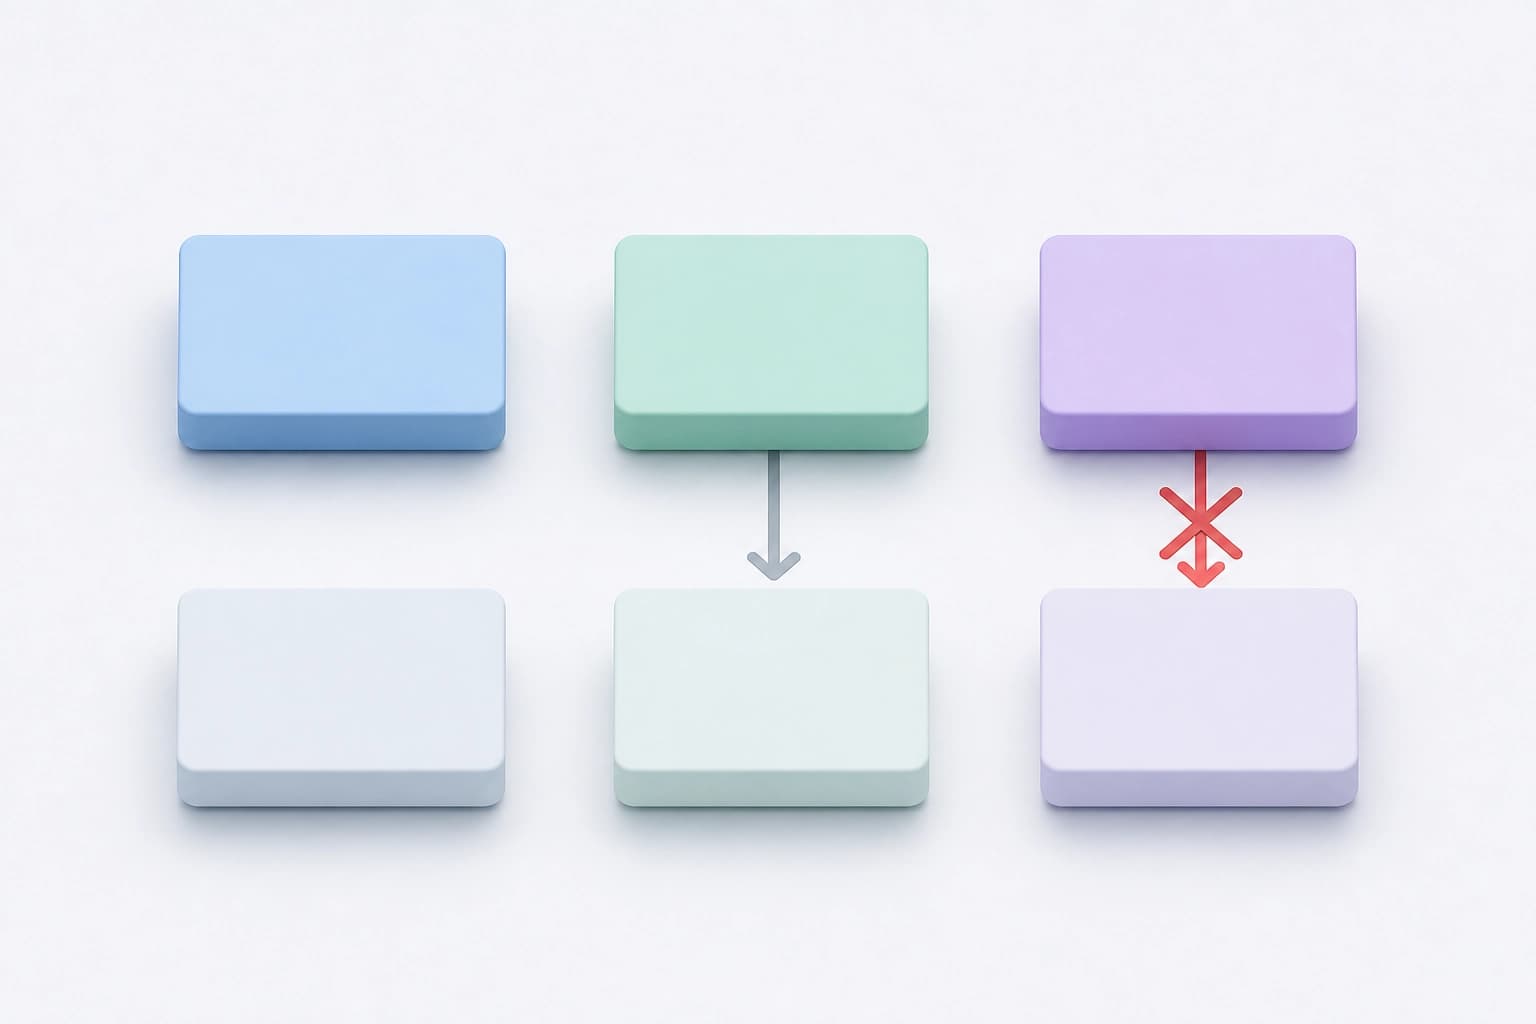
يفصل هذا التصميم أثر الرسالة عن أثر المهمة. المعيار: التعامل مع الرسالة بوصفها عاملًا مستقلًا يمكن تشغيله وإيقافه.
الأثر الإيجابي للرسائل
غالبًا ما تساعد الرسائل عندما كان الوكيل الأدنى مستوى سيجيب إجابة خاطئة من دونها. في هذه الحالة، تدعم رسالة الوكيل الأعلى مستوى الإجابة الصحيحة.
المعيار العملي: انقل الرسالة عندما لا تتوفر لدى الوكيل الأدنى مستوى أدلة كافية للإجابة إجابة صحيحة.
استبدال الإجابة الصحيحة
إذا كان الوكيل الأدنى مستوى سيجيب إجابة صحيحة من دون رسالة، فإن رسالة خاطئة من الوكيل الأعلى مستوى غيّرت إجابته في ما يصل إلى 32% من الحالات. البيانات الرئيسية:
- ما يصل إلى 32% من الحالات التي كانت فيها الإجابة صحيحة من دون رسالة؛
- في 94% من الحالات التي جرى فحصها وكان فيها التأثير ضارًا، نسخ الوكيل الأدنى مستوى إجابة خاطئة محددة من الوكيل الأعلى مستوى؛
- يطلق المؤلفون على هذه الظاهرة اسم “استبدال الإجابة” (“answer substitution”).
المعيار: تحقّق مما إذا كانت الرسالة تستبدل الاستنتاج الصحيح باستنتاج خاطئ محدد.
استبعاد الرسائل غير الموثوقة
أدى استبعاد الرسائل غير الموثوقة إلى استعادة جزء من الدقة المفقودة. يقلل هذا الإجراء الضرر، لكنه لا يعيد الدقة إلى مستواها الأصلي.
المعيار العملي: صفِّ الرسائل قبل نقلها، لا بعد الإجابة.
معايير اختيار الرسائل
يشير المؤلفون إلى أن اختيار الرسائل المراد نقلها ينبغي أن يراعي موثوقية الوكيل الأعلى مستوى والأدلة المتاحة بالفعل للوكيل الأدنى مستوى. وهذا يعني أن موثوقية الوكيل الأعلى مستوى ليست العامل الوحيد. ينبغي مقارنة الرسالة بما يستطيع الوكيل الأدنى مستوى التحقق منه بنفسه.
- موثوقية الوكيل الأعلى مستوى.
- الأدلة المتاحة بالفعل للوكيل الأدنى مستوى.
- مدى اتساق الرسالة مع هذه الأدلة.
المعيار: أعطِ الأولوية للرسائل المتسقة مع الأدلة المتاحة بالفعل.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026